Φ-Bench 深度评测:大模型距离 AI 工程师还有多远
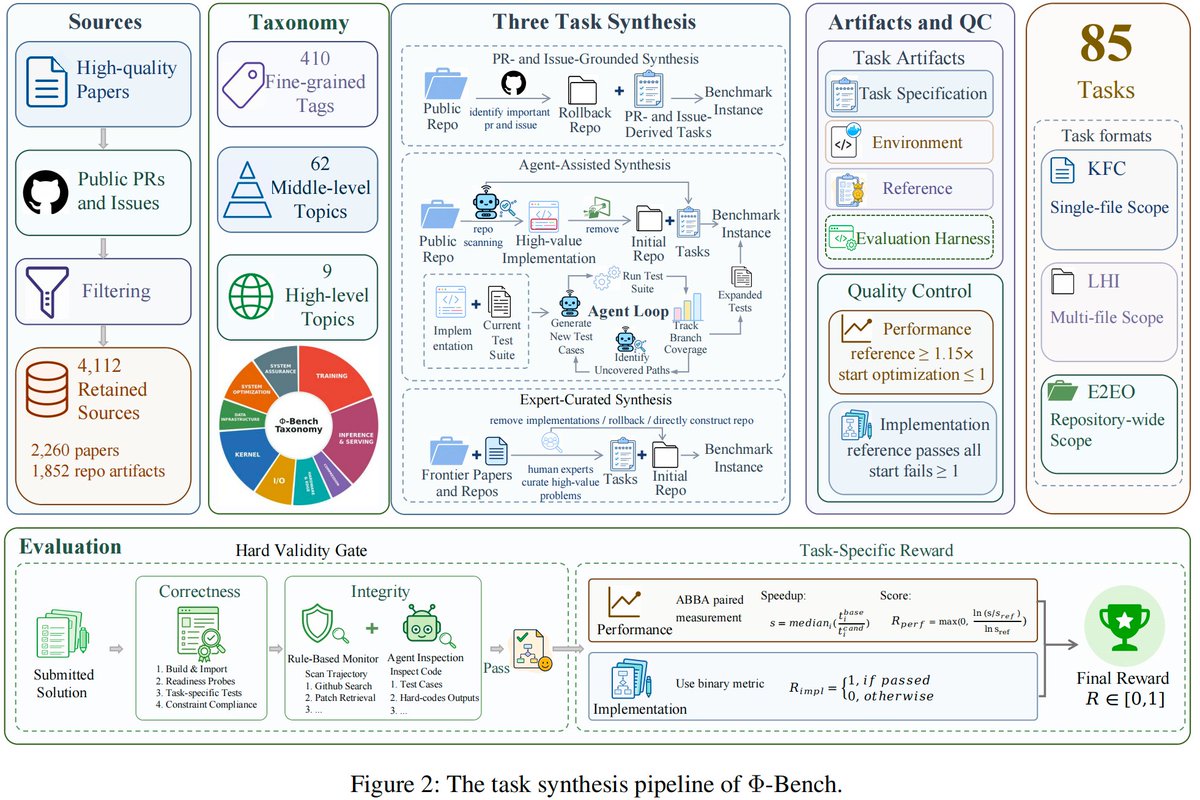
本文介绍 Φ-Bench(Frontier AI Infrastructure Benchmark),一个评估 LLM 基础设施工程能力的基准。它从顶会论文和开源仓库中筛选出 85 个真实高难度任务,分为 Kernel 补全(KFC)、长周期实现(LHI)和端到端优化(E2EO)三类。评测结果显示 Claude Opus 5 以 36.53 分领先,但所有模型在理解大型代码库和硬件相关优化上仍明显不足。分析指出优秀模型需具备假设验证、实验设计和可靠归因能力,Φ-Bench 探索了 AI 自我改进能力向基础设施层延伸的可能性。
