Wiki 知识库

技术 / 数据库

10 篇
清除

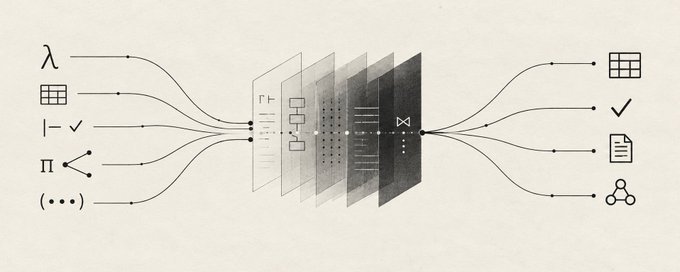
LeanDB: 用 Lean 构建强类型 SQL 前端

文章介绍了 Theoric Labs 的 LeanDB 实验,旨在将形式化方法与 AI 智能体结合应用于数据库领域:用 Lean 语言描述数据及其属性,同时使用 SQL 数据库进行存储和查询。文章通过咖啡菜单示例系统讲解了 Lean 的类型系统,包括归纳类型(如 Temperature、MenuItem)、细化类型(如限制浓缩咖啡份数为 1-4 的 ShotCount 子类型)、依赖类型(杯型大小依赖于冷热温度的 CupSize 索引族),以及元类型(FieldSpec 宇宙设计模式,用数据描述类型)。作者认为,强类型能让编译器在运行前阻止非法数据写入,将验证结果显式化,从而构建无 bug 的软件系统。
技术 › 数据库 Harsh Gupta 2026-09-1515.2 KB 30.8K 365 74

AI-Powered Data Warehouses: Architectural Lessons for Every AI Product

文章探讨了 Snowflake、Databricks、ClickHouse、BigQuery、MotherDuck 等数据仓库平台在 AI 时代的架构演进,总结了七大架构经验:推理正在成为数据库算子;数据转换可通过 LLM 推断并物化新事实;语义层正成为 Agent 的基础设施;Agent 的部署位置是重要的架构决策;数据仓库正成为 Agent 工作的执行环境;Agent 是一种新的数据库工作负载,其迭代、突发、高并发的访问模式要求重新设计数据库系统。这些模式为所有 AI 产品的架构设计提供了借鉴。

技术 › 数据库 Josh Rosen 2026-09-0310.2 KB 76.4K 239 76

Cloudflare D1 免费层开始硬性限额:一次规则落地如何改变小应用的数据库预算

Cloudflare 于 2026 年 9 月 1 日起对 Workers Free 账户的 D1 数据库实施每日硬性限额:行读取或行写入任一耗尽后查询直接报错,直到次日 UTC 00:00 重置。文章详解了 D1 按实际扫描/写入行数(而非 SQL 条数或返回行数)计量的核心机制,列举了无索引过滤、ORDER BY RANDOM()、前置通配符搜索等易触发限额的查询模式,并分析索引在节省读取与产生写放大之间的权衡。作者以自己站点为例梳理了排查与优化步骤,建议用量化监控、索引治理、缓存和降级设计应对免费层故障边界,或选择升级付费方案。

技术 › 数据库 2aRan_阿燃 2026-09-0221.8 KB 1.9K 2 87

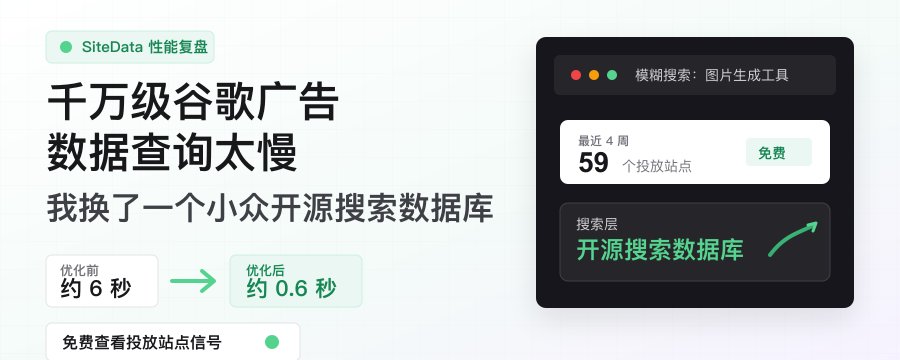
把千万级 Google Ads 标题的模糊查询从 6 秒压到 0.6 秒,我做了什么?

作者为 SiteData 工具做性能优化:千万级 Google Ads 广告标题的模糊查询原本用 MySQL 需约 6 秒,导致广告竞争信号功能只能手动触发。作者对比 Elasticsearch 与 Manticore Search 后,选择轻量的 Manticore 作为搜索层,MySQL 继续承担业务数据。迁移后查询压缩至约 0.6 秒,压测显示平均耗时 170-180ms、零错误,且资源占用极低(8GB 内存仅用 662MB)。文章总结了三点经验:慢功能可能是性能问题而非价值问题;主数据库不应包揽全部职责;小团队选型应以成本和务实为导向。

技术 › 数据库 饭特稀 | Fentix 2026-08-2712.2 KB 4.3K 8 76

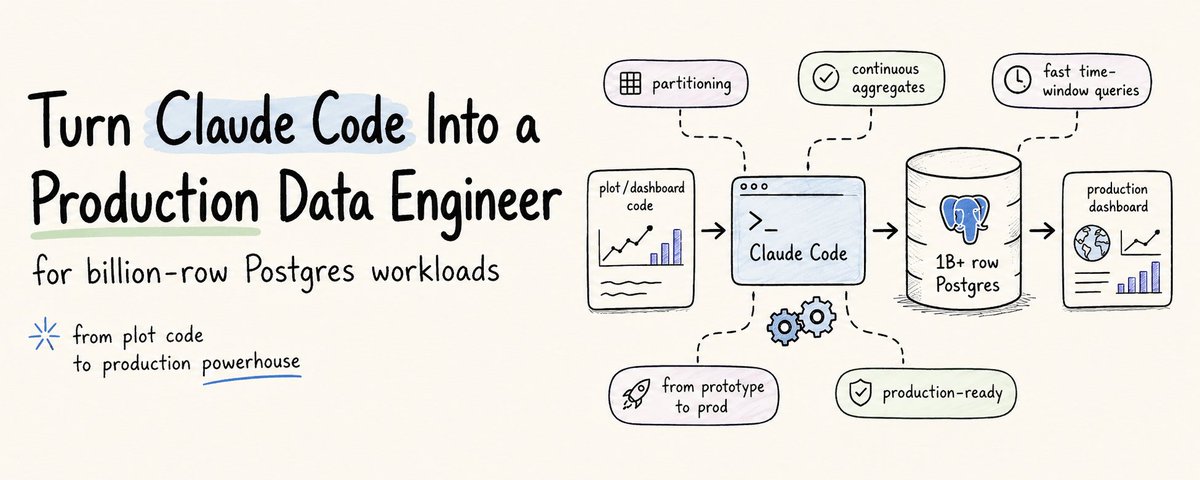
How To Turn Claude Code Into A Production Data Engineer On Billion-row Postgres Workloads

本文探讨了Postgres在处理数十亿行时间序列数据时遇到的性能瓶颈,以及如何通过Tiger Cloud(基于TimescaleDB的托管服务)解决这些问题。文章以Cloudflare团队的经历为例,展示了他们花费两年时间手动构建分区管理和聚合管道,最终迁移到TimescaleDB将查询速度提升35倍。作者演示了如何使用Tiger CLI作为MCP服务器,让Claude Code直接管理数据库基础设施,并构建了一个实时地震仪表盘。通过自动时间分区、连续聚合和压缩功能,Tiger Cloud简化了数据工程工作,使开发者能专注于应用开发。

技术 › 数据库 Avi Chawla 2026-08-129.1 KB 70.5K 49 71

Understanding HNSW: The Engine Behind Fast Vector Search

本文深入解析了HNSW(分层可导航小世界)算法,这是现代向量数据库实现快速近似最近邻搜索的核心技术。文章通过邮政分拣的比喻,阐述了HNSW如何结合NSW图结构和跳表的概念,利用分层结构从粗糙到精细地快速定位目标,并详细说明了向量搜索和插入的具体流程。

技术 › 数据库 achal 2026-07-3012.6 KB 5.3K 67

Introducing pgContext 0.2.0: Advanced AI search inside Postgres

pgContext 0.2.0 发布,作为 PostgreSQL 的开源扩展,提供更快的语义搜索、过滤和混合检索功能。新版本优化了性能,增加了搜索透明度和安全性,支持更多 AI 搜索方法,适用于推荐系统和低成本检索。用户可通过源代码、容器或 Docker Compose 使用。

技术 › 数据库 dale 2026-07-243.1 KB 10.6K 63

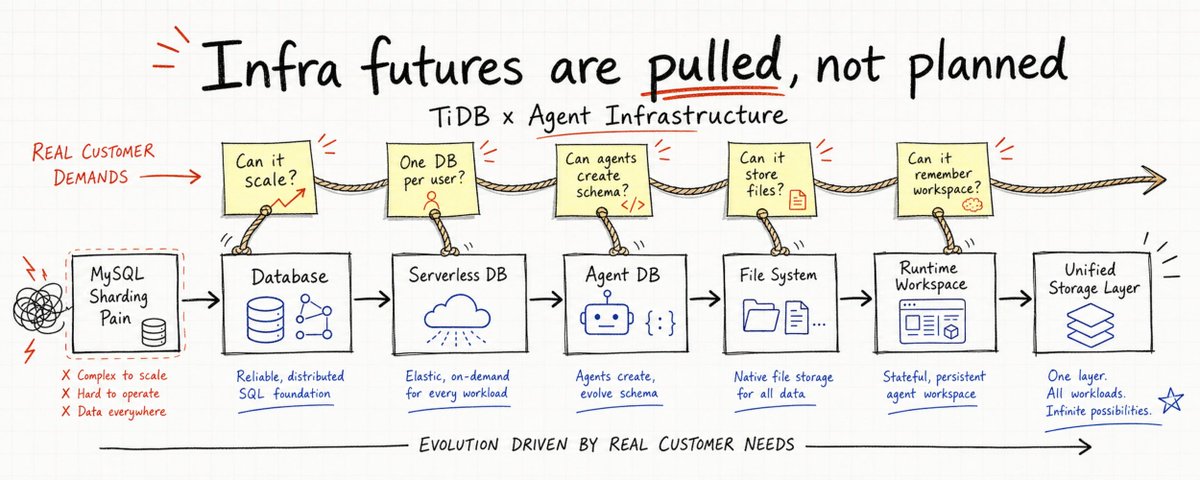
没人能规划 Infra 的未来:TiDB AI 演化之旅

文章讲述了 TiDB 从传统分布式数据库演变为面向 AI Agent 的统一存储层的过程。作者通过回顾从解决 MySQL 分库分表问题,到支持百万级数据库、文件系统、Agent Runtime Workspace,再到构建 Agent Stack 的六个阶段,阐述了基础设施产品如何被客户实际需求而非顶层设计推动演化,最终成为 AI 应用背后的关键基础设施。

技术 › 数据库 siddontang 2026-07-1515.2 KB 8.1K 50