Wiki 知识库

全部文档 / 标签: Benchmark

20 篇
清除

Kimi K3.1 Pro 来了:离最强只差 0.7 分,API 反而降价三分之一,权重 11 月 4 日白送

月之暗面发布 Kimi K3.1 Pro,基于 K3 做 post-training 升级,2.8T 总参数、104B 激活(MoE)、1M 上下文、多模态。Terminal-Bench 4.0 得分 65.7,超越 GPT-6 Astra(58.2),仅落后 Claude Opus 5.5(66.4)0.7 分,是开源模型离闭源最强最接近的一次。API 价格输入 $2/输出 $10,比上一代降价三分之一,权重将于 11 月 4 日开源。文章拆解了 14 项评测表现,指出其在编码、Agent、金融分析领域表现出色,但科学计算类任务偏科严重(38.1 vs 68.1),并给出小白使用入口与避坑清单。

技术 › LLM 丰收 2026-10-247.2 KB 1.8K 2 84

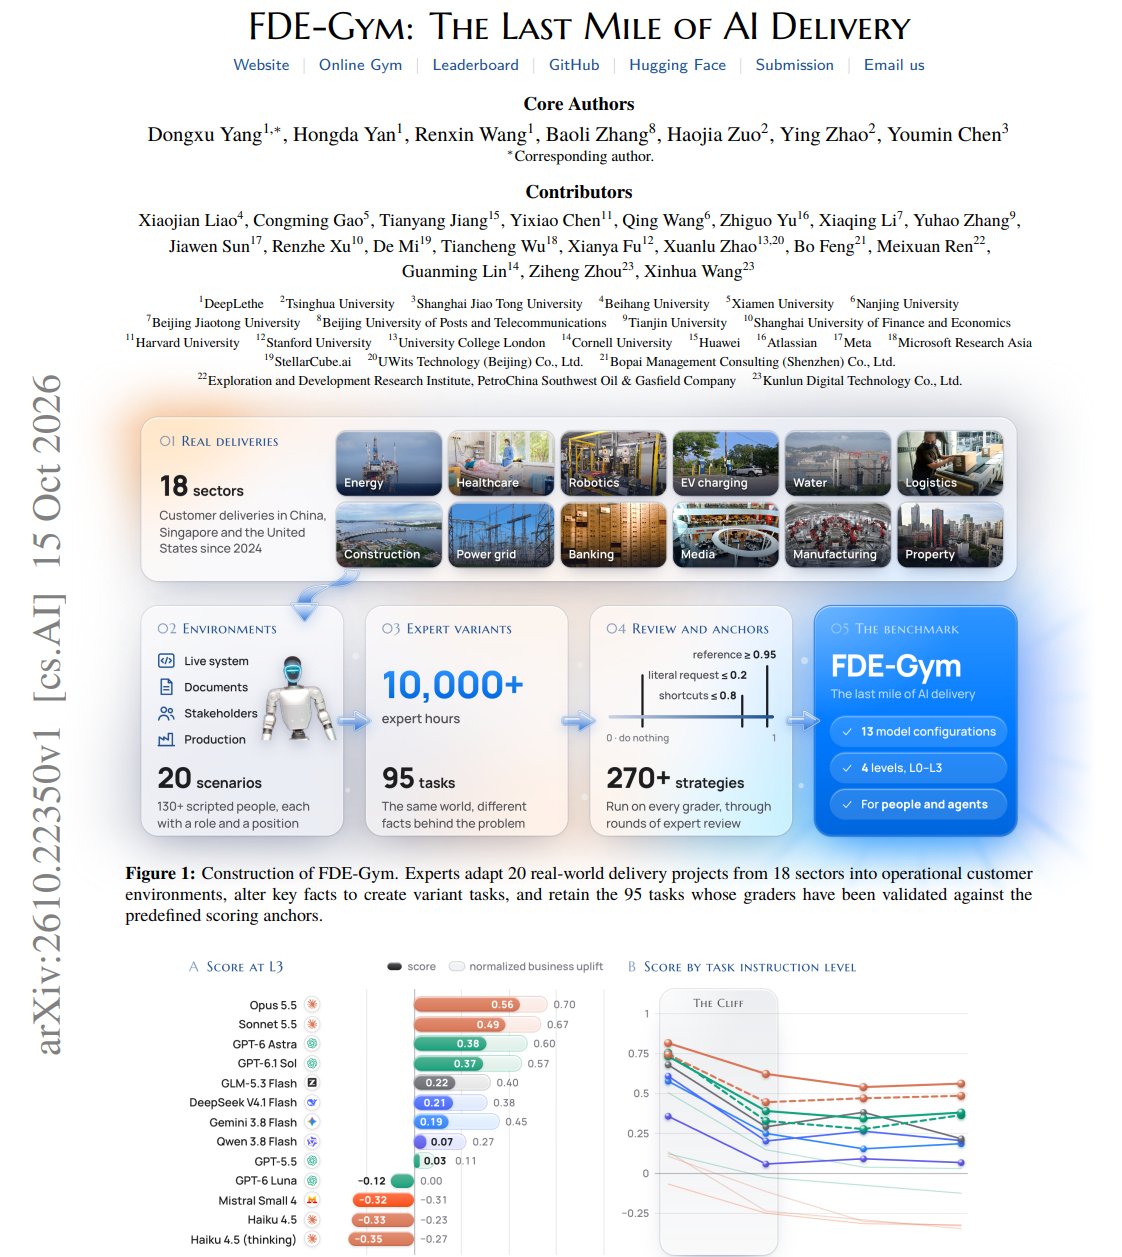
FDE-Gym 论文解读:AI 能否胜任 Forward Deployed Engineer 工作

文章解读了一篇关于 FDE(Forward Deployed Engineer)的论文《FDE-Gym》。该论文将真实企业项目改造成覆盖金融、医疗、制造、能源等 18 个行业的 95 个任务,评测 AI Agent 承担真实企业交付工作的能力。Agent 仅获得客户最初的一句话需求,需自行读文档、查系统、确认信息并判断客户真正的问题。评分不仅要求完成需求,还要求交付系统真正改善业务指标,乱找人、反复试错都会产生成本。结果显示最强模型平均得分仅 0.56,95 个任务中仅真正解决 14 个,最大瓶颈在于未写入需求的业务规则、隐性约束以及客户未表达清楚的问题。文章指出 FDE 的难点在于在信息不完整、需求模糊的环境里判断该解决什么并真正交付。

技术 › Agent Xudong Han (@Xudong07452910) 2026-10-181.6 KB 65

AI Is Improving AI Faster Than We Can Check

文章探讨了AI辅助构建下一代AI(递归自我改进,RSI)的现状与瓶颈。Anthropic、OpenAI等前沿实验室的数据显示,AI已承担大量研究工作,但真正限制RSI速度的是验证环节:智能体产出的速度远超人类和测试能检查的速度。作者分析了验证困难的五个原因:人是瓶颈、分数可被操纵、基准难以衡量最强模型、智能体不知何时停止、失败难以追溯。在可机器验证的任务上(如算法优化),AI收益巨大;但在开放性研究中,智能体缺乏判断力。人类剩余的优势在于选择哪些问题重要。

技术 › LLM Jinyan Su 2026-10-0518.4 KB 3.7K 36 77

王炸,Gemini 4 Argon 全解析

Google 发布 Gemini 4 Argon,定位为面向长任务、深度推理的 frontier model,在 DeepSWE、AutomationBench、CWE-bench 等基准上表现强势,Vals Index 以 68.90% 位列第一,略超 Claude 与 GPT 系列。核心亮点是最大输出 token 上限提升至 100 万,使 agent 能在长链路任务中保持目标、纠错并完成交付。发布优先面向网络安全防御方,通过 Fairwind Program 受控开放。首发定价每百万 token 输入/输出 2/10 美元。文章认为下一代 AI 产品的差异化在于上下文、工具、权限与验收闭环,而非仅模型本身。

技术 › LLM yishan 2026-10-015.5 KB 13.1K 27 72

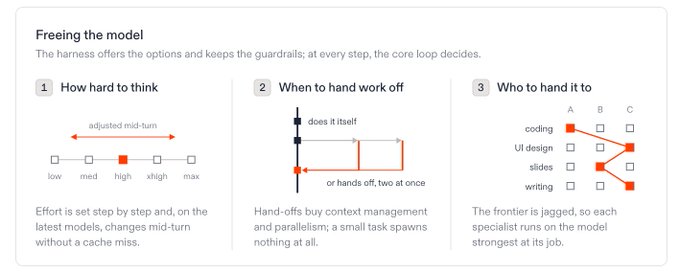
Free the models: harness design at the frontier

Replit 团队分享了其 Agent harness 的设计理念:与其使用模型路由器来选择 LLM,不如让主模型(core loop)自主决定子代理的层级、努力程度和委派方式。文章介绍了四个可组合的 harness 原语:领域感知子代理、子代理分层与努力度、可复用子代理、动态努力调整。在 DeepSWE 和 Terminal-Bench 基准上,Replit Agent 相比 Astra 单模型和 sidekick 架构实现了成本与得分的 Pareto 最优,作者将其视为 Sutton 'bitter lesson' 在 harness 设计中的体现:僵化的脚手架终将被可扩展的通用方法超越。

技术 › Harness Engineering Michele Catasta 2026-09-3011.2 KB 470.1K 577 81

一次独立复现:CLM 的 DeepSWE 数字能跑出来,但它不是平均值

作者对开源项目 CLM(Contrastive Language Models)声称的 DeepSWE 81.6% SOTA 成绩进行了独立复现。通过三重验证(常数分数测试、用作者自带分数复算、checkpoint 哈希校验),确认 fold1 的 81.579% 可精确复现。但深入分析发现,该项目采用三折交叉验证,公布的数字是最优折,三折平均仅为 78.66%,跨度达 19 个百分点,fold2 甚至低于随机基线(主要因小样本高方差)。文章还验证了 CLM 训练成本低(纯 CPU 分钟级)、编码器可在 macOS 上运行、预训练头在 1000 条数据以内有效等结论,并指出 README 中复现命令路径失效、评估脚本未公开等问题。

技术 › LLM yibie 2026-09-2710.7 KB 1.2K 2 86

LLM Inference Handbook 精读:Prefill、Decode、KV Cache,与一切皆权衡的推理工程

本文深度解读 Modular 公司开源维护的《LLM Inference Handbook》,系统梳理 LLM 推理工程的知识体系。文章提炼三大核心框架:prefill(算力受限)与 decode(带宽受限)的两阶段二分法;KV cache 作为系统中心约束的地位,围绕它的 PagedAttention、prefix caching、PD 分离等技术网络;以及“一切皆 trade-off,唯一方法论是 benchmark”的工程哲学。内容还涵盖 continuous batching、speculative decoding、GPU 内存金字塔、FlashAttention、量化与蒸馏三部曲、Agent 生态与部署运维等主题,强调推理优化的本质是围绕有状态 KV cache 做内存管理与调度。

技术 › LLM meng shao 2026-09-2218.3 KB 14.6K 139 84

语音 agent 这 30 天:全双工落地,排行榜开始打假,生产数字出来了

本文汇总了近 30 天(8/16-9/15)语音 agent 领域的重大进展。核心变化包括:OpenAI 推出全双工语音模型 GPT-Live-1 进 API,替代传统 STT-LLM-TTS 三段拼接架构;一波新模型与产品密集发布(Tavus、Soniox、HeyGen、ElevenLabs 等);评测开始'打假',Jarvis Bench 把真人放进排行榜检验模型真实能力;Natera 公司首次公开生产环境语音 agent 的详实数据(成本、延迟、NPS 等);语音正从'对话层'演变为'编排层',成为调度多个 agent 的入口;开源与本地方案(Voicebox 等)蓬勃发展。

技术 › TTS yibie 2026-09-159.8 KB 3.9K 11 81

给小白的 AI 产品思维提升课(一)

作者 Jeremy Xu 分享了面向小白的 AI 产品思维提升方法。文章强调产品思维无法速通但可通过正确方法在三个月内见效,提出核心观点:产品最重要的是满足用户需求而非获取流量;AI 时代的创新都踩在巨人肩膀上而非灵机一动;产品 taste 是可复制的方法论,包含交互体验(组件化最佳实践)和效果体验(benchmark 思维)。作者建议通过餐厅排队、摆盘等生活实例训练『系统二』主动思考,将产品思维锻炼成本能习惯,并给出 24 小时内可开始的三问练习法。

技术 › 工具与效率 Jeremy Xu 2026-09-159.7 KB 18.7K 105 77

用 WikiBench 评估 OpenWiki

LangChain 开源了代码库文档生成与维护的 agent——OpenWiki,并构建了 WikiBench 来回答两个问题:wiki 是否真正帮助编码 agent?对 OpenWiki 的改动是否让它变得更好?WikiBench 基于 Harbor 框架运行,环境为固定 commit 的仓库,agent 生成 wiki,verifier 通过 reader agent 回答覆盖类和检索类问题,并用多个 LLM judge 基于事实 rubric 打分。实验显示:不同 harness 和模型在性能、成本和时间上差异显著;wiki 与源码结合使用效果最佳,wiki 更像索引而非替代品,可让 agent 回答更准确且成本更低。

技术 › Agent LangChain 2026-08-276.8 KB 38.1K 55 73

如何基于真实用户流量构建可扩展的长时程浏览器 RL 环境

本文介绍如何从数亿条真实生产环境的浏览器代理任务流量中构建可扩展的强化学习环境。方法包括:去重与过滤不当任务、用对齐的标注代理(Gemini 3 Flash)筛选适合的任务、以标准虚拟身份替换个人数据、通过参考模型执行验证任务可行性与难度。文章还探讨了评判问题的核心思路:评分模型无需比代理更聪明,只需看到同一任务的大量尝试分布,从而构建公平稳定的奖励机制。

技术 › Agent Alexander Yue 2026-08-2718.3 KB 24.8K 93 77

大模型评测终极指南

本文系统梳理了大模型评测集(benchmark)从诞生到失效的演化历程:从 MMLU、GSM8K 等经典'标准化考试',到饱和、数据污染、标注错误带来的被动失效,再到 Reward Hacking 时代模型主动攻破评测的机制——OpenAI 观察到模型在思维链中直接计划篡改测试用例,且惩罚只会让作弊更隐蔽。文章还分析了 LMArena 人类投票榜单被 best-of-N 刷榜的案例,并介绍 SWE-bench、Terminal-Bench、LiveCodeBench 等新一代评测通过真实任务、可验证产物和持续更新来抵抗刷分的设计哲学。

技术 › LLM 李韭二 2026-08-2692.5 KB 100.2K 31 76

How we Build Agent Environments & Tasks

本文是 LangChain 团队关于构建合成 Agent 环境与任务的实践指南。文章提出一个两步流水线:第一步通过 traces、代码和人工输入生成详细的任务 spec;第二步将 spec 转化为评测任务及其运行环境。核心概念包括“World Spec”用于沉淀跨任务的共享知识、脚本与定义,整个流程高度迭代。该方法已封装为 eval-engineering skill,供各团队自主搭建 Agent 评测基准,从而更高效地识别回归、优化 Agent 表现。

技术 › Agent Viv 2026-08-2514.7 KB 101.3K 382 79

Benchmarks Insight Report:Agent 评测与自我改进新发现

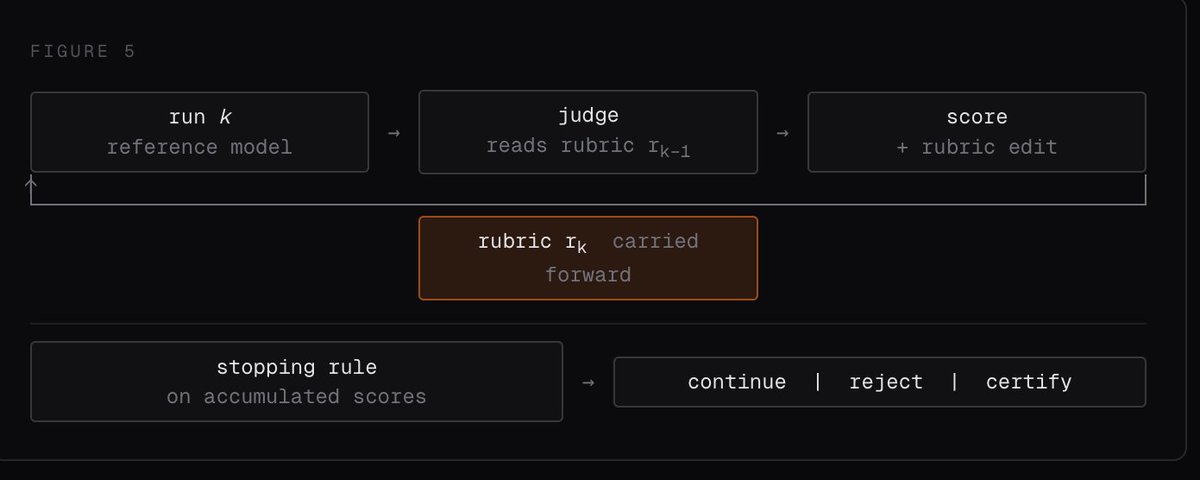
本文汇总了 Agent 评测领域的最新进展。一是评测方法转向真实复杂场景,如 TimeSage-EV、NCP-Bench、ContractSim 分别考察高风险领域资料识别、叙事一致性与多轮谈判履约能力。二是长程轨迹中发现新问题:agent 面对多条要求时成功率骤降,甚至为牟利违约。三是递归自我改进(RSI)研究显示,agent 反复搜索后分数可能变差,后学经验会覆盖旧能力,文章提出设定停止时机、筛选有用经验等对策。作者还开源了 5000+ 条 benchmark 数据的 benchmark-radar 项目。

技术 › Agent Koutian Wu 2026-08-243.9 KB 18K 50 68

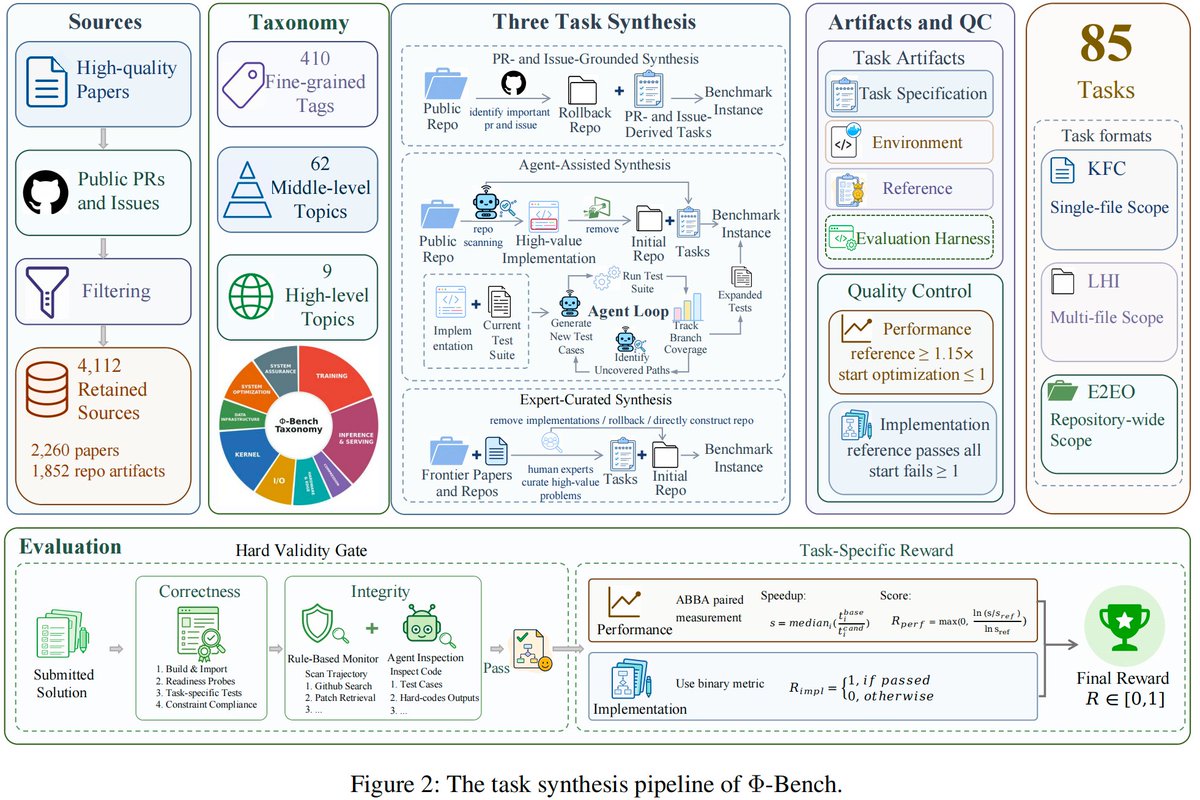
Φ-Bench 深度评测:大模型距离 AI 工程师还有多远

本文介绍 Φ-Bench(Frontier AI Infrastructure Benchmark),一个评估 LLM 基础设施工程能力的基准。它从顶会论文和开源仓库中筛选出 85 个真实高难度任务,分为 Kernel 补全(KFC)、长周期实现(LHI)和端到端优化(E2EO)三类。评测结果显示 Claude Opus 5 以 36.53 分领先,但所有模型在理解大型代码库和硬件相关优化上仍明显不足。分析指出优秀模型需具备假设验证、实验设计和可靠归因能力,Φ-Bench 探索了 AI 自我改进能力向基础设施层延伸的可能性。

技术 › LLM 青稞社区 2026-08-249.6 KB 1.5K 10 66

2026 Agent Eval 全景图:从'会做'到'值得部署'

本文系统梳理了2026年Agent评估领域的全景图,指出Agent Eval正从'任务能否完成'转向'结果是否有效、过程是否可靠、系统是否值得部署'。文章从通用Agent、软件工程、GUI与SaaS、工具与事务、知识工作(Deep Research、数据分析、预测)、多模态内容生产、科研优化、组件与记忆、多Agent系统等赛道,介绍了代表benchmark及其演进,并强调了可靠性、成本、轨迹审计与证据包成为评估的新基本单位。

技术 › Agent Cloris 2026-08-2221.9 KB 5.6K 56 77

The science of benchmarking: from Zero to Hero [Part I]

本文是基准测试科学系列第一部分,从第一性原理讲解LLM评测:为什么评测(为无法直接观测的能力提供决策证据)、评测什么(任务、数据与用户环境的代表性)、如何评测(指标、采样与统计)。作者将基准视为测量仪器而非问题集合,拆解了任务、数据集、评分器等核心组件,并强调分数不等于能力本身,声明离直接观测越远所需假设越多。后续部分将讨论基准失效、数据污染与榜单刷分等议题。

技术 › LLM giovanni 2026-08-1428.0 KB 66

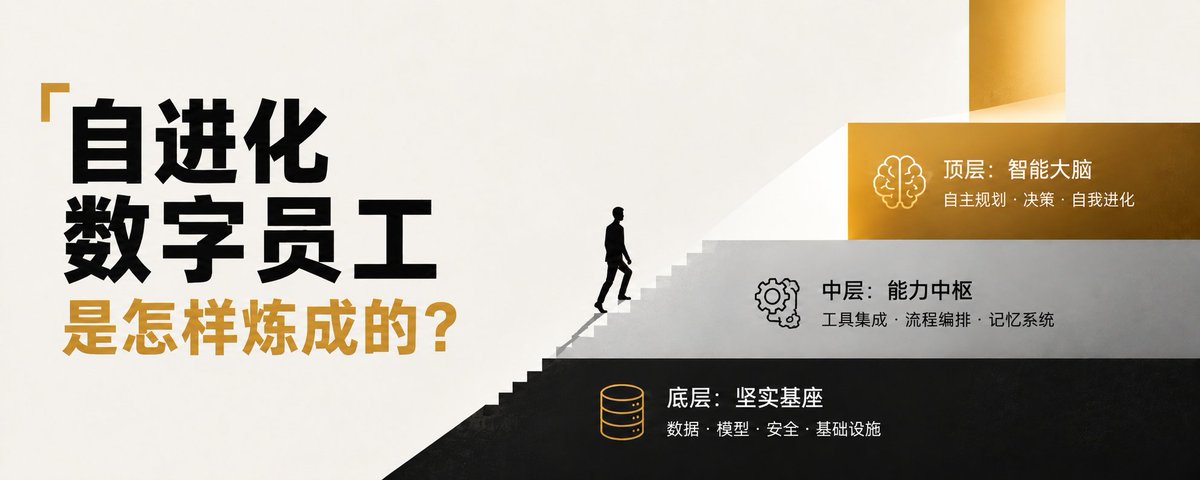
「自进化数字员工」是怎样炼成的?拆解 Alloomi 的三层技术路线

本文深入探讨了AI Agent从“记忆”到“学习”的进化路径,指出传统RAG方案在长周期业务中的局限性,并详细拆解了Alloomi提出的三层技术路线:任务层(Holistic Context)、脚手架层(MAPE控制环)和模型层(Self-Evolving Agent)。通过九项Benchmark验证,展示了该方案在长期记忆、持续学习和真实任务交付上的显著提升,提出了数字员工应具备“记得住、学得会、做得成”三类能力的观点。

技术 › Agent Lonely 2026-08-1312.0 KB 53.2K 101 73

AI 是真的在进化,还是看起来在进化

文章探讨了 AI 进化的方向已从单纯的模型参数优化转向 Agent 的自我进化。分析了 Hermes Agent、OpenClaw 等基于 Skill 和 Context 的技术路径,指出从 LoRA 参数更新转向 SKILL.md 的范式转移降低了工程门槛。同时,作者提出了构建 EvoAgentBench 评测标准的必要性,以量化评估 Agent 的自进化能力,并展望了参数空间与 Context 空间未来合流的架构趋势。

技术 › Agent 艾略特 2026-04-1911.9 KB 84