Wiki 知识库

全部文档 / 标签: 口型同步

2 篇
清除

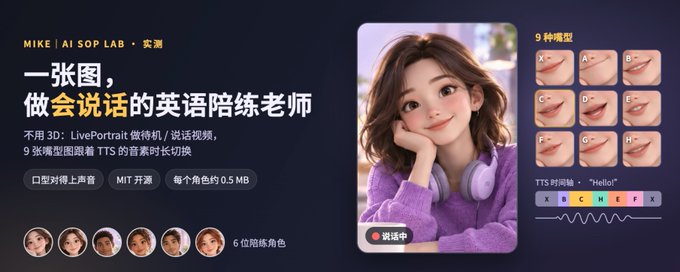
9 张嘴型图,让数字人跟着 TTS 说话

本文介绍了一种轻量级数字人口型同步方案:作者为英语陪练 App 制作了 6 个虚拟老师,每个角色仅需一张图片加约 0.5MB 素材,无需 GPU。核心是利用 Kokoro TTS 合成语音时天然携带的音素时长信息,将 44 个英语音素按视觉相似度合并为 9 种嘴型(viseme),生成时间轴通过响应头传递给前端。文章详细讲解了音素与视位的映射、音量修正停顿、LivePortrait 生成待机视频和嘴型图、以及 canvas 统一渲染等技术细节,实测嘴型偏差中位数约 0.1 秒,60 帧不掉帧。

技术 › TTS Z.He 2026-10-1818.0 KB 5.8K 38 91

做数字人最容易犯的错是去找一个一体化工具

本文指出做数字人视频时,一体化工具并非最佳选择,因为一条数字人口播视频包含形象、声音、口型、内容、环境五个独立位置。作者通过自身实践,对比了本地链路(手机拍摄、Qwen TTS、MuseTalk)与云端方案(Seedance 音画同出)的优劣,强调本地链路可控但效果受限,云端方案效果佳但难以精确控制。文章提出应根据需求选择方案,并建议将定妆卡沉淀为主播库、收藏夹沉淀为选题库,以实现复利积累。