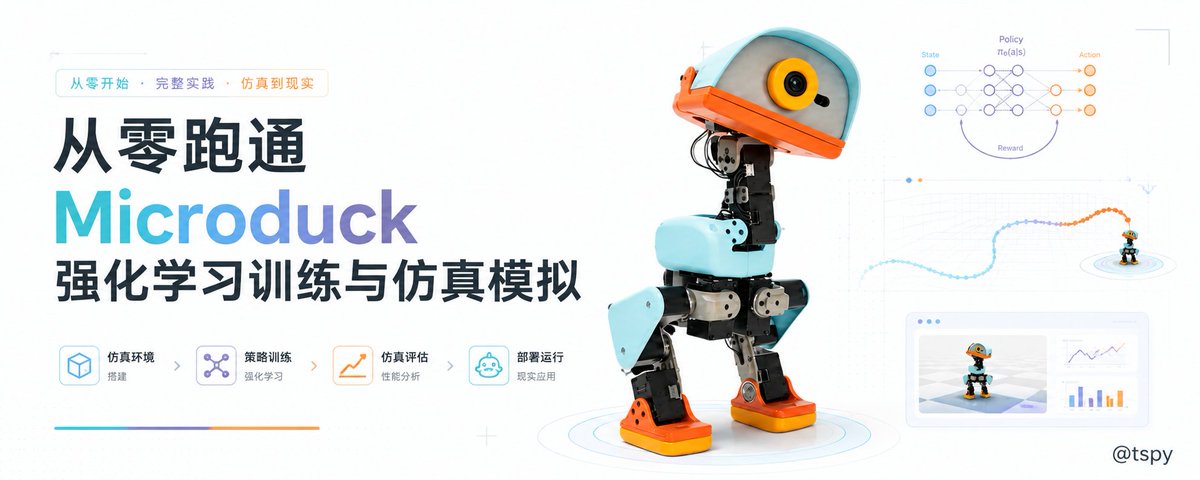
从零跑通 Microduck 强化学习训练与仿真模拟
本文详细介绍了如何从零完成 Microduck 双足机器人的强化学习训练与仿真全流程。文章使用 MuJoCo 物理引擎配合 Warp 在 RTX 4090 上并行运行 4096 个虚拟环境,通过 PPO 算法训练行走策略,并讲解了 61 维观测、奖励设计、域随机化、BAM 执行器仿真等核心概念。训练完成后将策略导出为 ONNX 文件,在 Mac mini 上进行 CPU 交互仿真验证,最终部署到实机。作者完整跑通了从环境配置、训练观察、checkpoint 选择到场景测试的工程流程,涵盖技术选型、软硬件要求和常见问题。