用 Codex 和 Skill 搭建自动化跨境 VOC 数据分析生产线
本文总结了十年数据分析经验,将其打包成4个 VOC Skill,利用 Codex 自动跑通从多平台评论抓取、清洗打标、统计分析到生成报告的全流程。文章详细介绍了如何通过构建多级标签体系将文本转化为可计算的指标,并分享了数据抓取、AI 打标抽查、Python 统计防错等实操技巧。该方法有效解决了 VOC 分析难以复用的痛点,可广泛应用于各类非结构化文本的处理与业务决策。
本文总结了十年数据分析经验,将其打包成4个 VOC Skill,利用 Codex 自动跑通从多平台评论抓取、清洗打标、统计分析到生成报告的全流程。文章详细介绍了如何通过构建多级标签体系将文本转化为可计算的指标,并分享了数据抓取、AI 打标抽查、Python 统计防错等实操技巧。该方法有效解决了 VOC 分析难以复用的痛点,可广泛应用于各类非结构化文本的处理与业务决策。
文章探讨了如何利用 Codex 的元技能将 n8n 工作流转化为可复用的 Skill,降低自动化门槛。作者通过 SEO 审计和 GEO 内容生成的实战案例,展示了 Codex 在解析、反问及泛化能力上的优势,同时也对比了 n8n 在确定性和集成方面的强项。
文章分析了 Claude Code 源码泄漏事件,指出其核心价值在于揭示了 51 万行 Harness Engineering 代码背后的工程设计,而非模型本身。作者详细拆解了六个关键工程决策(如上下文压缩、多 Agent 协调等),并重点梳理了泄漏后 24 小时内涌现的开源生态,包括洁净室重写、教学项目及各类插件工具,最后总结了 Agent 开发应从“调 prompt”转向“工程化”的核心理念。
本文详细复盘了作者利用AI视频(Sora、Veo等)在TikTok进行带货的实战经历。起初通过简单三步法快速出单,随后因死磕产品一致性、选错昂贵模型及盲目做IP号而亏损十几万。最终总结出一套“逆向拆解+参数化生产”的SOP方法论,强调在AI生产成本趋近于零的时代,核心壁垒在于脚本创作力和系统化的数据资产,而非单纯的工具或产量。
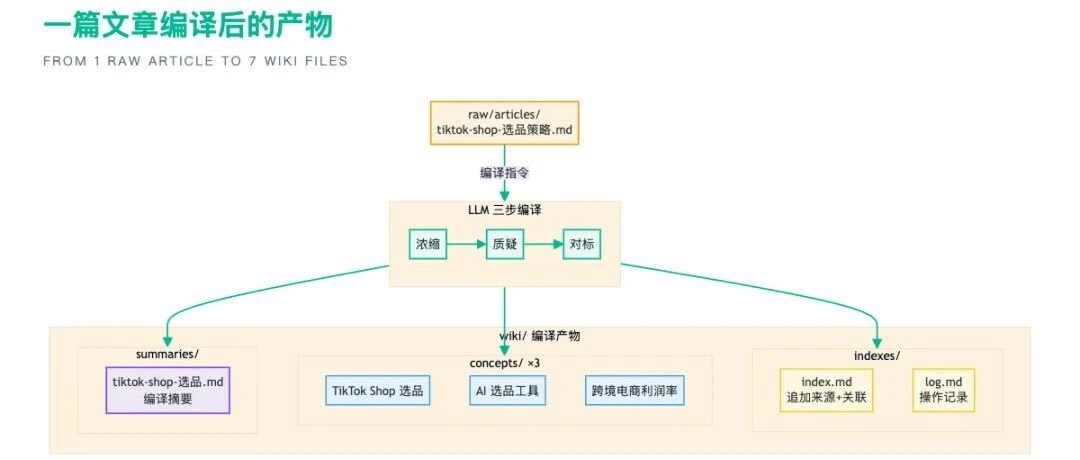
文章介绍了一套基于LLM Wiki方法论的内容生产3.0系统,解决了2.0版本中知识库信息垃圾化的问题。通过“三步编译法”(浓缩、质疑、对标)将原始文档编译为持久化Wiki结构,实现知识资产的自动积累与进化,大幅降低维护成本并提升了内容创作与知识管理的效率。