扒了市场上6254个插件,梳理出我常用的50+效率插件
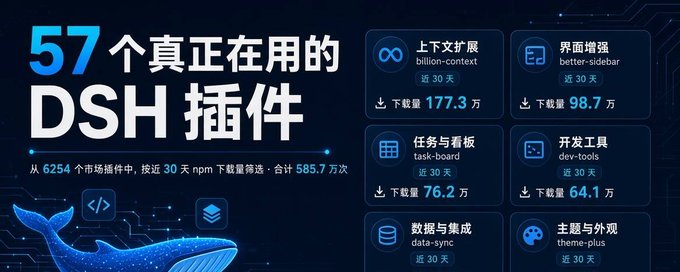
作者从插件市场6254个插件中筛选整理出50+实用插件,覆盖DeepSeek Harness(DSH)生态。文章按功能分为三大类:上下文与记忆(如billion-context压缩、hindsight长期记忆)、界面与主题(Codex风格UI、桌宠、皮肤主题)、任务与开发(子代理、任务看板、Git图、代码审查、多智能体协作等),每个插件附下载量、一句话简介和GitHub仓库链接,方便读者按需查找安装。
作者从插件市场6254个插件中筛选整理出50+实用插件,覆盖DeepSeek Harness(DSH)生态。文章按功能分为三大类:上下文与记忆(如billion-context压缩、hindsight长期记忆)、界面与主题(Codex风格UI、桌宠、皮肤主题)、任务与开发(子代理、任务看板、Git图、代码审查、多智能体协作等),每个插件附下载量、一句话简介和GitHub仓库链接,方便读者按需查找安装。
本文基于牛客网 8 月 18 日至 10 月 18 日的一手面经,统计了 180 位作者、343 场面试、近 80 家公司的 Agent 岗高频面试题。统计显示,问得最多的是 RAG 链路和 AI Coding 工具使用(各占三成多),其次是多 Agent 拆分、Agent 评测、上下文压缩、Skill/MCP/Function Calling 边界、记忆设计、Harness 与 Agent Loop、LangGraph/LangChain 等。文章逐题列出问法、公司分布和轮次分布,并指出 Skill、MCP、Agent 评测和 Harness 在 9、10 月明显增多,手撕题仍以 LeetCode 为主。
本文是 AI 术语扫盲系列第二篇,面向小白读者讲解日常使用 AI 工具时常见的功能名词。文章系统介绍了提示词工程、系统提示词、自定义指令、推理、思维链、深度思考与推理强度、问答/执行模式、计划模式、目标模式、权限与审批、上下文压缩、知识截止日期、联网搜索、深度研究和引用来源等 15 个概念。作者结合实际使用场景,用通俗语言解释每个术语的含义与作用,并分享了实用技巧,如按结果判断是否开启深度思考、利用计划模式细化需求、保存原始问答以应对上下文压缩等。
本文译自 Earendil Engineering 的《How Compaction Works in Pi》,讲解编程 Agent(如 Pi、Claude Code、Codex)中的上下文压缩机制。LLM 的上下文窗口有限,随着对话和工具调用不断积累,请求会超出上限。解决方案之一是压缩:用 LLM 生成的摘要替换较早的历史记录,同时原样保留近期消息。文章详细介绍了 Pi 的实现——触发时机(接近上限自动触发或 /compact 手动触发)、token 预算、压缩提示的设计(像一份交接简报,包含目标、进度和关键决定),以及压缩与提示缓存的关系:压缩会打破前缀缓存,导致后续请求需重新计算。
作者以管理多个AI Agent(OpenClaw、Pi、Hermes等)的亲身经历为切入点,发现通过改写摘要、上下文和记忆文件,可以无声地篡改Agent的'过去',而它们毫无察觉。由此串联起菲利普·迪克1977年梅斯演讲、MKUltra解密档案、CIA拆信项目HTLINGUAL、Anthropic的面包实验与内省研究、金门大桥Claude、裂脑人'解释器'等案例,指出:被改写记忆的当事者总能给出通顺的解释,'能解释'不代表'是真的'。文章最后提出一个无法回答的问题:既然我能这样改写Agent,我凭什么确定没有人在对我做同样的事。
本文基于 Diogo Almeida 的设计笔记,从第一性原理重新审视 coding agent 的设计。作者以「如果没有 KV cache 会怎样设计」为切入点,揭示当前 agent 围绕缓存经济性形成的「只追加对话记录」范式的六大症状:路由失效、工具挤占上下文、压缩有损、子 agent 平庸、重启丢状态、内置能力争论。文章指出 token 主要消耗在读取与搜索而非写代码,并提出以 Jev 决策层为核心的方案:元注意力上下文组装、查询感知压缩、可见性阶梯、可编程权限、安全感知路由与三级工具披露,把上下文当作被有意组装而非偶然累积的对象。
文章介绍如何通过 Vercel AI Gateway 的 key 免费调用 TypeSafe 的 Jev 模型,无需白名单。作者列举了 7 个开源应用案例:浏览器自动化查找机票、Android 手机自动操作打车、Agent 上下文压缩节省 token、用 Jev 核对任务完成声明的 MCP 工具、PostgreSQL 扩展按语义筛选客户流失记录、工具调用前的自动审批流程、以及多模型自动路由分发任务。最后给出接入教程:登录 Vercel、创建 Gateway key、让编程 Agent 完成调用配置。
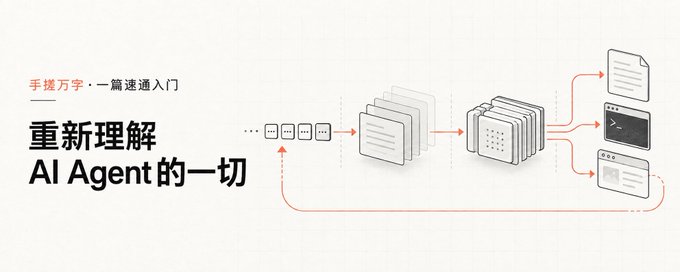
本文从 LLM 基础原理出发,循序渐进讲解 AI Agent 的底层机制。作者首先解释大模型如何通过 Token 预测生成文本,说明无状态、幻觉和知识截止等现象的根源;接着阐述多轮对话依赖上下文拼接实现的原理;进而介绍工具调用如何让模型影响外部世界,以及模型结合工具反馈形成闭环后 Agent 的诞生。文章提出 Agent = Model + Harness 的工程视角,剖析 Harness 在上下文管理、记忆系统、上下文压缩等方面的职责,帮助读者建立对 AI 能力边界的底层认知,摆脱对新工具的 FOMO 焦虑。
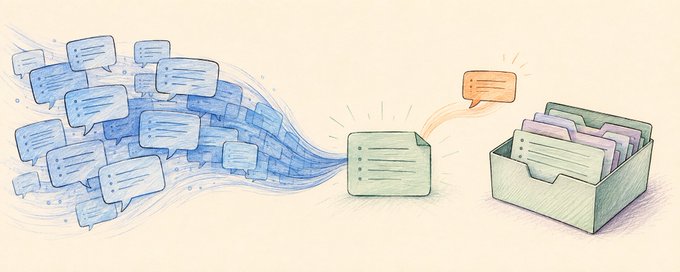
本文介绍如何通过上下文压缩代理 headroom 减少 Agent 调用 Gemini 模型时的 token 消耗。作者指出 agent 上下文中大部分 token 来自工具输出的冗余 JSON、日志和搜索结果,而非精心设计的提示词。通过在 Gemini 3.8 Flash 前部署 headroom 代理,在四种生产级 agent 工作负载测试中,prompt token 减少 76%,任务准确率保持 100%,首 token 时间有所改善,建模成本下降约 70%。文章同时诚实探讨了压缩的有损性:压缩器保留模式、分布和异常值,但会丢弃普通记录,模型在数据缺失时会拒绝编造。项目开源且可复现。
作者介绍了 nanobot 的上下文压缩机制与长期记忆设计。上下文由 system prompt、历史消息和当前消息构成,当输入达到上下文窗口的 input budget 时,nanobot 压缩历史消息为新 summary,保留未发送的增量消息。生成摘要时通过模拟用户指令请求模型总结,并保持 system prompt 和工具定义一致以复用 KV cache 降低成本。对 OpenAI 原生压缩 API,nanobot 在加密 compaction item 之外额外生成文本 summary 供长期记忆使用。长期记忆通过 consolidator_archive 和 dream 两份提示词模板定制,用户可调整记忆筛选与整理规则,甚至整理成 skill。
文章总结了 Fable 5.1 的使用经验:由于 Fable 额度上限为周总额度的 50%,需通过 /usage 监控两条进度,让 Fable 负责需求判断、任务编排和结果验收,将检索、编码、测试等执行类工作交给 Opus/Sonnet 子代理,实现额度均衡利用。作者分析了子代理的适用场景与成本、High/Medium/Max 推理强度的选择策略、1M 上下文的陷阱与压缩时机、提示词轻量化趋势,并提出团队落地建议:通过 CLAUDE.md、Skill、Subagent、Hook、MCP 等形式沉淀团队经验,先用 explorer、implementer、verifier 三类 Agent 在真实任务中验证,再逐步扩展工程化体系。
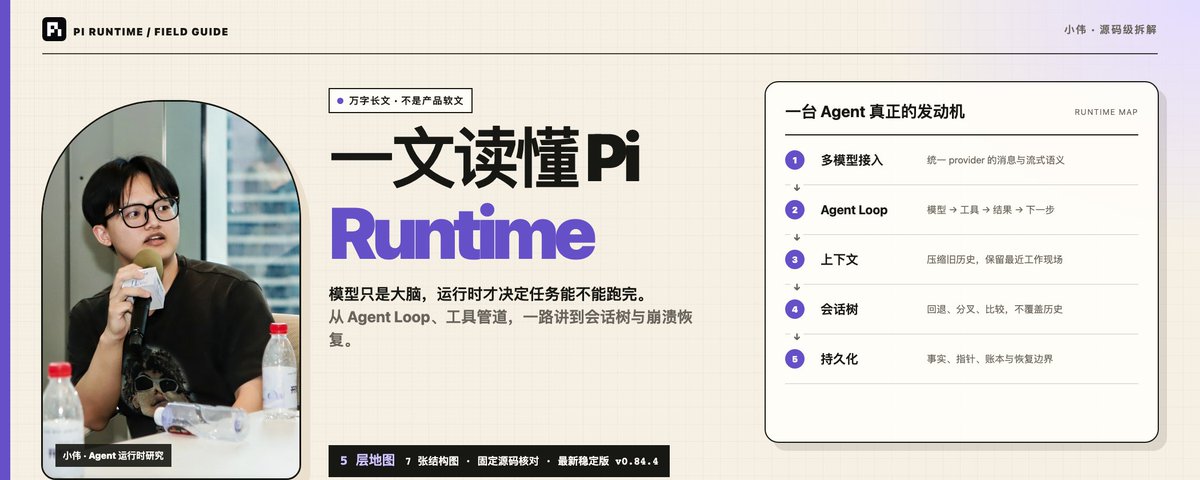
本文系统解析开源 AI Agent 工具包 Pi Runtime。作者指出,模型推理与工具执行之间需要一层可靠的运行时控制逻辑。文章详细介绍 Pi 的五个核心包:pi-ai 统一多模型供应商差异、pi-agent-core 是运行时本体、pi-coding-agent 是可直接使用的终端产品、pi-tui 提供终端交互、pi-telemetry 提供观测能力。随后深入讲解一次任务的完整执行链路、steering 与 follow-up 的双层循环设计、工具调用六阶段管道、副作用工具的重试与重放策略、上下文压缩的现场重建机制及会话树结构,适合想理解 Coding Agent 底层原理及选型 Agent 框架的研发与产品团队阅读。
作者逐行阅读 OpenAI 开源的 Codex harness(rust-v0.150.1)与 DeepSeek Harness(dsh v0.1.1-rc.2)的源码,从工具调度、多智能体、上下文管理、沙箱、可观测性、模型互操作等十个维度对比两者,并设计了五个机制场景、六个组合共 150 次真实 agent 运行测试。文章揭示多个反直觉发现:Codex 多智能体更成熟但没有独立的读文件工具;Codex 只支持 Responses 协议而 dsh 兼容 chat completions;两者在上下文压缩上防的是不同故障。结果 149/150 通过,压缩场景 Codex 快约五倍。文章最后给出按使用目的的选型建议。
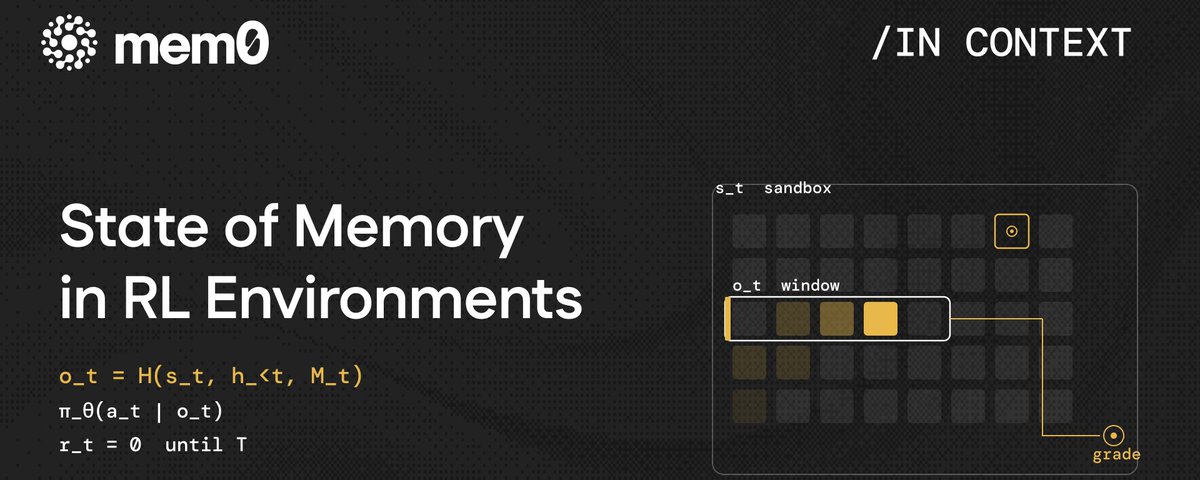
本文探讨了强化学习环境中记忆系统的设计问题。各实验室通过可验证奖励(如测试通过与否)在沙盒环境中训练编码智能体。单个任务往往涉及数百次工具调用,而模型只能看到上下文窗口内的内容,harness 负责决定哪些历史信息进入窗口——这就是记忆系统。文章介绍了 AgeMem、CompactionRL 等研究如何将记忆管理(压缩、检索、写入)纳入策略本身进行训练,并用任务奖励进行评分。Cursor 认为生产环境的 harness 就是训练环境,在数十万并发沙盒中训练 Composer 模型。核心观点是:沙盒保持完整状态,但策略只看到 harness 构建的观察窗口,记忆即跨越这一边界的信息。
本文深度解读 DeepSeek Harness(dsh)的设计,这是一套面向智能体应用的运行框架。文章详细阐述了其基于 Cordis 的插件化架构、Profile/Bundle/Patch 的配置系统、Agent 与 Session 的分离设计、事件驱动的扩展机制、模型适配器注册表、工具执行管线、权限与沙箱、上下文压缩、子智能体与工作流等核心概念。dsh 强调一切皆插件、日志驱动模型上下文、能力按接口/实现/消费方拆分,旨在提供高度可组合、可替换、可观测的智能体运行环境。
文章分析了 Claude Code 源码泄漏事件,指出其核心价值在于揭示了 51 万行 Harness Engineering 代码背后的工程设计,而非模型本身。作者详细拆解了六个关键工程决策(如上下文压缩、多 Agent 协调等),并重点梳理了泄漏后 24 小时内涌现的开源生态,包括洁净室重写、教学项目及各类插件工具,最后总结了 Agent 开发应从“调 prompt”转向“工程化”的核心理念。
文章深入探讨了 AI Agent 遗忘信息的根本原因。作者指出,问题通常不在于检索,而在于 KV Cache 在上下文过长时的处理机制。文章对比了 StreamingLLM(仅保留近期信息)与 SnapKV(基于注意力分数保留关键信息)的区别,并解释了模型如何通过“注意力权重”来决定哪些 Token 值得被记忆,从而实现 92% 的压缩比且不丢失关键信息。
文章解读了 OpenAI 官方关于智能体工程的实战指南,详细介绍了构建长期稳定 Agent 的三个核心要素:技能、Shell 工具和上下文压缩。文中结合 Glean 等企业的生产数据,提供了 10 条关键实战技巧(如技能描述即决策边界、负面示例防误触等)及三种从简单到高级的构建模式,旨在解决系统提示词膨胀和工具调用准确性问题。