Wiki 知识库

全部文档 / 标签: RAG

205 篇
清除

Agent 高频题 04. Agent 效果怎么评测:评测集怎么建、指标怎么定、怎么证明变好了

本文是 Agent 高频面试题详解系列第 4 题,系统讲解 Agent 效果评测体系。文章基于 64 场面试面经分析,归纳出评测追问的八个方向,并结合 Anthropic、OpenAI 等实践经验展开:先明确评什么(Agent 评测难在结果在环境状态中、路径不唯一、结果不确定);评测集怎么建(题目来自真实失败、业务方、合成数据,注意分层、防泄露与防过拟合);谁来打分(代码判分、模型判分、人工判分三种方式的取舍,LLM-as-a-Judge 的位置偏差、冗长偏差等已知问题及校准方法);以及如何通过基线对比、多次运行排除随机性,证明改进真实有效。文章强调评的是 Harness 和模型的整体,判结果而非规定路径。

技术 › Agent 码良 2026-10-2562.0 KB 5.1K 38 88

一线 FDE 深度复盘:企业 AI 知识库,从 demo 到真正用起来

作者以制造业企业 AI 知识库项目为例,复盘了从 demo 到真正落地的完整链路。文章指出 demo 成功不等于企业可用,需要经历真实问题验证、资料核对、查询设计、业务验收、人工接管、知识更新和持续运营八步。核心观点包括:签约前用真实问题测试真实资料、区分单项查询与完整筛选需求、源头纠错修正原始资料、验收关注实际等待时间、设计人工接管路径、沉淀人工答案、明确知识运营负责人,以及报价时把建设、维护和知识更新分开核算。
技术 › LLM Hedy Zhang 2026-10-2212.7 KB 15.4K 131 86

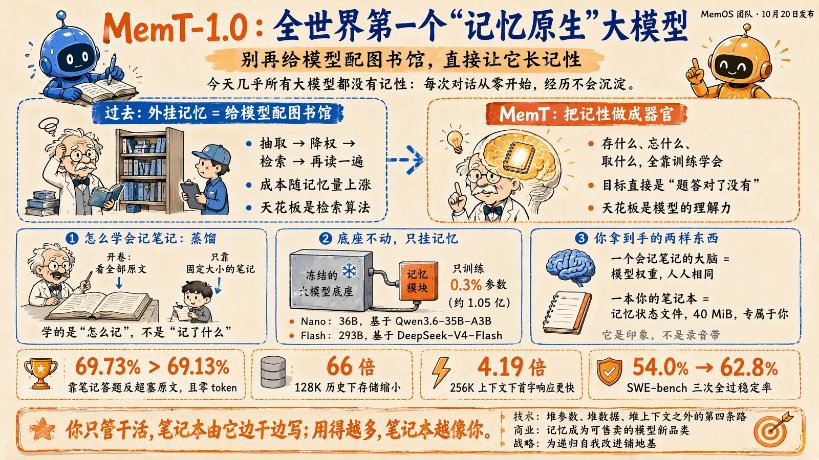
全世界第一个记忆原生大模型 MemT-1.0 上线

MemOS 团队发布全球首个“记忆原生”大模型 MemT-1.0,将记忆能力直接训练进模型权重,取代 RAG、Mem0 等外挂记忆方案。其思路是不改底座、参数冻结,仅在部分层并联约 1.05 亿参数的记忆块,通过蒸馏训练让模型自学“什么该记、什么该忘、怎么取用”,优化目标从检索命中率改为任务答对率。交付物包括通用模型权重(会记笔记的大脑)和用户专属记忆状态文件(仅 40 MiB 的笔记本)。数据显示其 40 MiB 记忆答题成功率 69.73%,略高于全量上下文的 69.13%,存储缩小 66 倍、首字响应快 4.19 倍。已在 Hugging Face 和 GitHub 开源,被视为开启模型“在使用中变强”的第四条技术路线。

技术 › LLM huangserva (@servasyy_ai) 2026-10-218.8 KB 73

Agent 高频题 01. 讲讲你的 RAG 链路

本文是 Agent 高频面试题详解系列第一篇,聚焦 RAG(检索增强生成)链路。文章基于近两个月牛客网 82 场面试的统计,指出 RAG 是最常被追问的题目。内容先给出 RAG 整体架构图,解释为什么需要 RAG 及其与长上下文、grep、微调、工具调用、记忆等方案的边界;再沿离线、在线两条线逐环讲解:离线部分涵盖文档解析、切分策略、embedding 向量化、HNSW/IVF 索引原理;在线部分讲解问题改写、BM25 与向量多路召回、RRF 融合、交叉编码器重排等环节。每个环节均附上面试常见追问,并提供复习优先级参考。

技术 › Agent 码良 2026-10-2041.5 KB 10.7K 70 78

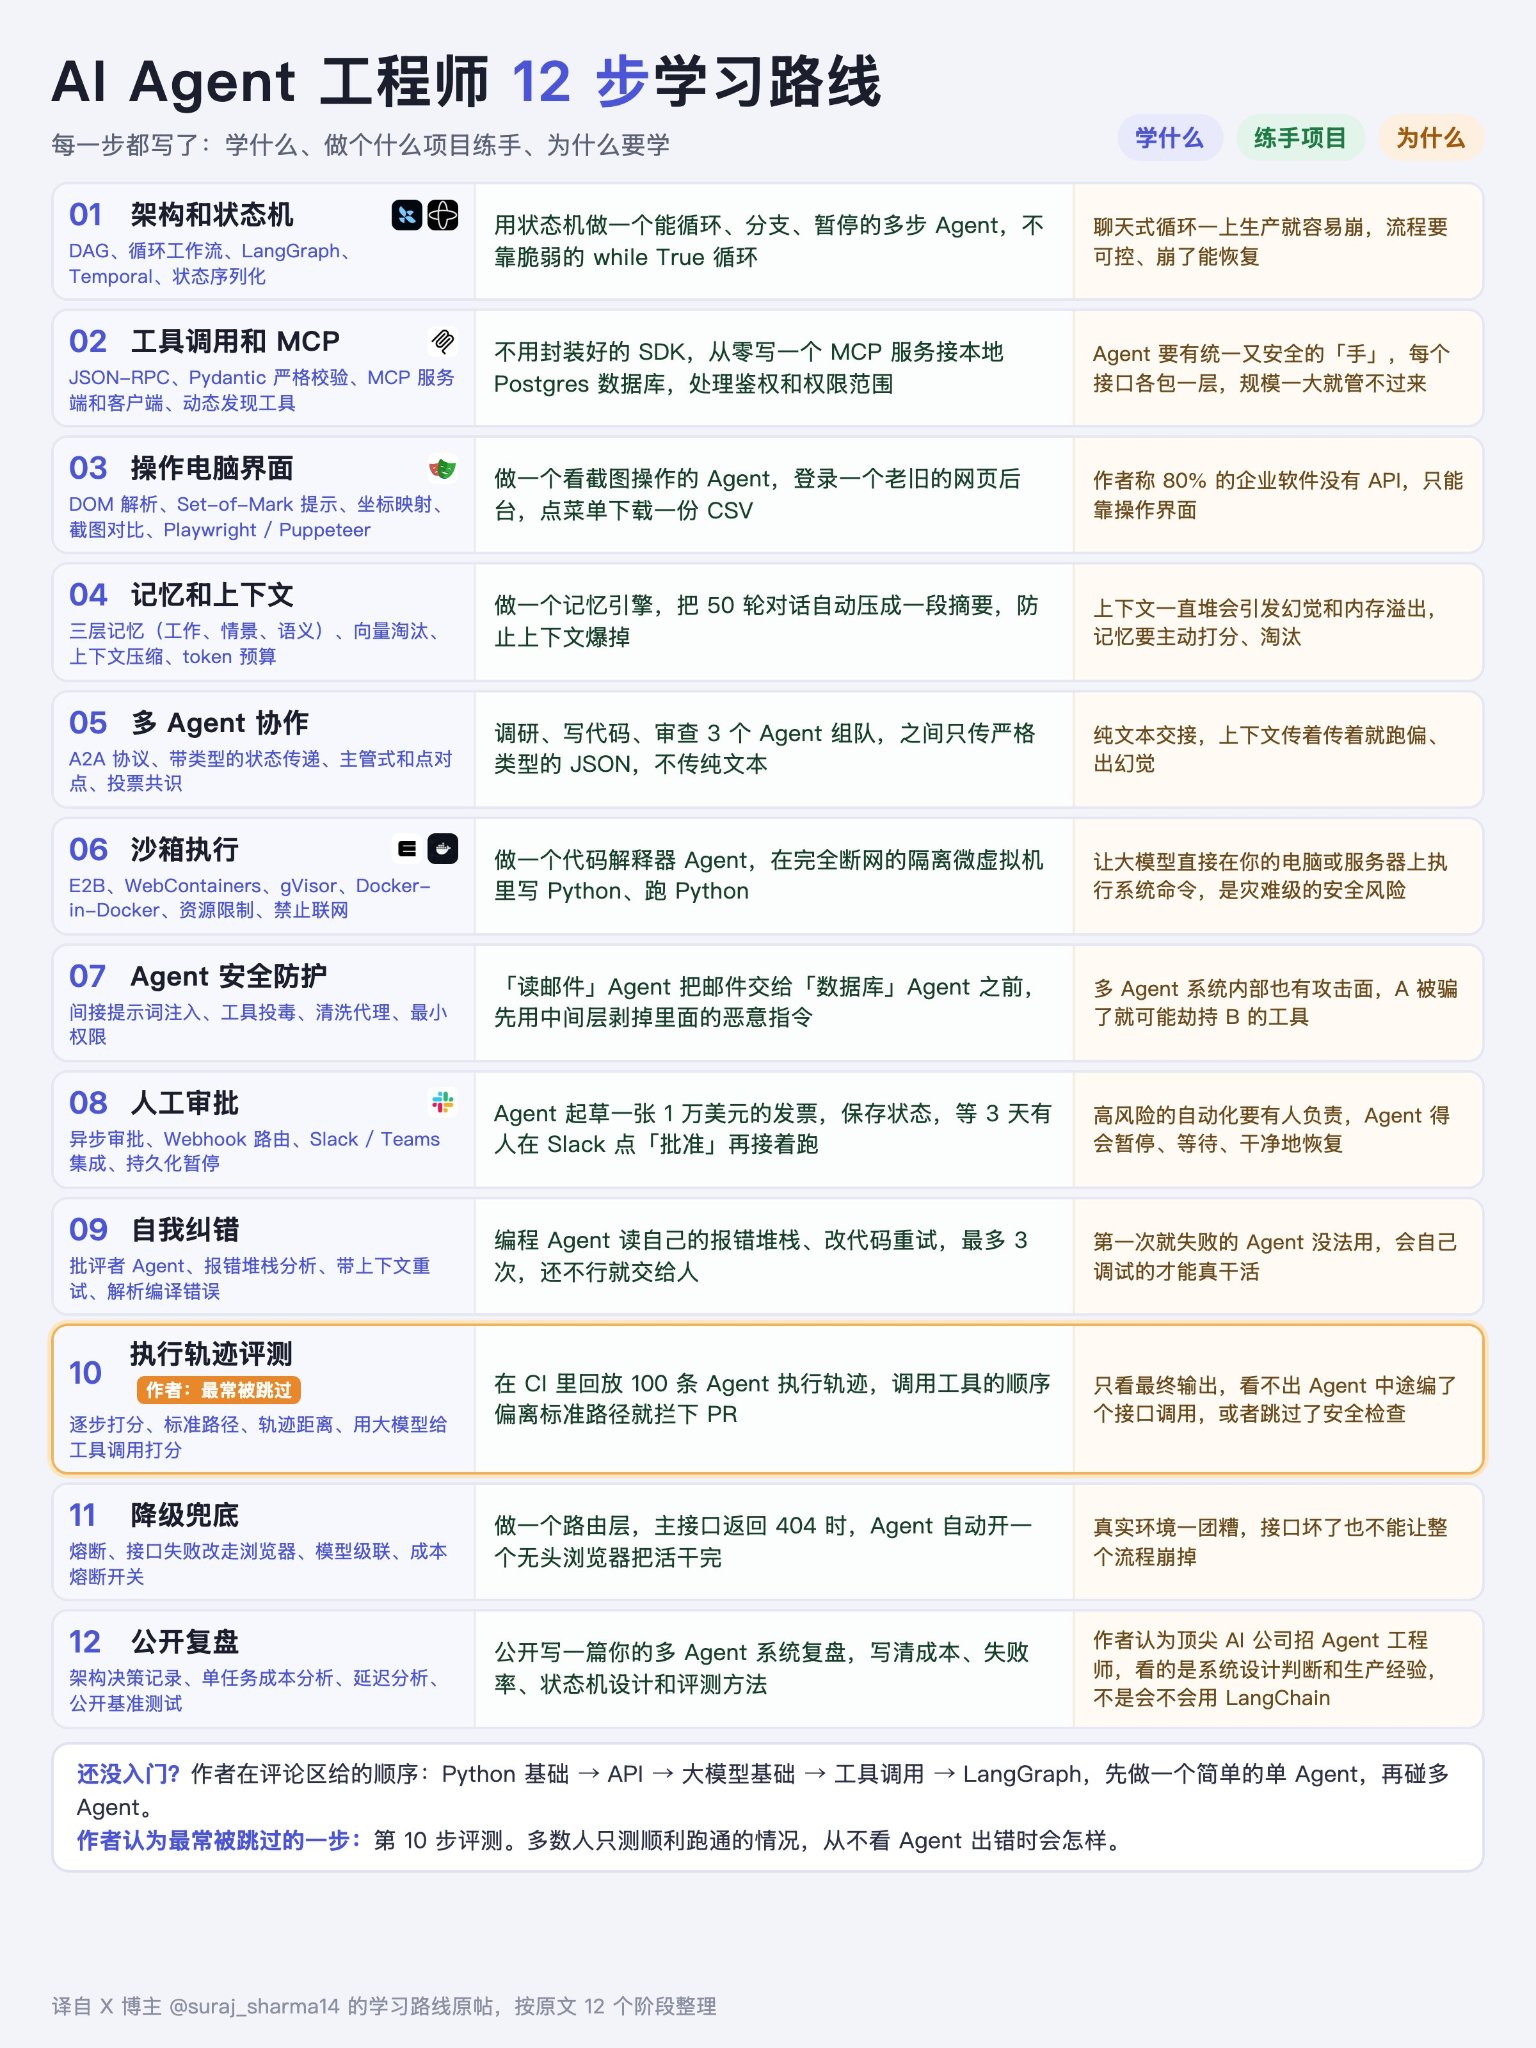
AI Agent 工程师 12 步学习路线图:从 Demo 到企业级落地

文章指出许多人做 AI Agent 只是调用大模型 API 加上工具和 LangGraph,跑通 Demo 与企业级生产落地之间差距巨大。作者结合自身企业 AI 项目经验,将 Agent 工程师学习路线分为四个阶段:一是掌握基础,理解 Agent 工作原理;二是赋予执行能力,包括 MCP、浏览器自动化、记忆与上下文管理、沙箱与权限控制;三是安全、多 Agent 协作与人工审批,明确权限边界,防止错误放大;四是错误处理、执行轨迹评测、降级兜底与工程复盘。作者强调评测数据是判断系统优劣的关键,建议边做边学,完整交付一个项目比做十个 Demo 更有价值,真正稀缺的是能让 Agent 稳定运行的工程能力。

技术 › Agent Ethan 恩宇 (@UPing123zzz) 2026-10-207.0 KB 74

深度体验 EverOS Cloud:让 Agent 记忆与经验沉淀为技能的测评

文章针对 AI Agent 开发中记忆缺失、RAG 低信噪比切片、状态冲突与多主体污染三大痛点,测评了 EverOS Cloud(API v2)这一 Agent 记忆操作系统。核心机制包括语义事件切割、记忆整合消解冲突、多主体严格隔离,在 LoCoMo 基准上达 93.05% SOTA,减少 90% 以上 Token 消耗。其自进化技能引擎可将任务执行链路沉淀为 Case 并蒸馏为可复用 Skill,任务成功率最高提升 234.8%。接入仅需两行核心调用,支持记忆治理 API、多模态资料挂载、MCP 协议兼容 Claude Code 等工具,以及云/本地双模部署。作者认为其适合需要跨会话跟踪意图与沉淀业务 SOP 的场景。

技术 › Agent 浅水虾 2026-10-207.9 KB 5.2K 55 74

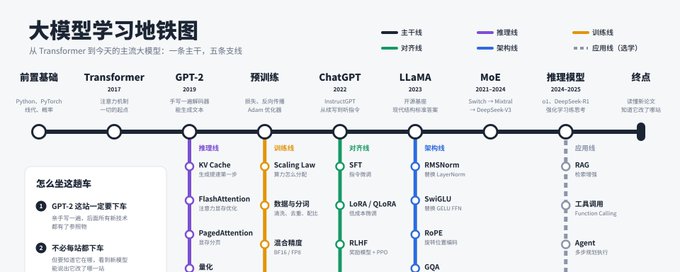
大模型学习地铁图:从 Transformer 到今天的主流大模型

文章以地铁图为比喻,为大模型学习者规划了一条清晰的学习路线。主干线按演进顺序设置八站:前置基础、Transformer、GPT-2(强调亲手实现作为锚点)、预训练、ChatGPT 时刻(RLHF)、LLaMA、MoE 稀疏专家、推理模型(o1/R1),终点是能独立读懂新论文。五条支线按兴趣选修:推理优化(KV Cache、FlashAttention、量化)、训练(Scaling Law、分布式并行)、对齐(SFT、LoRA、DPO、GRPO)、架构(RMSNorm、RoPE、MLA)、应用(RAG、Agent)。最后给出建议:GPT-2 必须亲手写一遍,主干加一至两条支线即可入门,学习原理时动手推算。

技术 › LLM 纳米AI 2026-10-2010.4 KB 52K 871 88

Agent 高频面试题单(8.18–10.18)

本文基于牛客网 8 月 18 日至 10 月 18 日的一手面经,统计了 180 位作者、343 场面试、近 80 家公司的 Agent 岗高频面试题。统计显示,问得最多的是 RAG 链路和 AI Coding 工具使用(各占三成多),其次是多 Agent 拆分、Agent 评测、上下文压缩、Skill/MCP/Function Calling 边界、记忆设计、Harness 与 Agent Loop、LangGraph/LangChain 等。文章逐题列出问法、公司分布和轮次分布,并指出 Skill、MCP、Agent 评测和 Harness 在 9、10 月明显增多,手撕题仍以 LeetCode 为主。

技术 › Agent 码良 2026-10-1947.6 KB 17.2K 70 79

2小时从零看懂 AI:一篇文章建立AI认知体系(8000元企业内训同款)

本文是作者基于3家企业AI内训经验整理的AI入门长文,涵盖四大部分:大模型通识、提示词方法、智能体入门与实操。文章用通俗语言解释AIGC概念、大模型的定义与工作原理(概率预测文字接龙)、AI的优势(信息处理、知识覆盖、内容生成)与局限(幻觉、时效性、偏见、推理限制),并阐明AI软件=大模型+产品界面的本质,介绍提示词、微调、RAG三种大模型优化手段,帮助读者快速建立完整的AI认知框架。

技术 › LLM 龙井longjing 2026-10-1775.5 KB 583.4K 5.3K 73

做一个违背祖宗的决定,手把手教你使用 AI 全自动管理微信群

本文面向社群运营、技术支持与客服团队,详细介绍了如何基于 FastGPT 搭建一套生产级的 AI 智能社群客服系统。作者拆解了由 15 个节点、28 条连线组成的完整工作流方案,涵盖知识库整理、消息意图过滤、多渠道(飞书/微信)分流、Agent 应答规则定制、双知识库检索工具挂载以及问题分类打标与运营数据沉淀等核心环节,并说明了飞书机器人权限配置、富文本消息渲染及微信生态多种接入方式,实现智能回复与人工兜底的自动化客服闭环。

技术 › Agent 米开朗基杨 2026-10-1222.0 KB 11K 26 85

杀死 2023 RAG 的,是更好的 RAG:9 位检索专家的前沿实战共识「Beyond Naive RAG」

本文介绍 Hamel Husain 主编的演讲合集《Beyond Naive RAG》,汇集 9 位一线检索专家的共识:朴素 RAG(切块+单向量+余弦检索)已失效,但检索增强生成本身远未死亡。全书论证三条主线:长上下文不能替代检索(Context Rot 证明上下文越长模型越不可靠);评估先于优化(公开基准已污染,须建自有黄金数据集);复杂性不是目的(慎用图数据库等过度工程)。涵盖 ColBERT 后期交互、推理增强检索(Promptriever、Rank1)、多重表示与智能路由、FreshStack 评估指标等前沿方法,提出'评估驱动+多表示+推理增强+克制架构'的实践观。

技术 › LLM meng shao 2026-10-1211.9 KB 4.7K 43 84

万字总结:成为 Agent 工程师的学习线路

作者面试一家 AI+Web3 公司失败后,获得面试官分享的《Agent工程师入门指南》,并结合自己的学习心得整理成一条完整的 Agent 工程师学习路线。内容涵盖 LLM 基础(Transformer、Token、上下文窗口、采样参数、API 协议、流式输出、结构化输出、工具调用、Embedding)、Prompt Engineering(Zero-shot/Few-shot、CoT、ReAct、Reflexion)以及 RAG(文档解析、分块、检索与重排)等核心知识。每个知识点都附有学习文档链接、项目要求和验收标准,帮助学习者系统掌握 AI 应用开发技能并检验学习成果。

技术 › Agent Chasen 2026-10-1148.9 KB 130.2K 1.6K 85

Scaling AI in Legal: Building Uber's Redlining Agent

Uber 工程团队分享了其法律红线审查智能体(Legal Redlining Agent, LRA)的构建经验。该系统以 Word 插件形式集成到律师的工作流中,能够识别外部合同修改、理解对方意图、基于政策生成建议和评论并标记风险。自上线以来,合同平均审查时间缩短超过 20%,律师对 AI 决策的采纳率达 91%。文章详述了从 RAG 方案到引入律师反馈自学习循环的四次迭代历程,核心经验是:从业务问题出发、嵌入律师既有工作流程以赢得信任,并通过紧密的反馈迭代持续改进智能体。该系统助力 Uber 法务团队获得 2026 年 ALM Legalweek 年度最具创新法务部门奖。

技术 › Agent Uber Engineering 2026-10-1025.2 KB 38.7K 313 76

The 2026 LLM Engineering Roadmap

本文提出了2026年LLM工程路线图,指出与LLM工作不只是提示词,生产级系统需要对LLM的工程化、部署和优化有深入理解。文章总结八大支柱:提示工程(将prompt当作代码管理)、RAG系统(嵌入、检索、重排)、上下文工程(管理上下文窗口中各类信息的取舍)、微调(LoRA/QLoRA等技术)、Agent(工具调用循环与编排、状态管理、重试逻辑),并为每个领域提供了大量免费开源学习资源,如Anthropic、OpenAI官方指南及多个GitHub教程仓库。

技术 › LLM Avi Chawla 2026-10-0919.8 KB 403.3K 447 71

一家大型企业有几十万份文档,究竟应该怎样交给AI?

文章结合为大型国企交付几十万份文档知识库项目的实战经验,指出将文档导入知识库只是最容易的一步,真正难点在于知识分散在OA、ERP、CRM等多个系统中、文档质量参差不齐、版本与权限管理复杂、以及上线后的持续运营。作者提出企业真正需要的不是一个'AI知识仓库',而是一条具备知识工程能力的企业知识供应链:通过Connector持续接入知识,经解析、清洗、结构化等知识工程加工后准入,并以检索前权限过滤保障安全,最终在Agent时代构建企业上下文层,让正确的知识在正确的时间以正确的权限交给AI。

技术 › LLM 土猛的员外 2026-10-0925.8 KB 3.1K 12 83

GEO 新手终极保姆级教程

本文是一份面向独立开发者和一人公司的 GEO(生成式 AI 搜索优化)新手教程。作者解释了 GEO 的概念:让 AI 在回答用户问题时能提及、推荐并正确描述你的产品。文章先介绍了 AI 回答的 RAG 原理,对比了 GEO 与 SEO 的异同,然后给出零预算的五步实操方法:收集真实问题并观察 AI 回答、制作产品事实卡并优化产品页、按引用友好格式撰写内容、选择发布渠道、定期复查记录。文中还引用普林斯顿 GEO 论文数据,说明引用来源、数据和引语能显著提升可见度,并指出常见误区。

技术 › LLM 超级峰 2026-10-0438.6 KB 11.2K 82 82

BestBlogs 早报|OpenAI 发布 GPT-6 选型指南,LEO 分析智能体采购部署,Airbnb AI 改造延伸到客服测试

本期早报围绕 AI 智能体的选型、部署与落地展开。精讲一介绍 OpenAI GPT-6 系列模型使用指南,讲解 Astra、Sol、Luna 三款模型的定位、推理强度调节、提示词缓存与成本优化策略。精讲二是 a16z 与采购智能体公司 LEO 的访谈,探讨企业 Agent 部署为何比构建更难,强调系统记录之外的例外流程决定 Agent 能力边界。精讲三介绍 Airbnb 由内而外的 AI 改造,包括原型协作、Everest 知识复用平台及 AI 客服实践。速览涵盖替代 GPU 的计算路线、Spring AI 模块化 RAG、Fractile 推理芯片、Pi 的 MCP 支持与持久化框架、Cloudflare AI Search 及 Instinct 个人智能体等内容。

技术 › LLM ginobefun 2026-10-0324.1 KB 2.9K 1 77

Why LLMs can't write well and how Sherpa fixes it

Pocket FM 创始人 Rohan Nayak 分享其 AI 写作系统 Sherpa 的构建历程。通用 LLM 因训练目标(逻辑推理、快速给答案)与创意写作需求(张力、情感、悬念、节奏变化)相悖而写不好故事,且缺乏清晰的强化学习成功信号。微调现成模型的尝试均告失败后,团队自研 Sherpa harness,由规划器、叙事世界模型(NWM,维护结构化故事状态与记忆)和散文引擎三大组件构成,并利用 Pocket FM 亿级用户的收听数据做强化学习,用户留存与完听率成为写作质量的天然反馈信号。盲测中 Sherpa 在 65.6%-97.1% 的配对比较中胜出,NWM 多跳检索准确率达 86.7%,成本约为同类方案的 1/21。

技术 › LLM Rohan Nayak 2026-10-0112.5 KB 349.1K 507 74

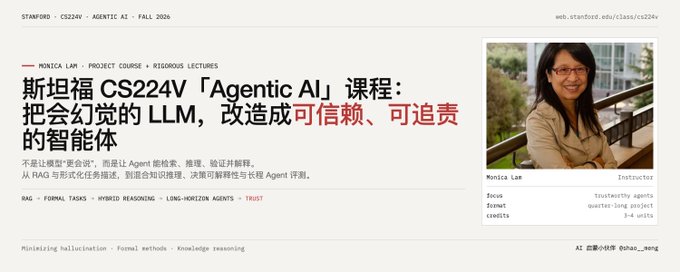
斯坦福 CS224V「Agentic AI」课程:把会幻觉的 LLM 改造成可信赖的智能体

文章介绍斯坦福 Monica Lam 教授团队主讲的 CS224V「Agentic AI」研究型课程。课程围绕一个核心问题:如何将本质上不可靠、会幻觉的 LLM 变成可信赖、可追责的智能体。技术主线是一条自底向上的“反幻觉”知识栈,涵盖 LLM 基础、知识策展(STORM)、RAG(WikiChat)、结构化数据查询(SUQL、SPINACH)、形式化方法与可追责 AI(SMT、SatIR、VERDICT)、任务型对话 Agent 及元 Agent 优化。课程以研究项目为核心(占 65%),依托开源平台 AOS,选题集中于医疗遗传学等领域。其哲学是系统工程+形式化约束,与业界依赖规模的路线形成鲜明对比,适合有 NLP 基础、想做真实 Agent 研究的人。

技术 › Agent meng shao 2026-10-018.3 KB 18.9K 79 80

Agent Memory Is Not a Search Problem

文章指出 Agent 记忆系统的核心问题不是检索而是上下文组织。跨 15 个模型、20 万模拟对话的研究显示,任务拆分为多轮会使准确率平均下降 39%,而合并为单轮可恢复大部分损失。文章回顾了 Agent 记忆的四个发展阶段(全量历史、滚动摘要、向量检索、知识图谱),批评语义/情景/程序性记忆分类无法指导检索决策,并主张按六种问题类型构建六种上下文形态。作者基于开源 Graphiti 引擎,以客户历史为例实操演示如何让记忆系统在模型运行前正确组织上下文,避免基于过时信息的自信回答。

技术 › Agent Akshay 2026-09-2919.3 KB 27.4K 171 86

10 个带你从基础检索到生产级 AI 系统的 RAG 项目

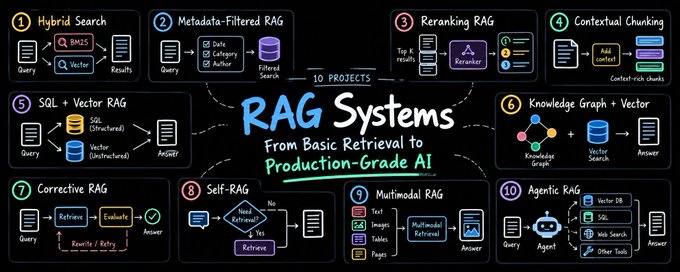
文章指出仅掌握基础的'chat with PDF'式 RAG 流水线(分块、嵌入、向量检索、LLM)不足以构建真实生产系统,并推荐 10 个进阶项目:混合检索(BM25+向量)、元数据过滤、重排序、上下文分块、SQL+向量混合、知识图谱+向量、纠错式 RAG、自感知 RAG、多模态等。每个项目均说明要解决的问题、系统架构、技术栈(Python、pgvector、LangGraph、Neo4j 等)及学习要点,帮助开发者从语义相似度走向关键词匹配、结构化过滤、关系推理与检索质量反馈等生产级能力。

技术 › LLM Jaydeep 2026-09-2912.2 KB 22.5K 314 78

把 Jev 插进 RAG:爆速与降本到底能不能实现,实测验证

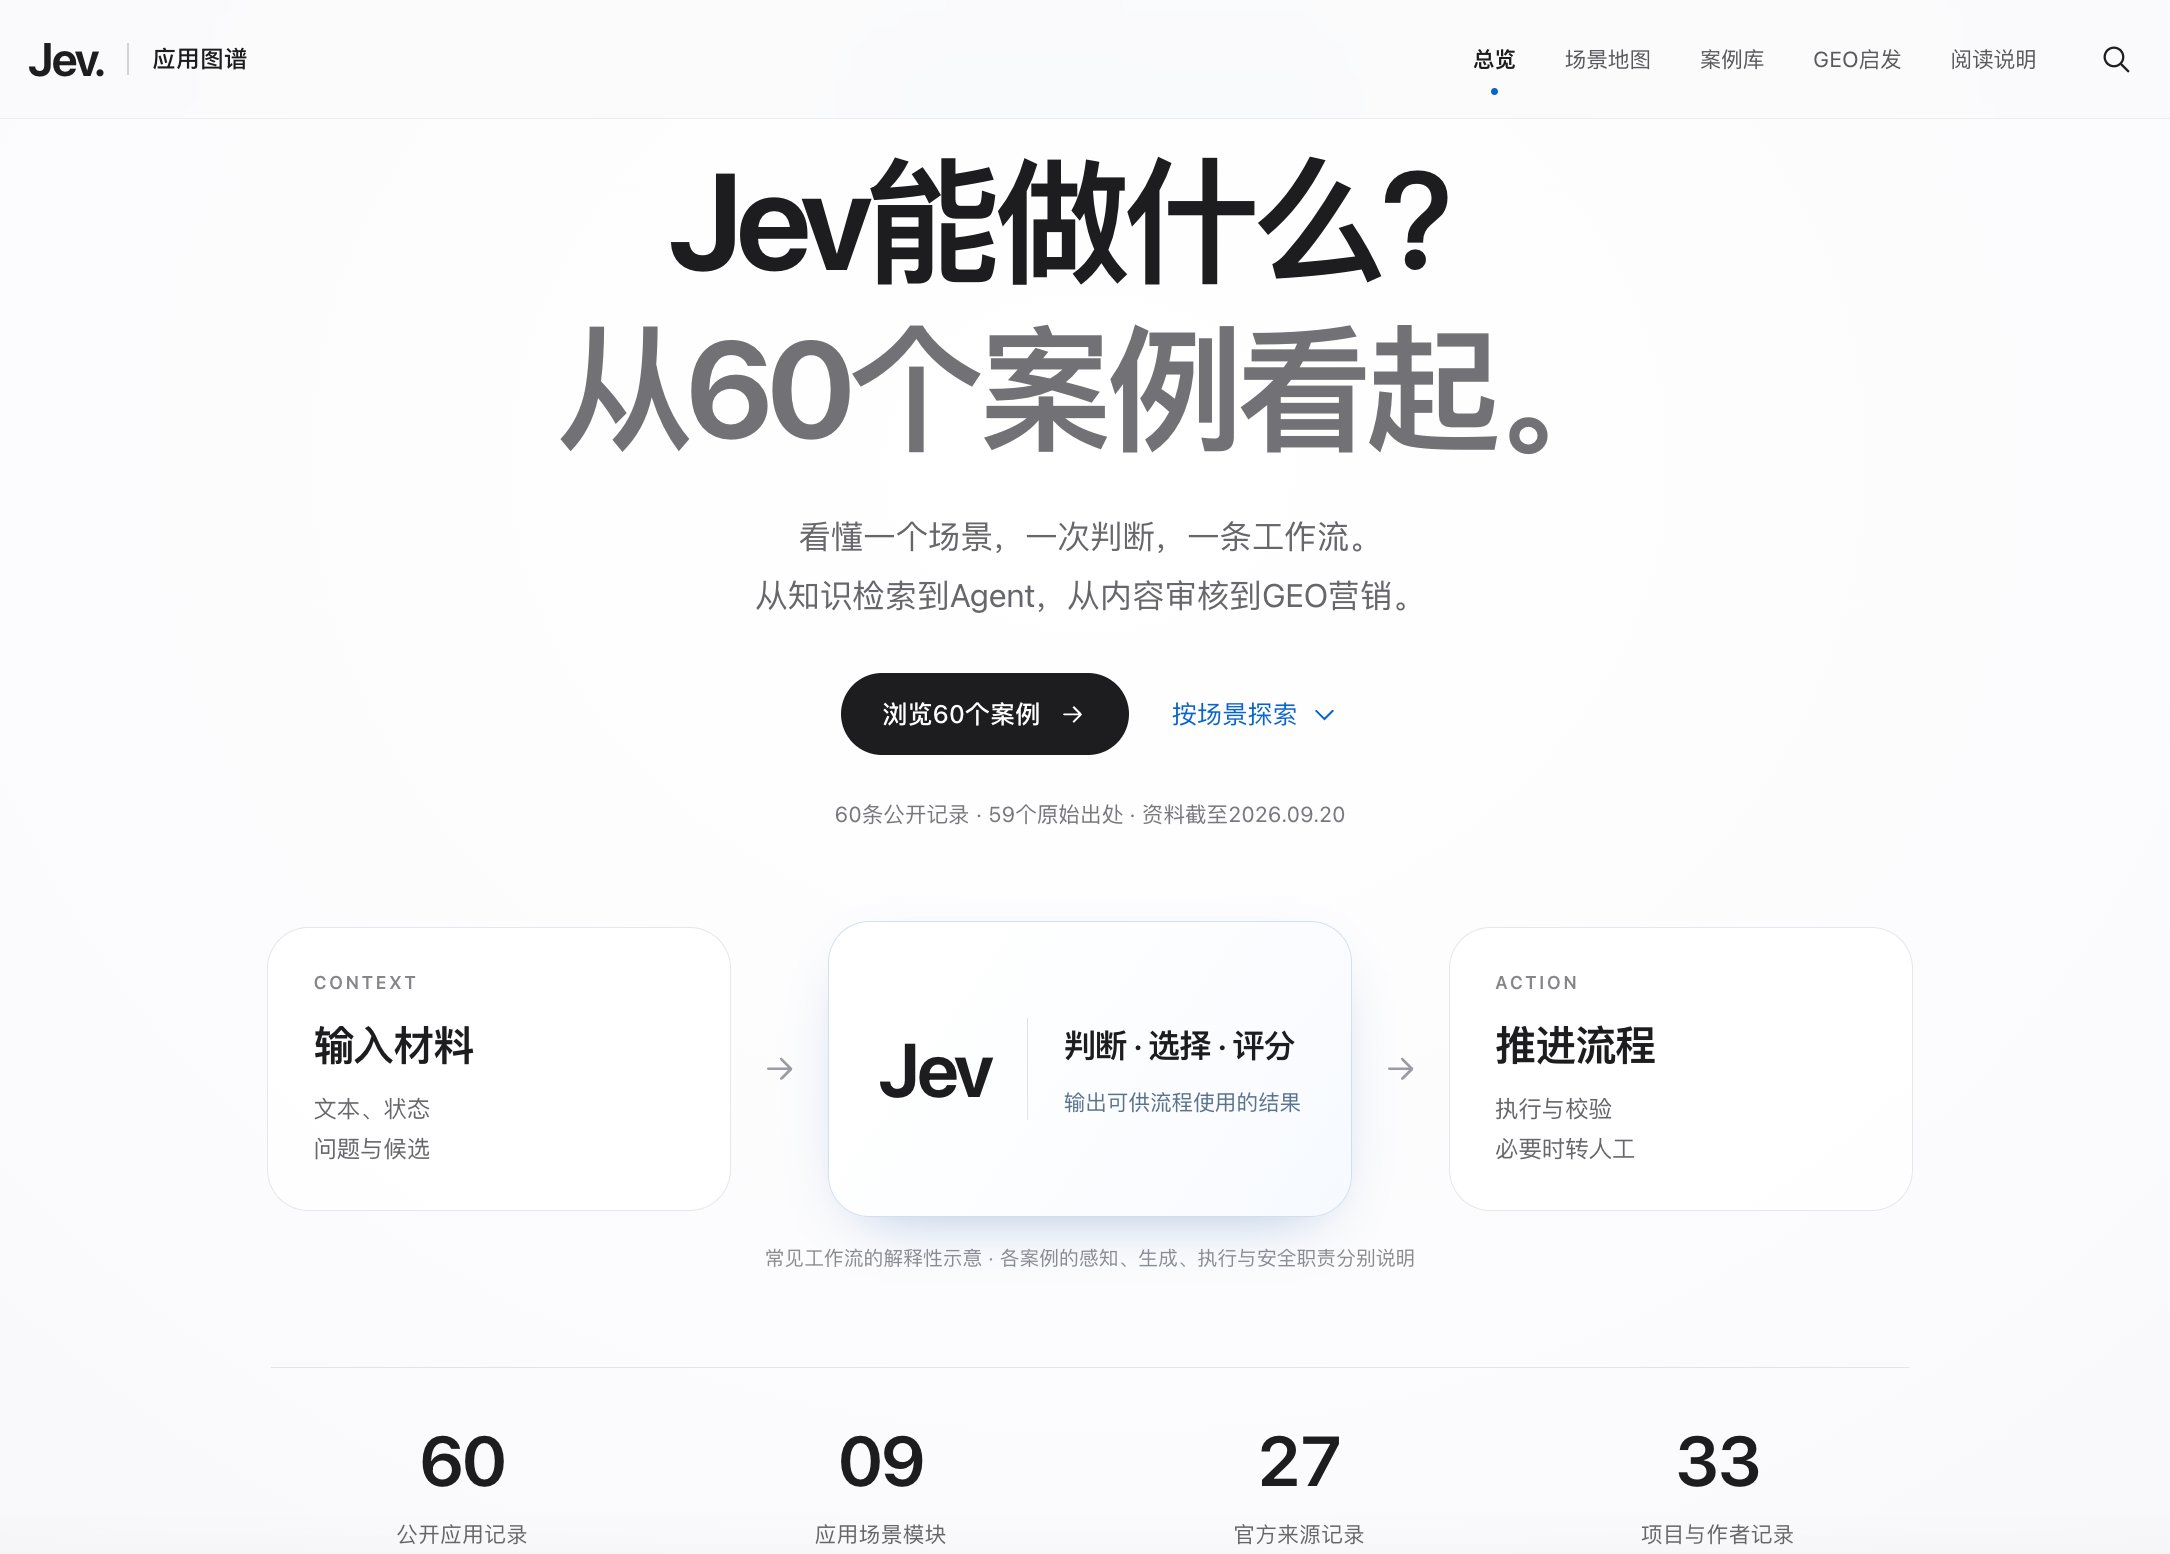
本文实测了 TypeSafe AI 发布的不生成文本的 AI 模型 Jev 在 RAG 检索流程中的效果。作者在重排、回答判断、检索前置门卫三个环节插入 Jev 进行验证:重排方面,Jev 以八分之一的成本达到接近 Cohere Rerank 的精度;在调用 LLM 之前用 Jev 判断「无法回答」,响应速度提升 5.6 倍,成本降至二十七分之一;在检索之前拦掉范围外提问,速度提升 7.4 倍,成本降至七十五分之一。此外,Jev 还能一次请求同时完成重排和回答判断。结论是用 Jev 改善 RAG 速度与成本可行,但需慎重设定阈值,避免误拦可回答问题。

技术 › LLM yibie 2026-09-2416.7 KB 10.8K 85 85

AI Evals 课程沉淀的 8 个 Skills:错误分析 → 评测器 → 校准 → 监控

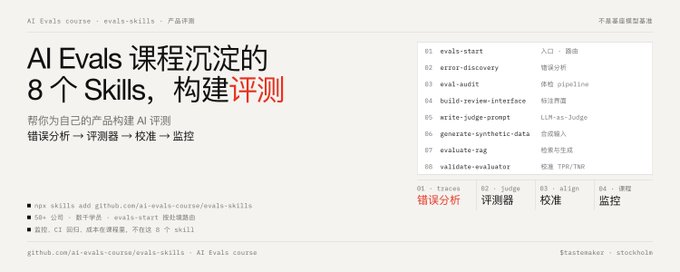
文章介绍了来自 Hamel Husain 和 Shreya 的 AI Evals 课程沉淀的 8 个 Skills,帮助工程师和产品经理为自己的 AI 产品构建评测体系。核心理念是先看数据再写评测:先手动阅读真实 trace 做错误分析,发现失败模式,再针对每个模式构建评测器,并用约 100 条人工标注校准(TPR/TNR 目标 >90%)。8 个 Skills 覆盖入口路由、错误分析、评测审计、合成数据生成、Judge 提示词编写、评测器校准、RAG 评测和标注界面构建。方法论强调二值评判、单一 judge 测单一失败模式、Rogan-Gladen 偏差修正等最佳实践。

技术 › LLM meng shao 2026-09-238.6 KB 13.9K 66 85

60个Jev典型案例整理与12个最值得关注案例详解

作者收集整理了60个Jev应用案例,并精选12个典型场景进行详解。这些案例的核心逻辑是:生成模型负责写作与复杂推理,Jev承担分类、筛选、评分和选择,代码执行后续动作,关键节点保留人工复核。案例涵盖品牌提及识别、实体对齐去重、RAG信源筛选、引用核验、网页操作决策、Skill选择、工具风险检查、客服工单分流、官网表达检查、论文引用验证、级联校验信息抽取及文本特征化等多个方向,对理解AI应用的工程化实践具有参考价值。

技术 › Agent 姚金刚 (@yaojingang) 2026-09-224.1 KB 79

万字 GEO 入门教程,小白友好!

本文是一篇面向小白的 GEO(生成式引擎优化)入门教程。作者从 SEO 类比出发,解释 GEO 的核心目标是让 AI 能够发现、理解、信任并推荐品牌。文章梳理了 AI 回答的五步流水线(意图理解、查询扇出、检索、筛选打分、生成回答),并提出启动 GEO 的三个信号:客户已在问 AI、竞品已布局、处于拓荒红利期。实操部分包括 AI 可见度诊断、网站技术检查、建立 AI 问题库、内容创作六法则、构建多层次信源及持续监测优化。最后阐述了 SEO 与 GEO 双层优化的协同方法,强调同一篇文章可同时服务搜索排名与 AI 引用。

技术 › 工具与效率 Tiny | AI 创业版 2026-09-2115.6 KB 6.9K 39 83

AI Agent 时代的营销:一个 SEO 老兵眼中的 GEO 与社群 - INDIGO TALK EP 51

本期 Indigo Talk 邀请 HashMatrix 合伙人大罗,从 SEO 老兵视角拆解 AI 时代的营销与增长。讨论涵盖 AI 在营销中的真正提效场景(多平台内容分发从两三周缩短到十分钟)、AI 难以胜任的无中生有式创意、第四种流量入口——AI 推荐(答案仅有三到五个位置)、AI 推荐机制(训练数据与 RAG,一个问题被拆成十几个 Query)、GEO 与投毒的现状,以及 AI Slop 时代个人声音的稀有度价值。最后得出反直觉结论:Agent 时代最被低估的增长杠杆是活人社群和线下连接,建议新人'做回人'。

技术 › LLM indigo 2026-09-2147.3 KB 8.7K 36 85

如何用自己的数据微调一个小模型

本文是翻译整理的完整小模型微调指南(原作者Rahul),主张用1.5B参数模型配合200-500条高质量样本微调,即可在特定任务上超越通用前沿大模型。文章涵盖微调的正确认知(微调非提升智能而是稳定窄任务)、三个基线建立、选择Qwen2.5-1.5B等小基座模型、数据权利确认、PDF/OCR文本抽取与清洗、按公司切分数据集、QLoRA训练超参配置、幻觉数字检测评测、vLLM部署及监控重训策略。强调数据合规和评测纪律是真正值钱的部分,附完整可运行代码。

技术 › LLM yibie 2026-09-2010.3 KB 213.6K 1.1K 86

从0到1,搭建起你的个人知识库

文章从AI对话缺乏长期记忆的痛点切入,系统讲解了个人知识库的作用、分类与搭建方法。作者介绍了两大主流方案:以检索为中心的RAG知识库和以持续维护页面为中心的LLM Wiki知识库。RAG部分通过Dify演示了从资料上传、切片、混合检索索引建立到Agent接入的完整流程;LLM Wiki部分则介绍了Karpathy提出的三层结构(raw sources、wiki、schema),强调Markdown页面对AI友好且透明可查。最后作者分享了自己结合两者优势的混合方案,帮助读者根据实际需求选择合适的知识库路线。

技术 › LLM Lab 305 2026-09-2044.8 KB 27K 176 82

全网刷屏的 Jev 到底怎么用?8 个能直接抄的案例

本文介绍了 AI 圈新火的模型 Jev——一个不做文本生成、只返回带概率判断的决策模型。文章讲清了它的三种用法(是非判断、选项选择、打分),提供了四种 30 分钟内可上手的接入方式(官方 Skill、Vercel、OpenRouter、SDK),并整理了 8 个可直接复用的真实案例:7 秒订机票、代码审查、工单分流、简历初筛、语义搜索、AI Agent 路由、RAG 重排、动态 UI 拼装等。还总结了 5 个反直觉要点(不写字、零幻觉指格式而非正确性、不会拒绝等)、官方自曝的雷区(不会算术、不懂日期先后、易被提示词注入),以及不适合使用的场景。

技术 › LLM Leaf Yeah! 2026-09-2016.8 KB 131.8K 279 86

新的八股文已经出现:25道Agent高频实操面试题

作者整理了25道Agent方向高频实操面试题,聚焦一线项目落地痛点,分为五大模块:Agent核心架构(ReAct与Plan-and-Execute选型、多Agent设计、HITL机制)、工具调用落地(Function Calling、Schema设计、重试熔断降级)、记忆与状态管理(长短记忆、Token溢出)、效果优化与问题排查(Bad Case溯源、性能瓶颈定位)以及Agent+RAG落地(检索优化、幻觉防控)。这些题目针对FDE等需要真实项目落地经验的岗位,大多是开放性问题,能同时考察面试官和面试者的实战深度。

技术 › Agent Xiao Tan (@tvytlx) 2026-09-203.0 KB 60