让RAG长出脑子:Agentic RAG的多步推理实践
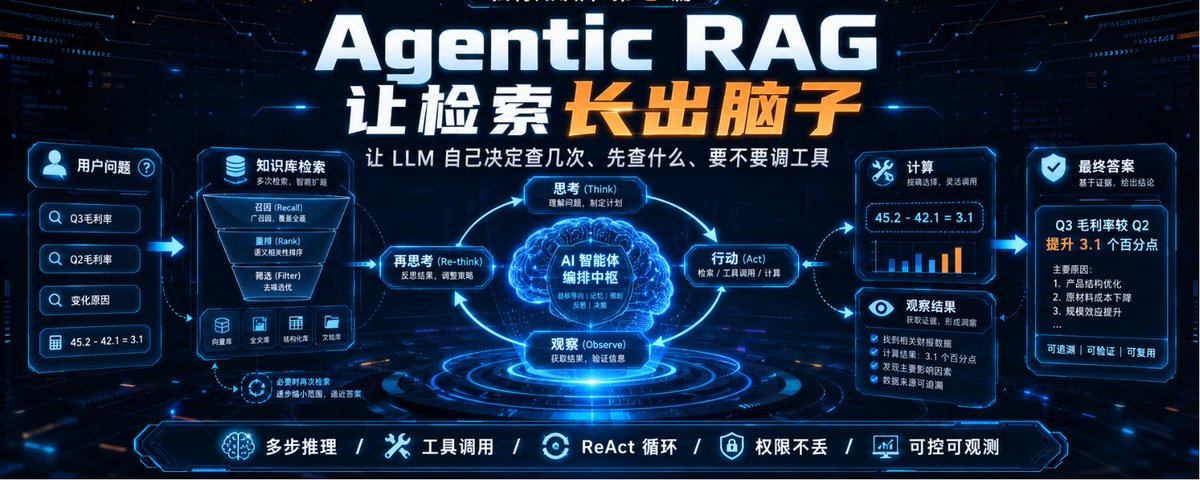
文章指出传统单轮 RAG 在处理复合问题时存在检索不足或幻觉的缺陷,提出通过 Agentic RAG(多步推理)来解决。核心思路是将 LLM 从被动应答升级为主动调度的指挥官,利用 ReAct(推理-行动循环)机制,自主决定检索次数和工具调用。文中详细展示了如何封装检索工具、执行函数(含权限过滤、混合检索)以及编写多步推理循环代码,实现复杂问题的精准回答。
文章指出传统单轮 RAG 在处理复合问题时存在检索不足或幻觉的缺陷,提出通过 Agentic RAG(多步推理)来解决。核心思路是将 LLM 从被动应答升级为主动调度的指挥官,利用 ReAct(推理-行动循环)机制,自主决定检索次数和工具调用。文中详细展示了如何封装检索工具、执行函数(含权限过滤、混合检索)以及编写多步推理循环代码,实现复杂问题的精准回答。
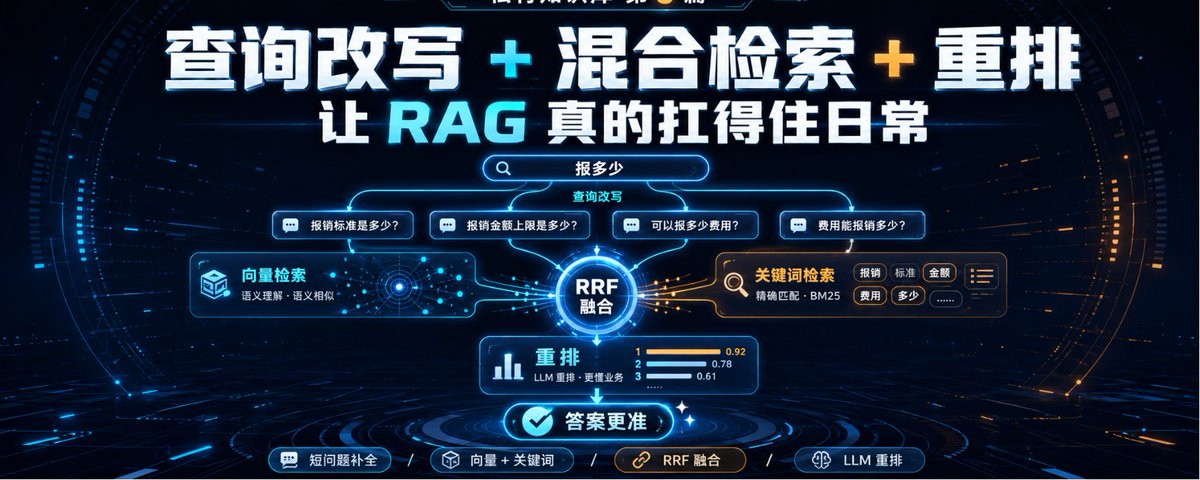
本文是私有知识库构建系列的第 3 篇,旨在解决基础 RAG 系统在短问题召回、关键词匹配及结果排序上的缺陷。作者详细介绍了通过 LLM 进行查询改写以补全上下文,利用 PostgreSQL 结合 Jieba 实现混合检索(向量+BM25),以及使用 RRF 算法融合检索结果,从而显著提升知识库的日常可用性。