Wiki 知识库

全部文档 / 标签: 向量数据库

23 篇
清除

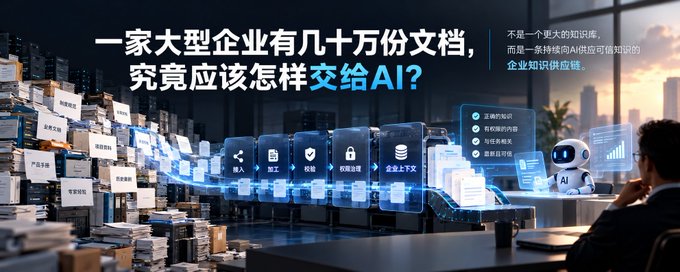
一家大型企业有几十万份文档,究竟应该怎样交给AI?

文章结合为大型国企交付几十万份文档知识库项目的实战经验,指出将文档导入知识库只是最容易的一步,真正难点在于知识分散在OA、ERP、CRM等多个系统中、文档质量参差不齐、版本与权限管理复杂、以及上线后的持续运营。作者提出企业真正需要的不是一个'AI知识仓库',而是一条具备知识工程能力的企业知识供应链:通过Connector持续接入知识,经解析、清洗、结构化等知识工程加工后准入,并以检索前权限过滤保障安全,最终在Agent时代构建企业上下文层,让正确的知识在正确的时间以正确的权限交给AI。

技术 › LLM 土猛的员外 2026-10-0925.8 KB 3.1K 12 83

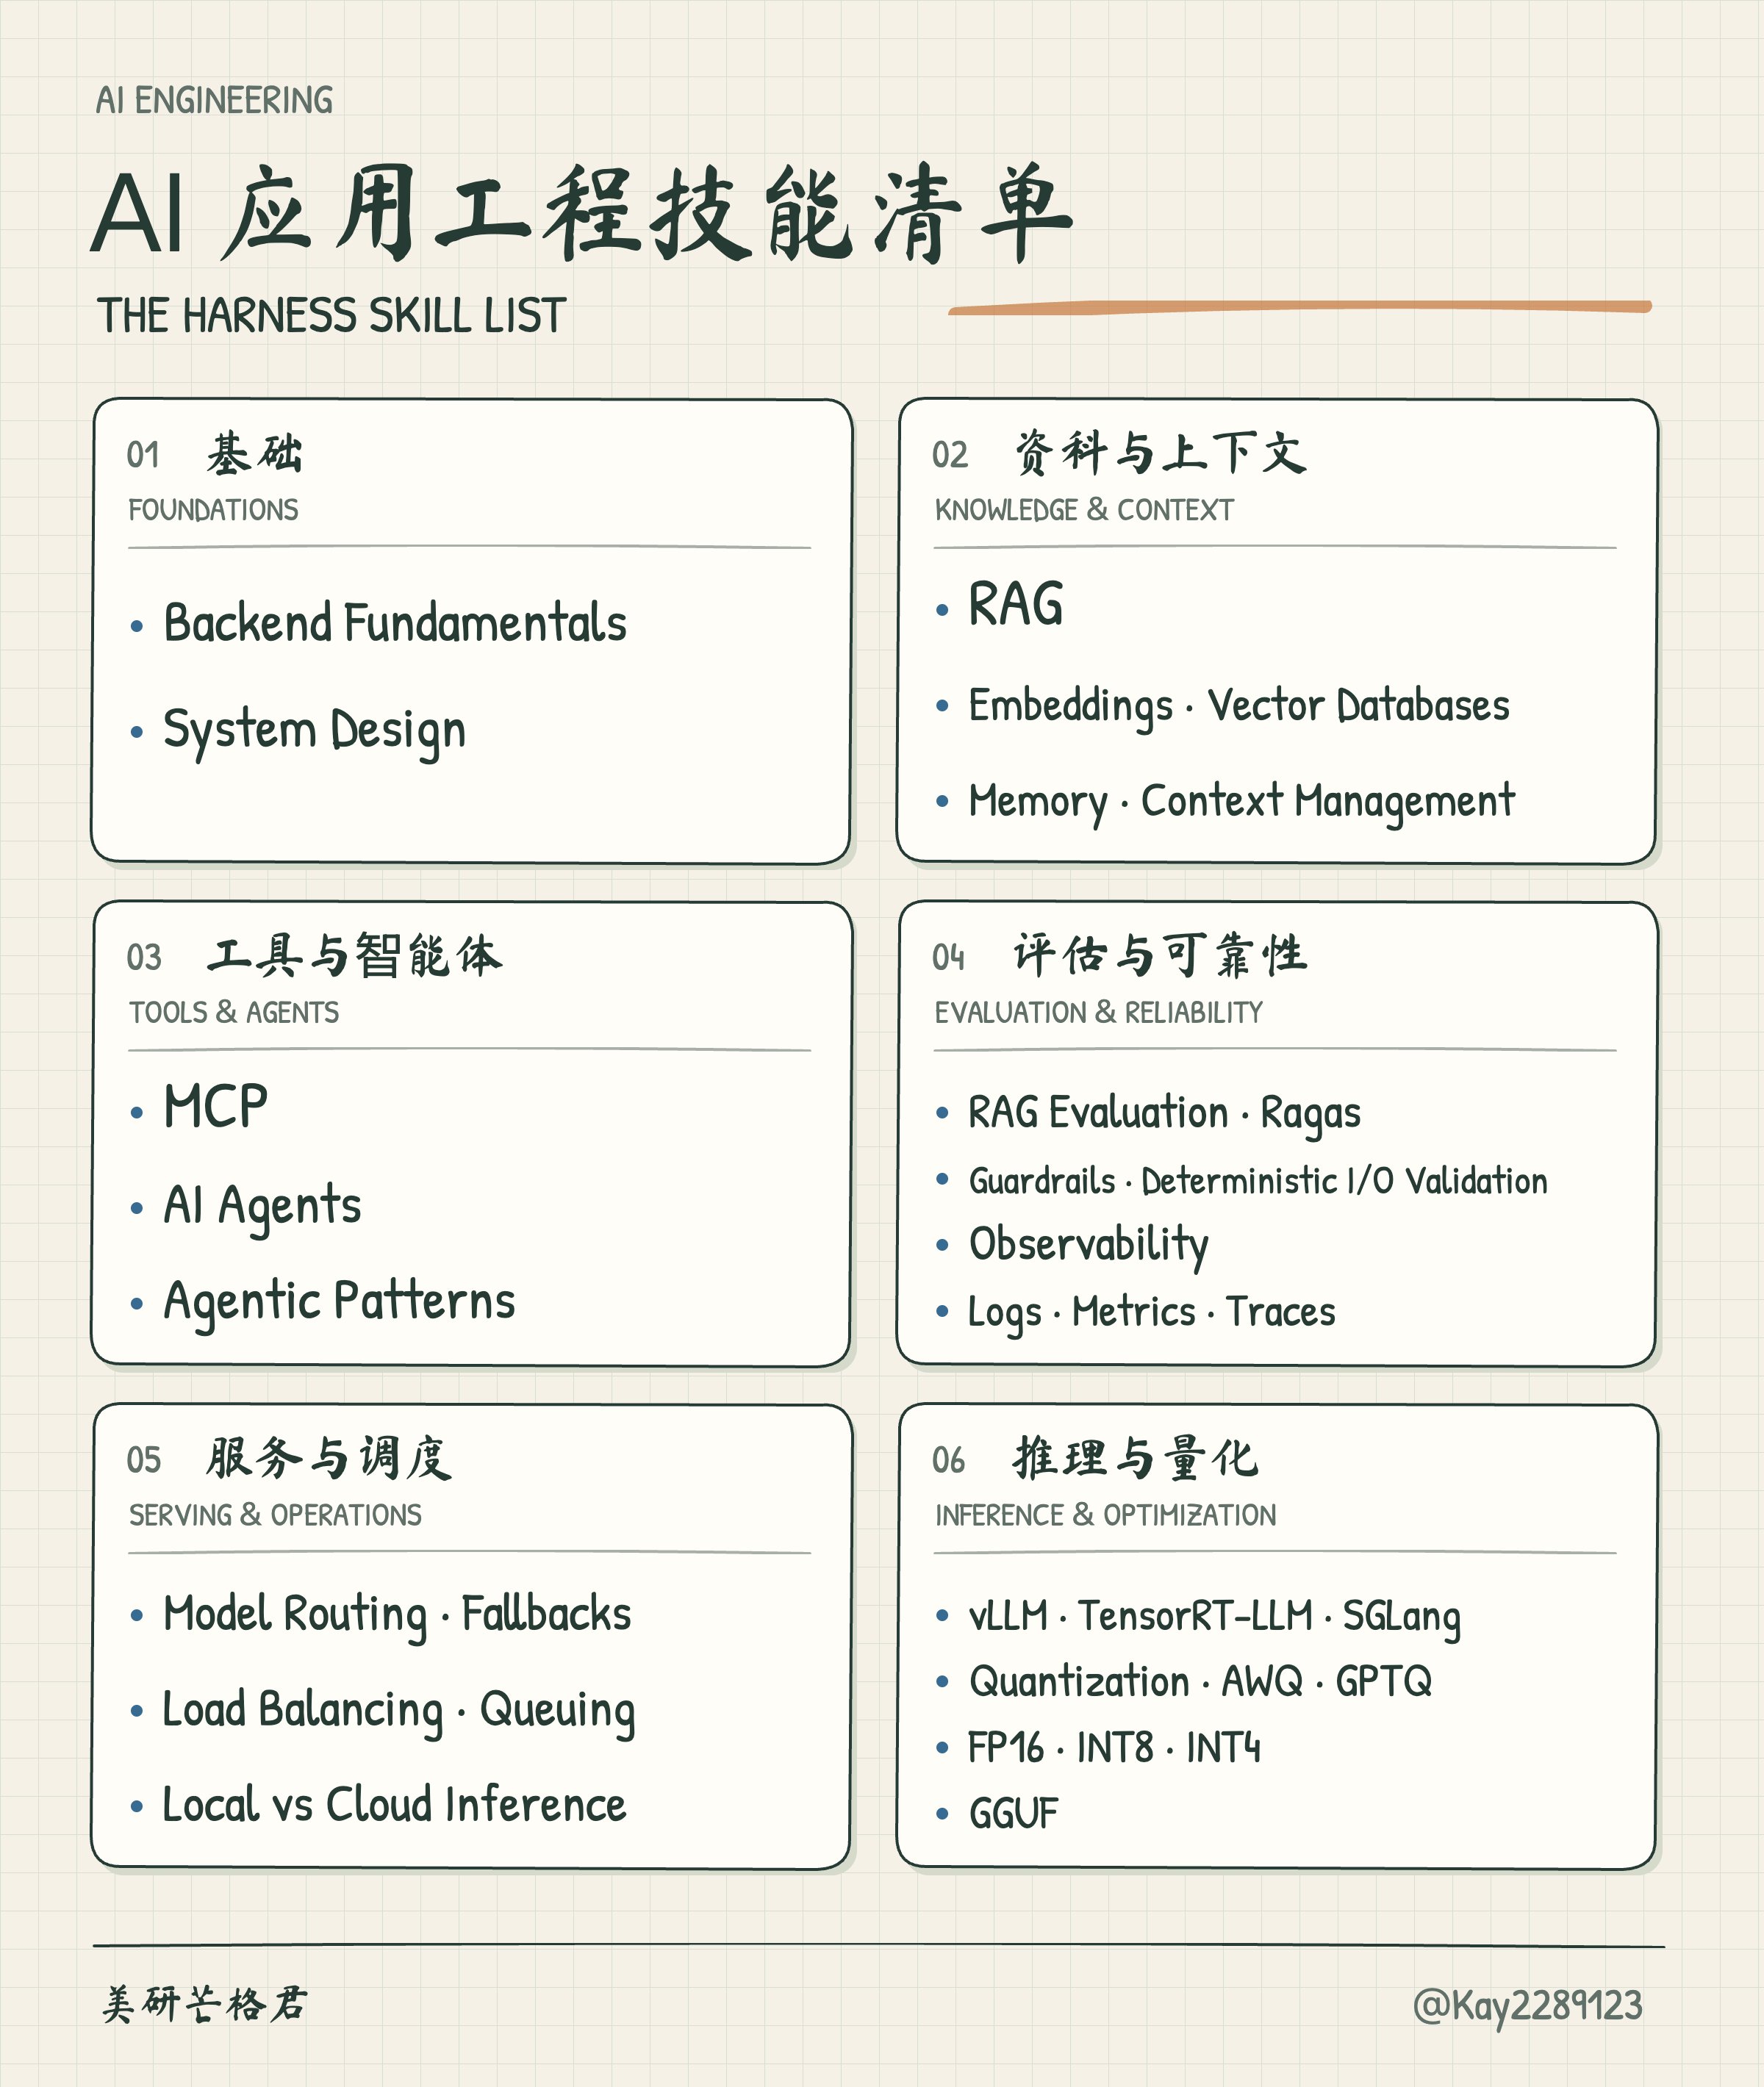
如果你想做 AI 应用不妨考虑一下 Harness 开发

作者结合实际工作经验,整理出一份 AI Harness 开发的 11 条技能清单,涵盖后端与系统设计、RAG 与向量数据库、记忆与上下文管理、工具调用与 MCP、Agent 编排、护栏校验、评测、可观测性、模型路由降级、排队负载均衡以及推理部署引擎。作者指出 Harness 开发是硅谷热门方向(如 YC Demo Day 上大量项目),建议普通开发者从 AI 应用入手,把模型接入具体业务,并给出将清单交给 AI 逐项学习的 prompt 方法。
我给 DeepSeek Harness 做了个 zvec-grep 插件,实现基于语义的高效文本检索工具

作者基于阿里巴巴开源的进程内向量数据库 zvec 及面向代码仓库的语义检索工具 zvec-grep,开发了一个 DeepSeek Harness(DSH)插件 dsh-zvec-grep。文章是开发笔记,先通过真实仓库实验确认语义搜索的价值:在不知道代码命名时提供更好的“第一跳”,与 rg 精确搜索形成互补。插件没有简单包装 CLI,而是直接使用 createZvecGrep() 引擎 API,以 workspace 为运行时边界共享索引与 watcher,实现自动索引、增量更新与每小时校准,并通过状态胶囊向用户暴露索引进度与错误,退出时用 AbortController 清理资源。作者总结插件设计理念:替用户承担复杂度,暴露不确定性,让语义搜索负责模糊发现、精确搜索负责已知匹配。

技术 › Agent VerySmallWoods 2026-09-0713.7 KB 4.6K 24 82

How to Build Agent Memory: Where Does Knowledge Live?

本文是 Agent 记忆系列文章的第二篇,探讨知识的存储位置与表示形式。作者将记忆拆解为表示与存储、提取、检索、维护四个环节,重点讨论第一个问题:知识存放在哪里。文章指出表示(知识形态)与物理存储是两个独立决策,文件系统因编程代理擅长 bash 而成为极佳起点。作者提出应区分“产物”(发生过的记录)与“知识”(当前应相信的事实),知识应像物化视图一样回指来源产物。知识会过时,需要版本控制、分支与合并机制;且知识应被视为缓存而非全量存储,因为维护成本高昂。

技术 › Agent Devin Stein 2026-09-0111.3 KB 5.9K 86 81

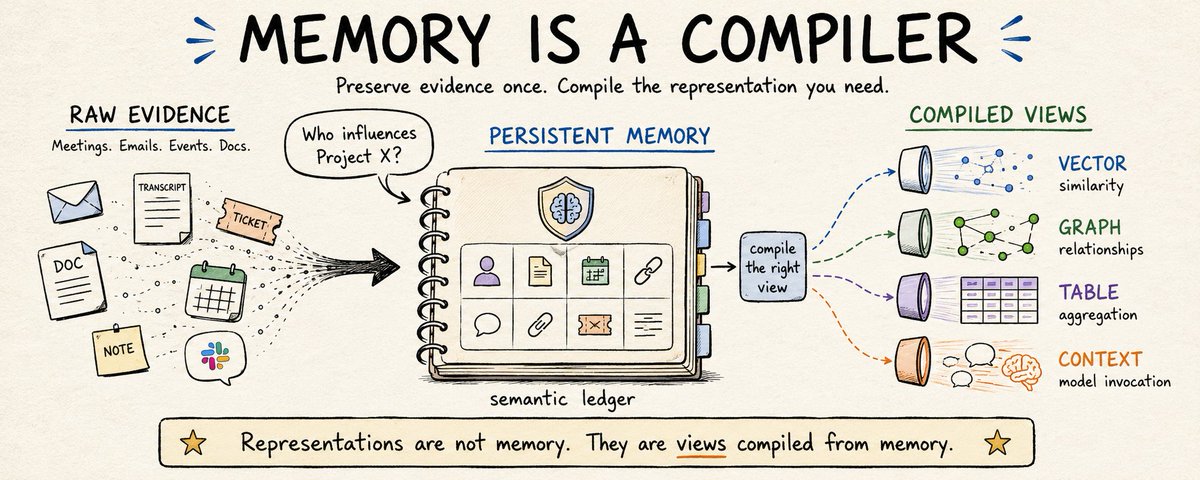
Memory Is a Compiler:记忆是一个编译器

作者通过一次融资会议记忆被重新解读的经历,指出记忆的本质不是固定表示,而是一个持久系统:保留过去的证据,并随新证据不断重新编译其意义。文章批评将向量数据库、知识图谱、上下文窗口等当作记忆的常见误解,认为它们只是从记忆编译出的临时表示。作者提出记忆编译产生三类产物:状态(按序折叠事件得到)、检索(查找相关证据的工具)和上下文(为单次调用组装的有界视图),并类比编译器的中间表示(IR),指出每种表示只适合特定操作,记忆本身应是唯一不可丢弃的持久层。

技术 › LLM Ashwin Gopinath 2026-09-0114.7 KB 9K 109 72

开源|我给 DeepSeek Harness 接入了 Milvus

作者为爆火的 DeepSeek Harness(DSH)开发了 Milvus 向量数据库插件 dsh-milvus 并开源。文章解析了 DSH 'Everything is a Plugin' 的微内核架构价值,说明为何将 Milvus 集成做成 Plugin 而非 Skill:Plugin 可硬性限制执行边界(如只读操作、limit 上限),避免模型幻觉带来的风险。文中还给出从 Docker 启动 Milvus、安装 DSH CLI 与插件、配置 Profile 到让 Agent 完成列表、Schema 描述、Scalar Query 和语义搜索的完整实战教程。

技术 › Harness Engineering 尹珉 2026-08-2510.9 KB 1.7K 2 82

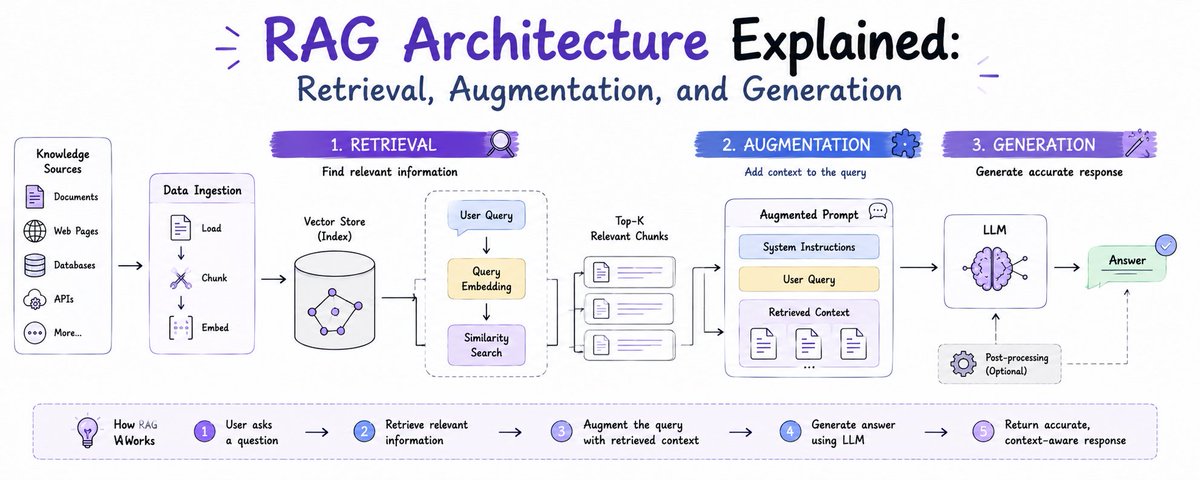
RAG架构详解:检索、增强与生成

本文深入解析了生产级RAG(检索增强生成)系统的完整架构。文章首先指出LLM的局限性——无法访问私有数据,而RAG通过外部知识检索来弥补这一缺陷。然后详细介绍了系统的两大核心平面:知识平面(离线索引)和运行时平面(在线问答)。知识平面涵盖数据源、解析-分块-嵌入流水线以及向量索引;运行时平面则描述了用户查询、检索重排、LLM生成和答案引用的完整流程。文章还逐步拆解了查询生命周期,包括查询嵌入、Top-K检索、重排增强和生成,并强调了监控指标的重要性。

技术 › LLM Vikas gupta 2026-08-2020.4 KB 260.7K 69 73

Best Open-Source Agent Memory Systems (Self-Hosted, 2026)

本文深入比较了2026年可自托管的开源AI代理记忆系统,包括Mem0、Cognee、Graphiti/Zep、Letta和Hindsight。文章强调开源与可自托管并非同义,并提出了五个评估维度:检索准确性、自托管现实、功能对等性、许可证和架构。通过公开基准测试和实际部署要求,作者揭示了各系统的真实优劣,特别指出Mem0社区最大但基准测试饱和,Graphiti擅长时间推理但需外部图数据库,Hindsight在准确性和部署简便性上领先。文章旨在帮助读者根据自身需求选择最合适的记忆层系统。

技术 › LLM Vectorize 2026-08-1215.1 KB 943 17 83

重新理解企业 RAG:从知识工程到 AI 基础设施

本文指出企业级 RAG 绝不仅是简单的文档切块与向量检索,而是一项复杂的知识工程。文章详细拆解了知识入库与用户提问两条流水线,强调了 PDF 结构化解析、混合搜索及权限更新的重要性。在 AI Coding 时代,底层代码可交由 Agent 完成,开发者应更关注 RAG 的架构设计。最终,企业 RAG 的核心价值在于构建一层可被 AI 调用的知识基础设施,从而支撑各类业务 Agent。

技术 › LLM Builder (@UPing123zzz) 2026-08-103.6 KB 71

Understanding HNSW: The Engine Behind Fast Vector Search

本文深入解析了HNSW(分层可导航小世界)算法,这是现代向量数据库实现快速近似最近邻搜索的核心技术。文章通过邮政分拣的比喻,阐述了HNSW如何结合NSW图结构和跳表的概念,利用分层结构从粗糙到精细地快速定位目标,并详细说明了向量搜索和插入的具体流程。

技术 › 数据库 achal 2026-07-3012.6 KB 5.3K 67

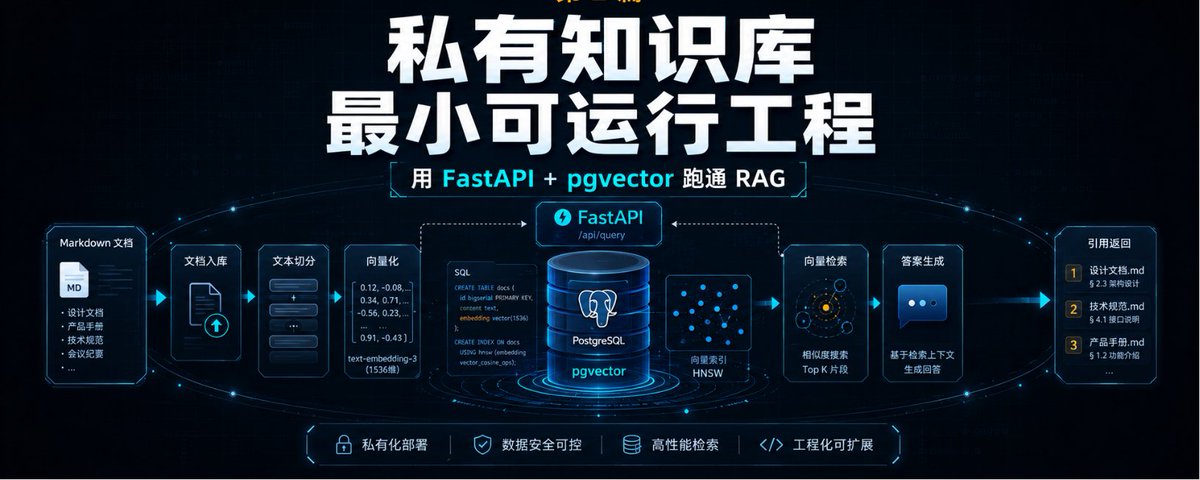
用 FastAPI + pgvector 跑通最小可运行私有知识库

本文是一份实战教程,指导读者从零搭建一套最小可运行的 RAG(检索增强生成)私有知识库。技术栈采用 FastAPI 作为接口框架,PostgreSQL 配合 pgvector 扩展进行向量存储,并调用通义千问(Qwen)模型与 Embedding 服务。文章详细讲解了项目结构、依赖配置、数据库模型定义以及文档入库的完整代码实现,旨在构建一个可落地的工程底座。

技术 › 后端 A Ando 2026-07-0822.2 KB

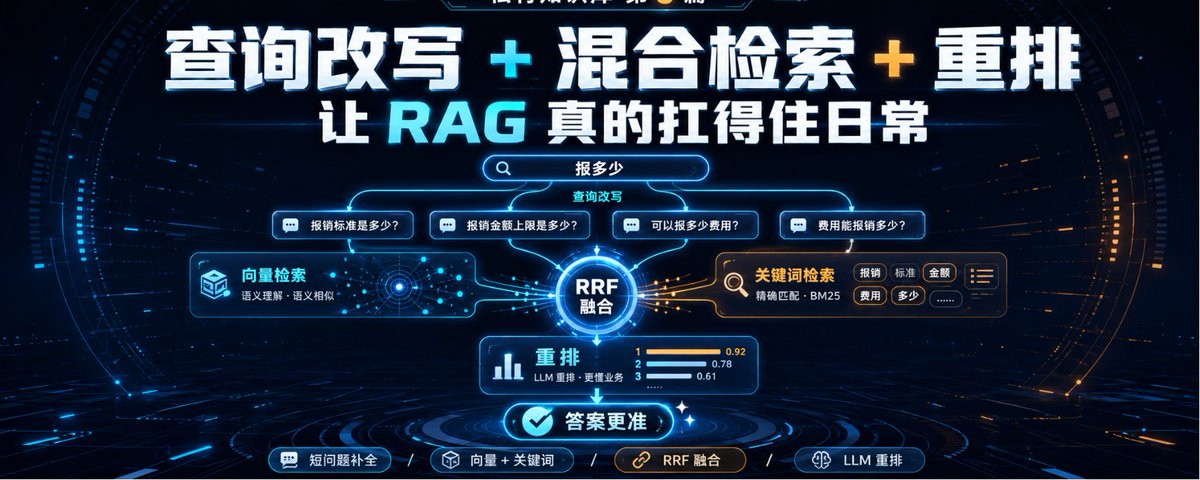
私有知识库实战:查询改写、混合检索与重排优化 RAG

本文是私有知识库构建系列的第 3 篇,旨在解决基础 RAG 系统在短问题召回、关键词匹配及结果排序上的缺陷。作者详细介绍了通过 LLM 进行查询改写以补全上下文,利用 PostgreSQL 结合 Jieba 实现混合检索(向量+BM25),以及使用 RRF 算法融合检索结果,从而显著提升知识库的日常可用性。

技术 › LLM A Ando 2026-07-0821.2 KB

阿里开源 Zvec:像 SQLite 一样极简的嵌入式向量数据库

阿里开源了一款名为 Zvec 的向量数据库项目,主打“纯本地、内嵌式”极简体验,号称向量界的 SQLite。该项目基于 C++ 编写,支持零配置安装,性能强悍(毫秒级搜索数十亿向量),同时兼容稠密、稀疏向量及全文检索。它非常适合本地大模型、RAG 和个人知识库开发,彻底免去了部署繁琐的后端向量服务。

技术 › 后端 智享 2026-07-082.1 KB

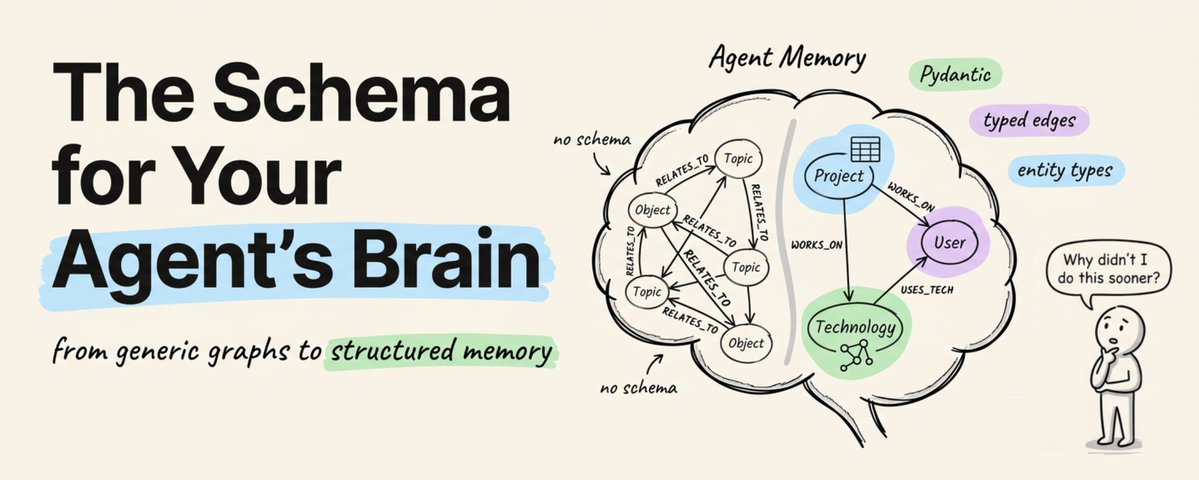
Pydantic fixed my Agent's Memory

文章探讨了如何解决 AI Agent 记忆系统的多跳推理问题。传统的向量数据库在处理跨块事实连接时失效,而通用知识图谱常因缺乏结构导致查询噪音。作者提出的解决方案是使用 Pydantic 提前定义本体(Schema),明确实体类型、关系和属性。通过 Zep 框架强制执行这些约束,可以显著提升提取的准确性和数据的可查询性,从而实现有效的多跳推理。

技术 › Agent Akshay 2026-05-2612.5 KB 312.9K 567 80

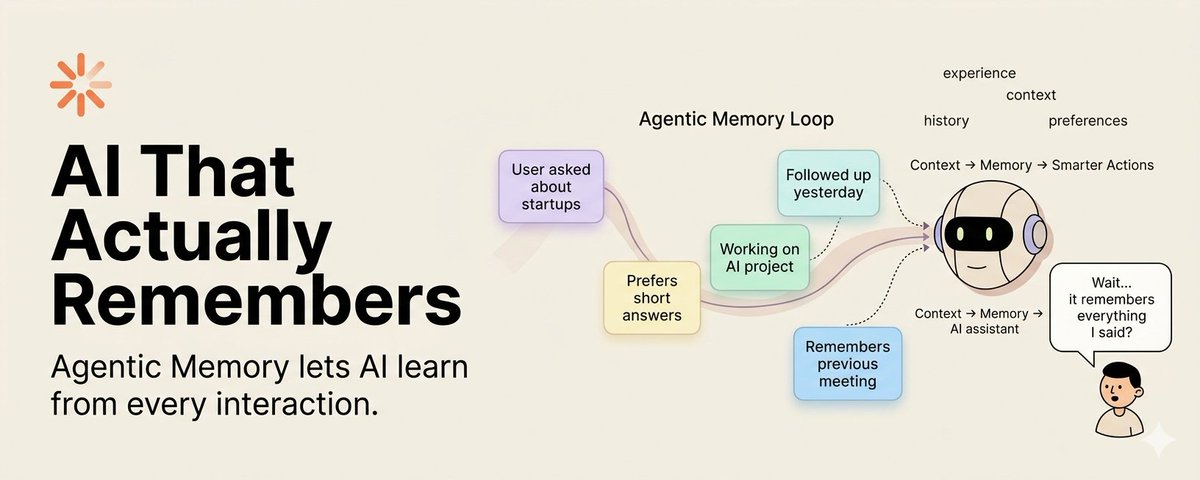
Agentic Memory: 详解 Agent 记忆系统的架构与实现

文章通过生动的类比,指出缺乏记忆是当前 LLM Agent 的主要短板。作者详细拆解了 Agent 记忆系统的三个核心功能:连续性、上下文和学习。文章重点介绍了四种记忆类型:上下文记忆、外部记忆、情景记忆和参数记忆,并深入探讨了如何通过检索增强(RAG)和反思循环来构建持久的智能。

技术 › Agent Ramakrishna (techwith_ram) 2026-05-1744.2 KB 274.6K 630 81

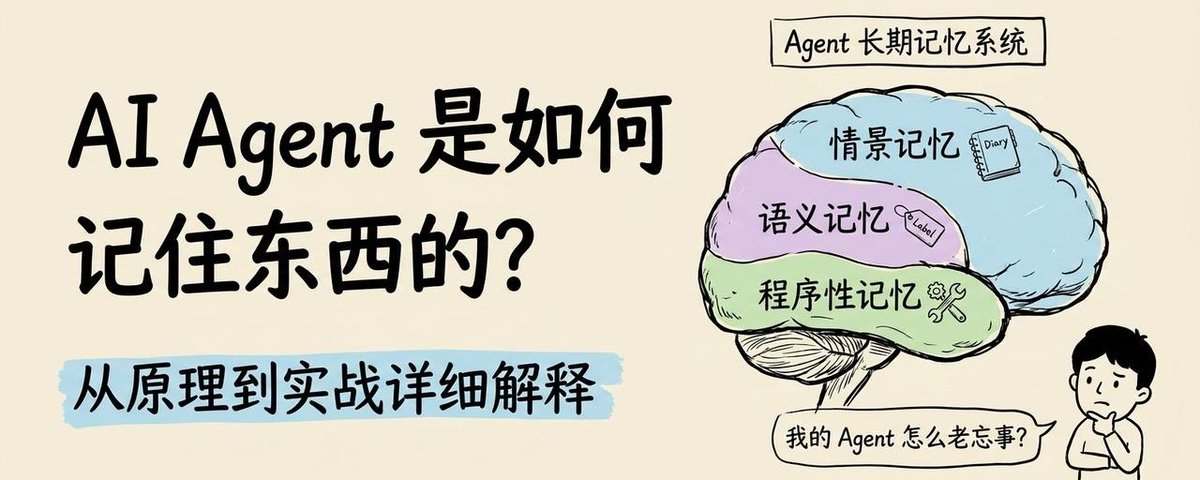
AI Agent 记忆机制原理与实战解析

文章深入浅出地讲解了 AI Agent 记忆系统的工作原理,从基础的单会话与多会话记忆保持切入,引出 Google 提出的情景、语义与程序性记忆三分法。通过对比 OpenClaw 的实现方式与存在的问题,重点剖析了企业级方案 EverOS 的架构。EverOS 将记忆细分为六大类,并通过语义巩固、主动上下文重建等技术优化记忆的抽取、更新与检索。文章还包含 EverOS 的 API 调用示例及 20 个真实落地场景,为开发者提供了 Agent 记忆系统的全景指南。

技术 › Agent 铁锤人 2026-05-1417.0 KB 445.2K 585 84

不做中转,不卖课,如何用 AI 月入 10万

作者分享了今年通过接企业知识库项目实现月入数万的实战经验。文章详细阐述了如何将基础 RAG 升级为企业级 RAG 系统,重点涵盖数据处理层面的文档切分策略(针对 PDF、Excel、代码等)、向量化模型选择及数据库选型;同时深入讲解了检索策略优化,包括长问题处理、混合检索、Rerank 精排及多因素加权排序等技术细节。

技术 › LLM M Miles. 2026-05-1226.8 KB 91

非向量 RAG 框架 PageIndex:用 LLM 推理替代 Embedding

文章介绍了 VectifyAI 开源的 PageIndex 框架,这是一种不使用向量嵌入的 RAG(检索增强生成)方法。它通过构建文档的层次树结构,利用 LLM 的推理能力来精确定位答案页面。该框架在 GitHub 获得了超过 2.9 万星,其构建的 Mafin 2.5 在金融问答基准测试中取得了 98.7% 的高准确率。

技术 › LLM AlphaSignal AI 2026-05-0811.9 KB 11.3K 165 87

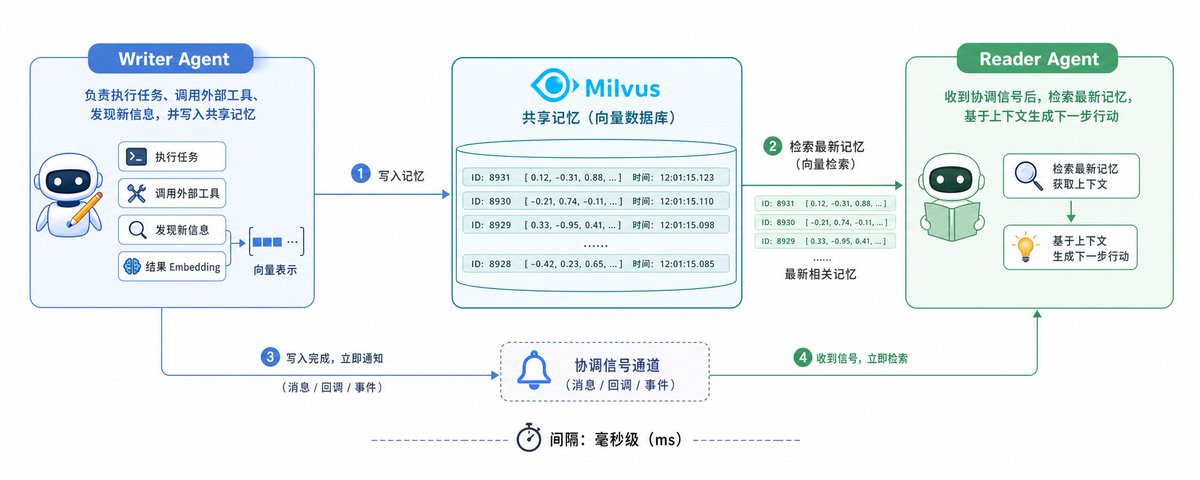
多Agent场景下数据读写不同步的解决方案

本文探讨了在多Agent系统中,子Agent之间数据读写不同步的问题。根本原因在于单Agent场景设计的默认数据库一致性配置(如Milvus的Bounded级别)无法满足多Agent毫秒级的读写需求。文章详细解释了Milvus的写入机制和四档一致性级别,并通过实验证明将一致性级别从默认的Bounded切换为Strong可以有效解决“写后读空”的问题。

技术 › Agent 尹珉 2026-05-0715.4 KB 9.1K 66 83

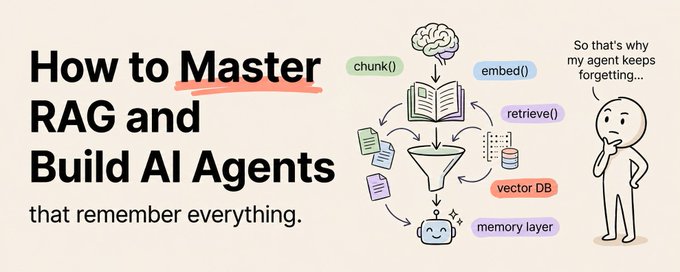
如何精通 RAG 并构建拥有完美记忆的 AI Agent (全流程教程)

本文是一篇关于检索增强生成(RAG)技术的完整教程。文章指出,大多数 AI Agent 难以落地的原因在于模型无法获取企业私有数据。RAG 通过将外部知识库与大模型结合,解决了这一痛点。作者详细拆解了构建 RAG 系统的五个核心阶段:文档摄取与分块、文本嵌入、向量存储、信息检索以及最终生成,并提供了关于分块策略、嵌入模型选择及混合检索的实战建议。

技术 › LLM Khairallah AL-Awady 2026-05-0113.7 KB 191.9K 662 78

Meet Scout: 开源的企业级上下文代理

本文介绍了 Scout,一个开源的企业级“上下文代理”(Company Brain)。针对现有方案将所有数据存入向量数据库导致索引过时的问题,Scout 提出了“导航优于搜索”的理念,通过 Context Providers 连接 Slack、Google Drive 等实时数据源,像操作文件系统一样导航信息。它还能动态构建 Wiki 和 CRM,并通过持续学习形成闭环。

技术 › Agent Ashpreet Bedi 2026-04-2911.2 KB 169K 1.3K 82

AI 记忆工具两大阵营:Memory Backends 与 Context Substrates

文章深入分析了 GitHub 上的 AI Agent 记忆工具,将其分为两大阵营:一是“记忆后端”,如 Mem0 和 Supermemory,主要提取事实并存储于向量数据库;二是“上下文基底”,如 OpenClaw,通过人类可读的结构化文件让会话在上下文中累积。作者指出,虽然 Camp 1 主导了市场,但 Camp 2 的架构才是支持连续、多会话工作的未来方向,例如 Zep 已开始从“记忆”转型为“上下文工程”。

技术 › Agent witcheer 2026-04-1725.6 KB 96.3K 511 82

12个开源项目,4条技术路线:Agent记忆系统完整选型指南

针对 LLM 无状态导致的“失忆”痛点,文章深入探讨了当前 Agent 记忆系统的四条主流技术路线:纯文件存储、向量数据库+RAG、知识图谱及混合检索。文章梳理了从轻量级 hooks 集成到企业级独立平台的 12 个开源项目,涵盖 claude-memory-compiler、agentmemory、Hermes Agent 等代表性工具,并提供了针对不同用户阶段(新手、个人开发者、团队、企业)的选型建议。作者指出,未来的核心竞争将集中在“如何遗忘”、“保证正确性”和“控制成本”三个维度。

技术 › Agent Jason Zhu 2026-04-099.1 KB 5K 40 88