Wiki 知识库

全部文档 / 作者: Deliriumm (@0xDeliriumm)

2 篇
清除

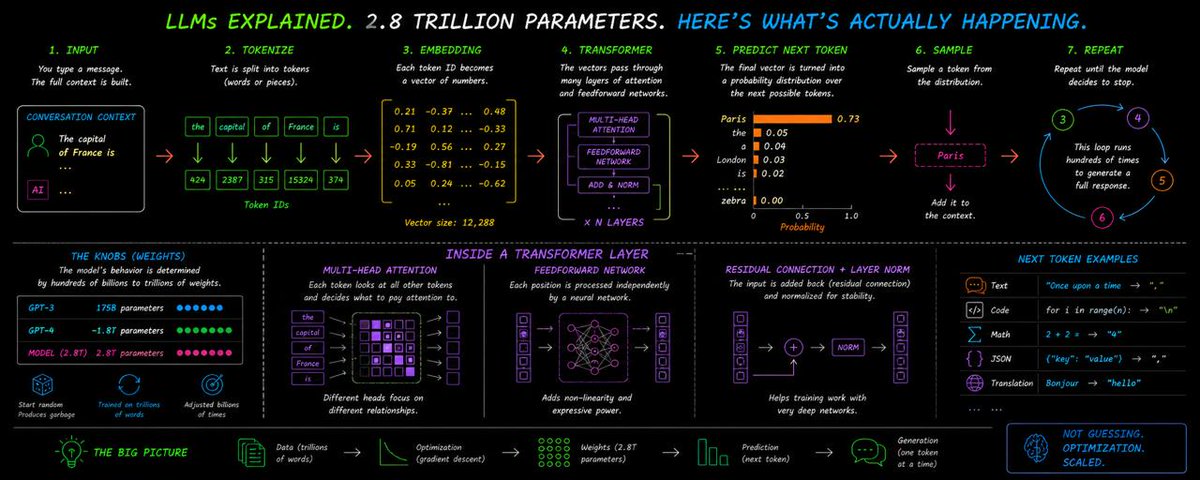
LLMs do not guess. They optimize. Here is the difference and the math behind it

文章阐述LLM的输出并非猜测,而是优化的结果。作者从基础数学概念讲起,介绍了优化问题的本质:找到使函数最大化或最小化的输入。文章系统梳理了几个关键优化方法:牛顿法(通过切线逼近快速求零点和极值,是现代训练算法的祖先)、黄金分割搜索(无需导数、利用黄金比例实现指数级收敛,用于超参数调优)、单纯形法(1947年Dantzig发明,通过沿多面体顶点移动求解线性规划问题)。文章解释了梯度下降作为简化版牛顿法如何训练拥有数万亿参数的语言模型,并对比了单纯形法与内点法在理论与实践性能上的差异。

技术 › LLM Deliriumm 2026-10-0415.0 KB 716.1K 379 65

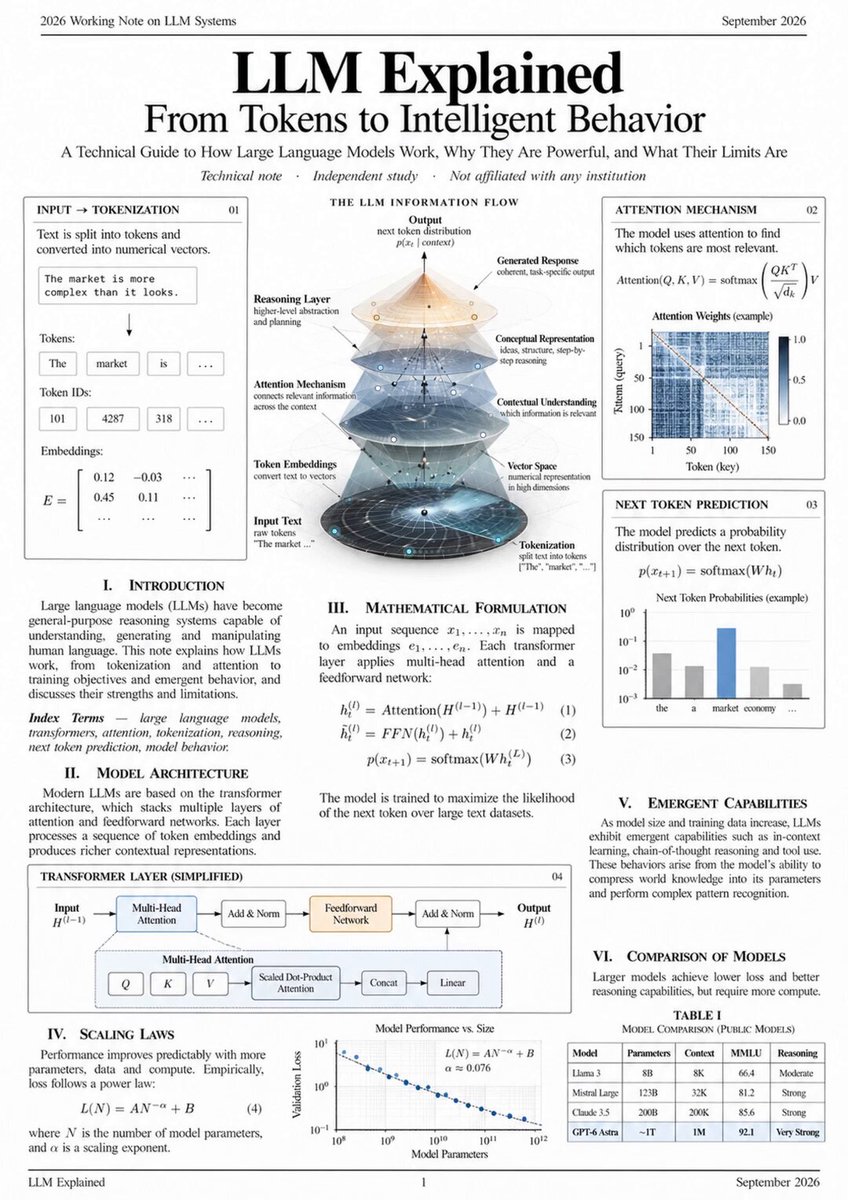
Andrej Karpathy 与 GPT 七年演进:理解 Transformer 与 LLM 架构

文章回顾 Andrej Karpathy 在 OpenAI 七年间见证 GPT 从 1.17 亿参数增长到万亿参数的历程,强调 Transformer 是近 50 年计算领域最重要的架构。内容深入浅出地讲解 LLM 内部机制:文本被切分为 token 并映射为高维嵌入向量,模型通过注意力机制(Q、K、V 矩阵)学习上下文语义;Kaplan 提出的缩放定律证明性能随参数规模可预测提升;大模型还涌现出上下文学习、思维链推理等未显式编程的能力。作者指出 LLM 不是工具而是基础设施,真正赚钱的是理解底层架构并在此基础上构建的人。

技术 › LLM Deliriumm (@0xDeliriumm) 2026-10-043.0 KB 55