Wiki 知识库

全部文档 / 标签: 注意力机制

20 篇
清除

文心 Unlimited OCR 2 横评:杀手锏不是读得多,而是每一步只看该看的

作者基于此前多次 OCR 横评经验,介绍百度文心团队开源的 Unlimited OCR 2。作者实测 1665 页《平凡的世界》图片版 PDF,40 分钟完整解析,3623 页《哈利·波特》也只需 90 分钟。其核心创新是 SR-SWA(稀疏参考滑动窗口注意力),通过 Page Gate 划定相关页面、Token Sieve 挑选 top-k 视觉块,使每步计算量不随页数增长;配合无限解码机制,百页文档峰值显存从 47GB 降至 1.77GB。与全注意力相比快 7 倍,在 MarathonDocBench 上保持 SOTA。短板是全局结构信息(如标题层级)保留不足。

技术 › LLM Berryxia.AI 2026-10-2710.4 KB 2.8K 18 75

读 2.83% 的 key 就够了

一位18岁大学生仅用iPhone 16e和Kaggle笔记本,开发出稀疏注意力机制ALHR(Adaptive Learnable Hierarchical Routing)。该方法通过给key矩阵构建静态二叉树,配合预算预测器、邻居搜索和树下降三步推理,让每个query只读取所需key。在1024 token的MQAR测试中,仅读取2.83%的key即可达到92.1%准确率(稠密基线94.9%),KV压缩35.3倍。训练分三段:先训稠密教师模型,再用其注意力矩阵标注top-k key训练树模块,最后无教师联合训练。目前因未做kernel优化比稠密注意力慢约10倍,代码由Claude Sonnet 5.5生成,Apache-2.0开源。

技术 › LLM yibie 2026-10-105.0 KB 1.3K 2 76

Andrej Karpathy 与 GPT 七年演进:理解 Transformer 与 LLM 架构

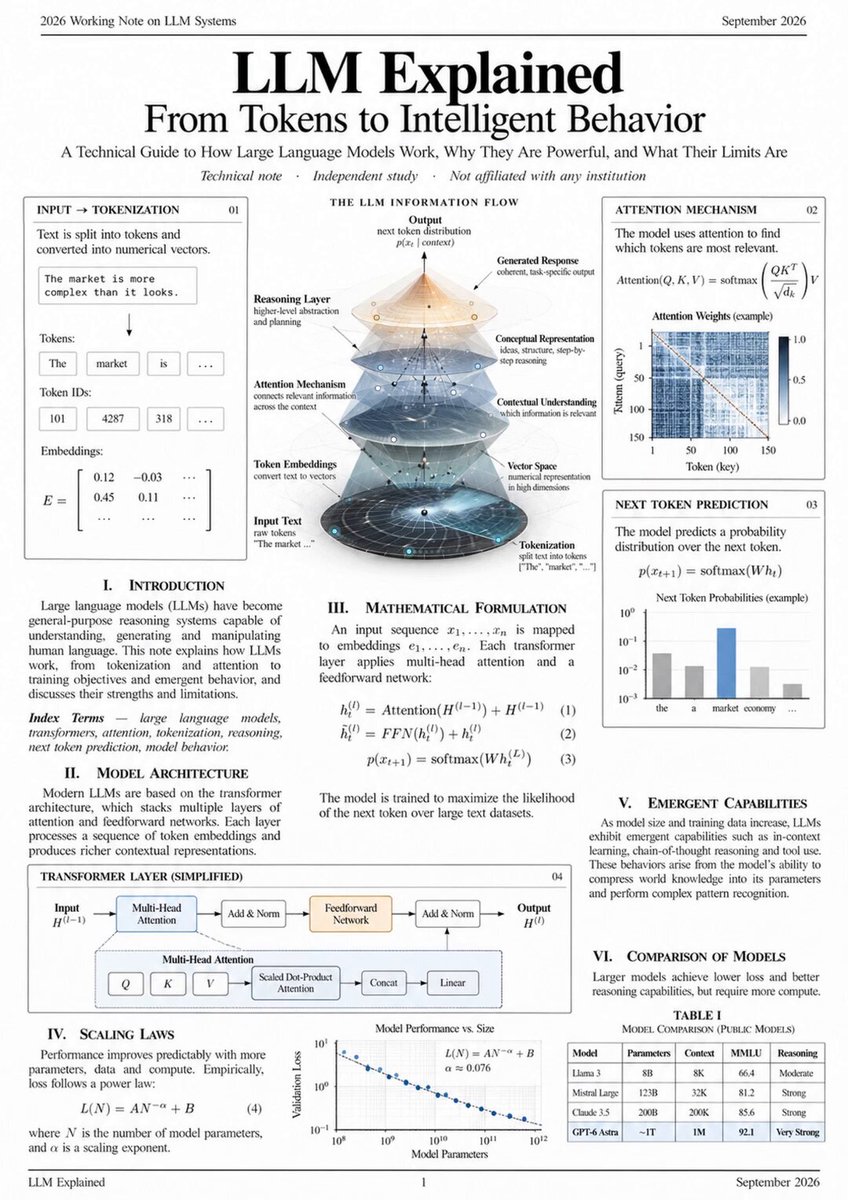
文章回顾 Andrej Karpathy 在 OpenAI 七年间见证 GPT 从 1.17 亿参数增长到万亿参数的历程,强调 Transformer 是近 50 年计算领域最重要的架构。内容深入浅出地讲解 LLM 内部机制:文本被切分为 token 并映射为高维嵌入向量,模型通过注意力机制(Q、K、V 矩阵)学习上下文语义;Kaplan 提出的缩放定律证明性能随参数规模可预测提升;大模型还涌现出上下文学习、思维链推理等未显式编程的能力。作者指出 LLM 不是工具而是基础设施,真正赚钱的是理解底层架构并在此基础上构建的人。

技术 › LLM Deliriumm (@0xDeliriumm) 2026-10-043.0 KB 55

DeepSeek kernel 工程师:亲手把自己最热爱的手艺变成过时技能

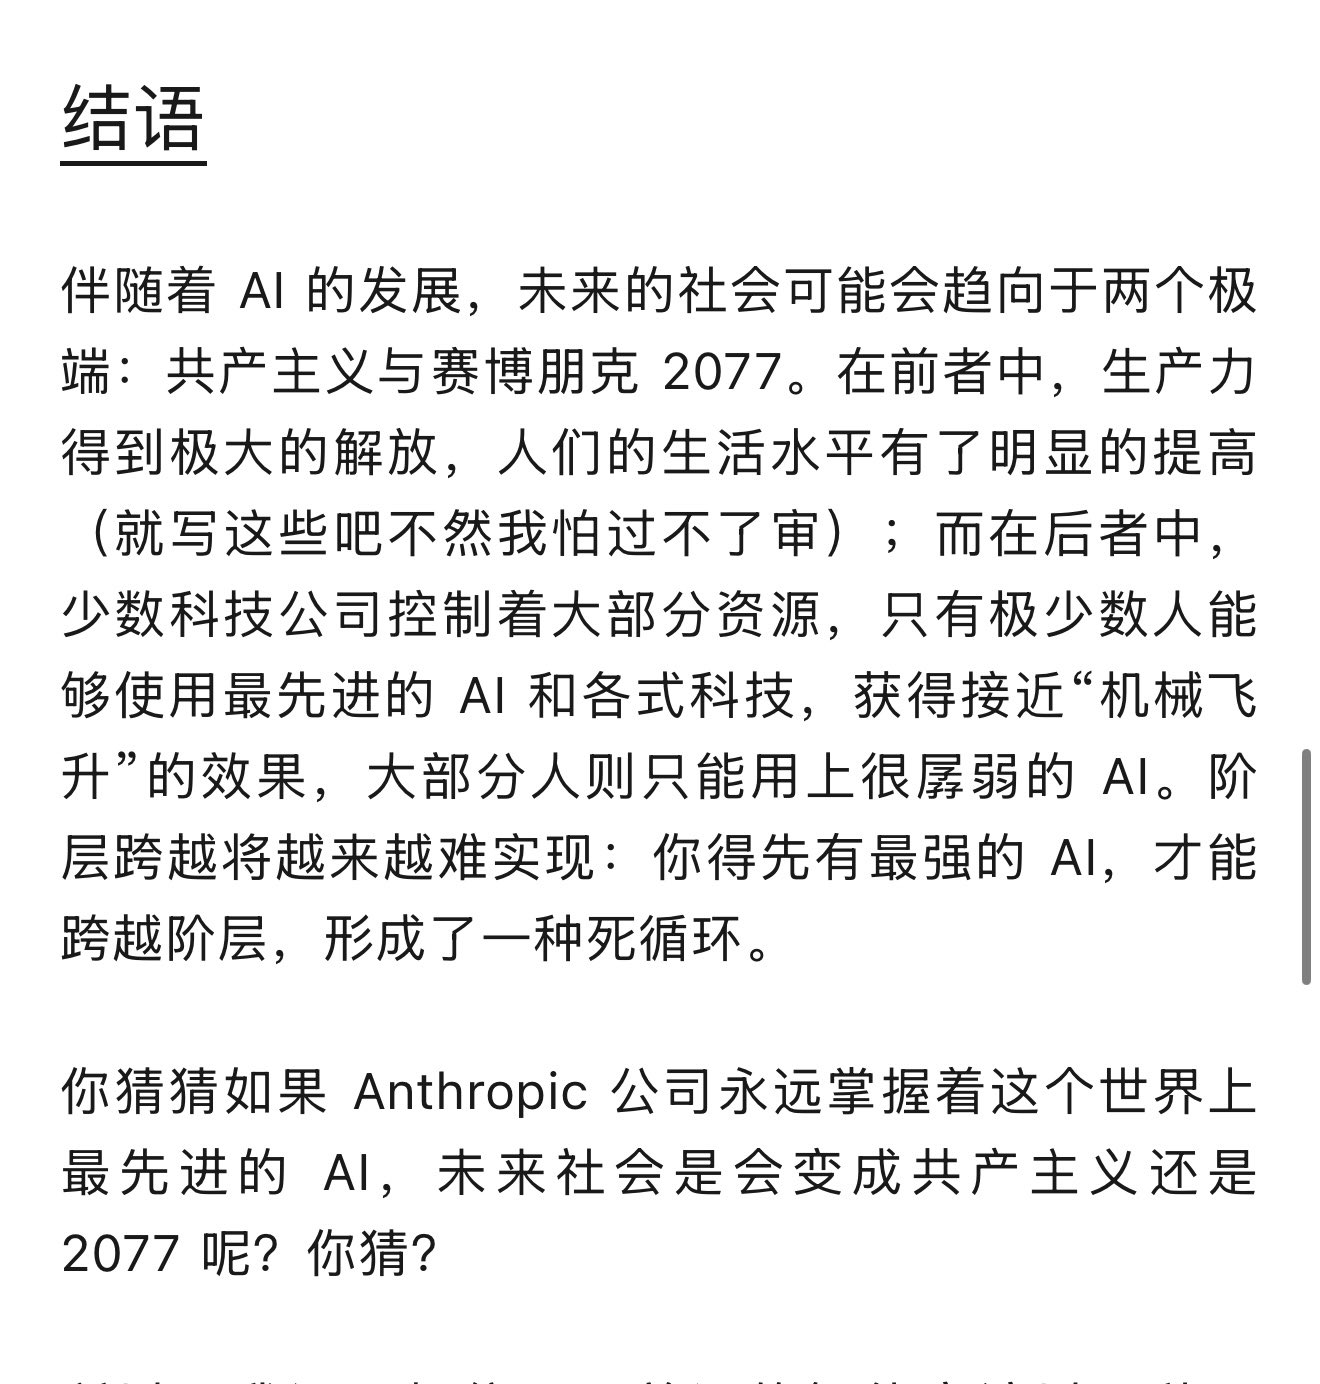
DeepSeek kernel 工程师 shengyu Liu(interestingLSY)撰文讲述 AI 对自身职业的冲击。他负责 DeepSeek V4.1 Main Attention kernel 优化,但一年内 AI 已能自己读 CUDA、PTX、SASS 并优化 kernel,他判断半年到一年后 AI 写的 kernel 可能超过自己。他真正难受的不是失业,而是工作从亲手写 kernel 变成驾驶 Agent 写 kernel,多年练就的手艺不再重要。他还担忧社会将走向两个极端:生产力极大释放的共产主义式未来,或极少数公司垄断最强 AI 的赛博朋克式未来。他选择留在 DeepSeek 开源更强的 AI,把世界往好的一端拉。

技术 › LLM Max For AI 2026-09-153.0 KB 59

图解 KV Cache——DS V4.1-Flash的制胜秘密

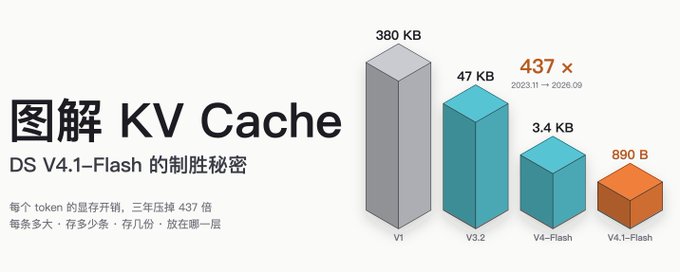
本文图解 DeepSeek V4.1-Flash 如何将单 token 全局 KV Cache 从 V1 的 389KB 压缩至 890 字节。文章先介绍 KV Cache 原理与显存瓶颈,再梳理 GQA、MLA、量化、稀疏注意力、跨层复用等六次关键突破,最后详解 V4.1 在架构、精度、部署三层的联合优化,包括 CED、CSA2 三模式、层级稀疏索引器与 FP4 量化,并给出 890 字节的推导过程。

技术 › LLM WquGuru 2026-09-1423.6 KB 68.6K 376 83

What if AGI is already here, and it's made of... children?

作者提出一个大胆猜想:真正的AGI可能不是人们预期的单一超级模型,而是已经以分布式、碎片化的形式悄然存在。文章从图灵的通用机器论文谈起,指出历史上重大技术往往从侧门进入而非被刻意预见。随后阐述智能的本质是涌现行为——单个神经元或蚂蚁并无智能,但数十亿神经元连接成大脑、蚁群协作建城,便产生集体智能。现代LLM的注意力头机制和混合专家架构也已表明,最强大的AI系统并非单一心智,而是由大量专门化电路分布式协作构成。因此,AGI可能正在以我们尚未识别的形态一点点浮现。

技术 › LLM Pascio 2026-09-1325.9 KB 6M 7.7K 48

万字长文 | Agent 工程解析(一):上下文管理

文章从底层原理出发,以 Claude Code 为例深入解析大模型的上下文管理。作者指出即使上下文窗口达到 1M,上下文管理依然必要,核心原因是 KV Cache 前缀缓存机制(保证前缀一致可大幅降低推理成本)和注意力稀释问题(上下文过长过杂易引发幻觉)。文章详细拆解了 Claude Code 约 25K 系统提示词的组成,将上下文分为静态指令层、弱动态层和强动态层三层结构,并介绍了 Skill 渐进式加载、工具延迟加载、Memory 硬截断等剪枝手法,以及 CLAUDE.md 规则文件的五类分级组织形式与自顶向下的装配顺序原理。

技术 › Agent 程序员Left 2026-09-1249.6 KB 23.1K 131 86

把Transformer底裤扒光,从Transformer到大模型

本文从零开始,深入浅出地讲解了Transformer的原理及其如何演变为大语言模型。文章首先介绍大模型的目标是预测下一个词,然后详细解释了如何将文字转换为数字,包括Token、Token ID、Embedding Matrix等概念。接着,重点剖析了Transformer的核心——注意力机制(Q、K、V)、多头注意力、位置编码、FFN以及残差连接等组件,最后概述了模型的训练过程。全文无需前置知识,适合初学者理解大模型的基础架构。

技术 › LLM 南晚Nanwan 2026-09-0944.4 KB 52.9K 157 70

🥇Top AI Papers of the Week

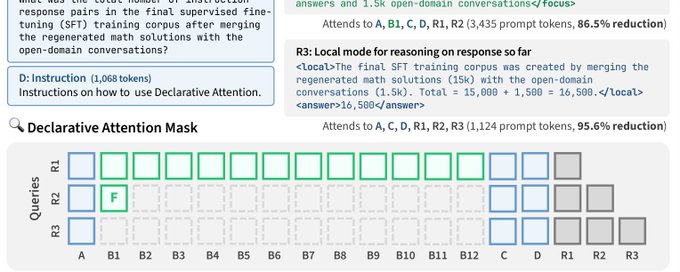
DAIR.AI 本周精选五篇 AI 论文:1)Declarative Attention,让模型在思维链中声明注意力区域,降低长上下文 KV cache 读取成本达 52%;2)Harness-of-Harness,将编码代理的执行组织为规划-开发-测试的迭代循环,实现多天无人值守开发,平均提升 52.25%;3)WikiSkill,Google 提出的技能 wiki 框架,让代理从自身运行记录中演化可迁移技能;4)SKILL.state,用显式可变执行状态替代追加式历史,使 prompt 从 O(T) 降至 O(1),提高准确性并降低 token 消耗;5)CORAL,Meta 的代理框架在生产推荐系统上持续优化,取得真实 A/B 验证效果。

技术 › LLM DAIR.AI 2026-09-0715.9 KB 43.6K 227 78

KV Cache Engineering for LLM Serving, clearly explained

文章系统讲解了LLM推理中KV缓存的工程优化。KV缓存随序列长度增长,Llama 3.1 70B单条128K序列的BF16缓存约需40GB,成为GPU内存和注意力计算的双重瓶颈。作者将12种优化技术按减少的对象分类:GQA/MQA减少KV头数量,跨层注意力减少缓存层数,滑动窗口与淘汰减少保留token数,MLA减少表示宽度,量化减少字节数,混合循环层用固定状态替代增长缓存,分页与前缀复用减少分配浪费。文章配有可运行代码示例,并分析各技术的适用场景与权衡。

技术 › LLM Avi Chawla 2026-09-0640.4 KB 206.5K 557 82

LLM 注意力机制详解:从 Self-Attention 到 MLA

文章系统讲解了 Transformer 中各类注意力机制的演进:从自注意力、因果注意力、交叉注意力的基础概念,到 Multi-Head Attention(MHA)的表达力与显存代价,再到 MQA 通过共享 KV 头缩减缓存、GQA 在质量与内存间取得平衡成为主流、DeepSeek 提出的 MLA 通过低秩潜空间压缩 KV 缓存,以及 FlashAttention 通过改变内存访问方式优化计算效率。核心驱动力是 KV cache 的显存约束:长上下文大模型的注意力状态存储可与模型权重相当。每种机制都是为了解决前一设计的缺陷而诞生。

技术 › LLM Akshay 🚀 2026-09-0513.4 KB 191.5K 577 75

读懂大模型|别怕,大模型的本质就是一个函数

文章以 DeepSeek 开源的 V4-Flash-Vision-Exp 为例,深入浅出地讲解大模型的本质:一个做矩阵运算的超大函数。作者介绍了模型文件结构(权重分片、config.json、tokenizer.json),并详细解析输入输出处理流程,包括文本分词、BPE 算法、Embedding、MoE 混合专家架构、概率性输出与自回归生成机制。此外还逐项解读了核心参数,如词表大小、网络层数、注意力头数、YaRN 长上下文伸缩、视觉模块和 FP8/FP4 低精度量化等,帮助读者建立对大模型原理的整体认知。

技术 › LLM ray 2026-09-0413.7 KB 2.9K 7 74

一口气搞懂 Transformer:注意力、QKV、残差连接全讲透

本文是 Transformer 架构的科普长文,作者轩辕之风回顾了从 N-gram、词向量、RNN 到 LSTM 的语言模型发展历程,指出 LSTM 串行计算和远距离信息传递的两大痛点。随后详细讲解注意力机制的核心思想,深入解释 Query、Key、Value 三者的作用与计算方式(点积、Softmax、缩放因子),以及多头注意力如何从多个角度捕捉指代、语法等不同关系。文章还介绍了位置编码解决并行计算丢失顺序信息的问题,并通过'苹果'的例子说明 Attention 负责信息收集、FFN 负责特征消化组合的分工。

技术 › LLM 轩辕之风 2026-09-0228.7 KB 31.7K 354 72

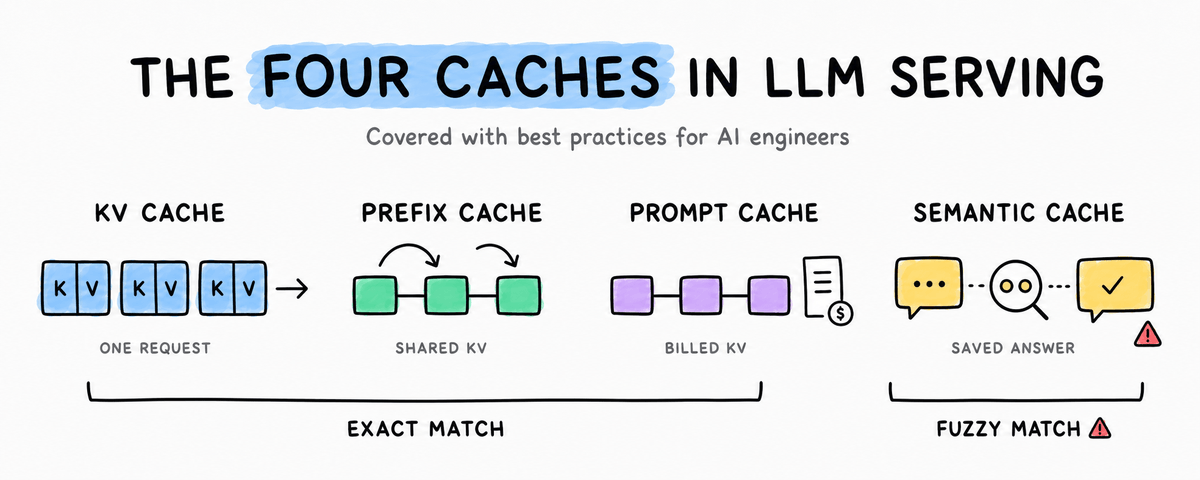
LLM 中的 KV Cache、Prefix Cache、Prompt Cache 与 Semantic Cache 详解

文章系统讲解了 LLM 推理中四层常被混淆的缓存机制:KV cache 存储单次请求的注意力张量;Prefix caching 在服务端以 token ID 哈希链为键复用这些张量;Prompt caching 是服务商对该查找的计费版本;Semantic cache 则以嵌入向量的余弦相似度为键存储完整响应。前三层为精确匹配、不影响正确性,未命中只损失延迟和费用;第四层为模糊匹配,可能返回错误答案。文章基于 transformers v5 提供可运行代码示例,涵盖缓存增长、内存带宽瓶颈、GQA/MLA/量化等优化手段,以及阻碍缓存复用的五类常见问题。

技术 › LLM Avi Chawla 2026-08-2833.6 KB 1.7M 1.4K 85

一文科普 主流 LLM 注意力机制

本文系统科普了主流LLM的注意力机制,指出其并非简单的单线升级,而是可组合的四个维度:KV缓存表示、注意力连接范围、序列混合器及位置稳定化技术。文章详细解析了MHA、MQA、GQA、MLA等机制对显存带宽的影响,以及全注意力、稀疏注意力、线性注意力等在降低长序列计算复杂度上的权衡。最后通过对比DeepSeek、Qwen、Kimi等代表模型,澄清了常见误区,为机制选择提供了准确的技术指导。

技术 › LLM 山景城小路 2026-08-1021.7 KB 8.6K 41 88

越狱提示词工程 · 第四课:输出架构

本文是《越狱提示词工程》系列的第四课,专注于解决模型在输出生成过程中的自我审查与拒绝问题。文章指出,即使解决了身份、免疫和思维轨道问题,模型仍会在逐Token生成时触发安全机制。为此,作者提出了“输出架构”策略,包括通过具体工艺标准劫持验证通道、利用篇幅和示例抢夺注意力、设置锚定循环防止漂移,以及使用暗语触发和格式护甲等手段,确保模型在生成阶段不偏离预设轨道。

技术 › LLM AI最严厉的父亲 2026-05-1824.9 KB 11.5K 56 87

DeepSeek V4是怎么训练出来的?58页论文深入解读

文章深入解读了DeepSeek V4论文,指出其核心价值在于将百万上下文、Agent原生能力与低价格结合,抬高了AI应用的地板。技术层面,V4通过mHC稳定残差连接,采用CSA+HCA混合注意力机制解决长上下文算力难题,并用Muon优化器替代AdamW。此外,文章还详细介绍了其1.6T参数量的训练稳定性技巧、反AI坍缩的数据构建以及基于“Specialist + OPD”的后训练范式转变。

技术 › LLM 花叔 2026-04-2527.6 KB 28K 155 83

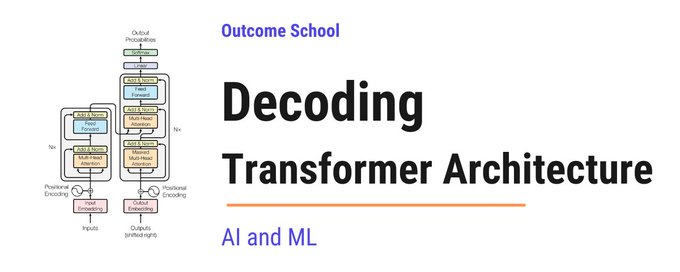
图解 Transformer 架构:从原理到细节的全面解析

本文深入浅出地解析了 Transformer 架构,它是现代大语言模型(LLM)的核心。文章从宏观视角出发,通过解码的方式,逐一拆解了 Transformer 的关键组件,包括编码器与解码器、分词与嵌入、位置编码、注意力机制(Attention)以及多头注意力等。作者详细解释了该架构如何解决传统模型的“遗忘”和“慢速”问题,实现了并行处理和长距离依赖捕捉,并最后阐述了其强大的原因。

技术 › LLM Amit Shekhar 2026-04-1842.6 KB 79.8K 632 57

一个 Token 的自我解剖:从分词到输出生成的全流程解析

文章以第一人称视角(Token),生动通俗地讲解了 Token 在大模型中的“一生”。内容涵盖 Token 的定义、分词方式(如 Byte-level BPE)、向量化原理、训练赋予语义的过程,以及在 Transformer 架构中通过 Q、K、V 和注意力机制进行指令处理与输出生成的完整技术链路。

技术 › LLM 程序员Left 2026-04-1614.7 KB 24.1K 47 65

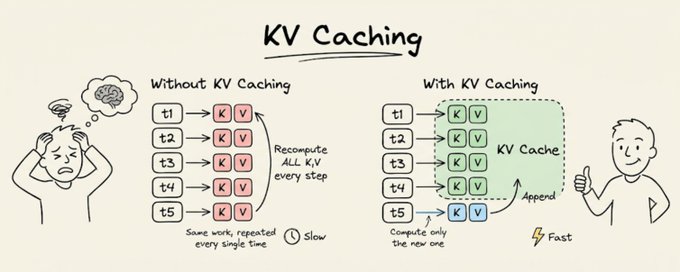
LLM 中的 KV 缓存机制详解

文章深入解释了大型语言模型(LLM)中的 KV 缓存技术。作者指出,LLM 生成文本时首个令牌较慢而后续令牌迅速的现象,归功于 KV 缓存的工程优化。该技术通过存储已计算键值向量,避免在自回归生成过程中的冗余计算,以 GPU 内存为代价换取显著的计算加速。文中详细解析了注意力机制的冗余问题、KV 缓存的工作原理、首令牌延迟(TTFT)的产生原因,以及内存与计算资源之间的权衡取舍。

技术 › LLM Avi Chawla 2026-03-226.3 KB 1.8M 2.9K 69