Wiki 知识库

全部文档 / 标签: 优化

13 篇
清除

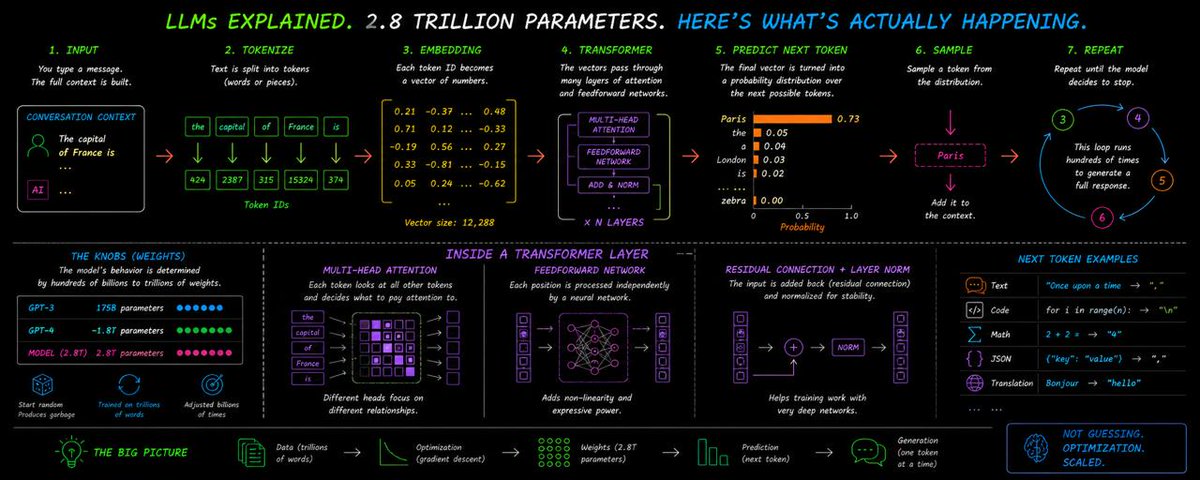
LLMs do not guess. They optimize. Here is the difference and the math behind it

文章阐述LLM的输出并非猜测,而是优化的结果。作者从基础数学概念讲起,介绍了优化问题的本质:找到使函数最大化或最小化的输入。文章系统梳理了几个关键优化方法:牛顿法(通过切线逼近快速求零点和极值,是现代训练算法的祖先)、黄金分割搜索(无需导数、利用黄金比例实现指数级收敛,用于超参数调优)、单纯形法(1947年Dantzig发明,通过沿多面体顶点移动求解线性规划问题)。文章解释了梯度下降作为简化版牛顿法如何训练拥有数万亿参数的语言模型,并对比了单纯形法与内点法在理论与实践性能上的差异。

技术 › LLM Deliriumm 2026-10-0415.0 KB 716.1K 379 65

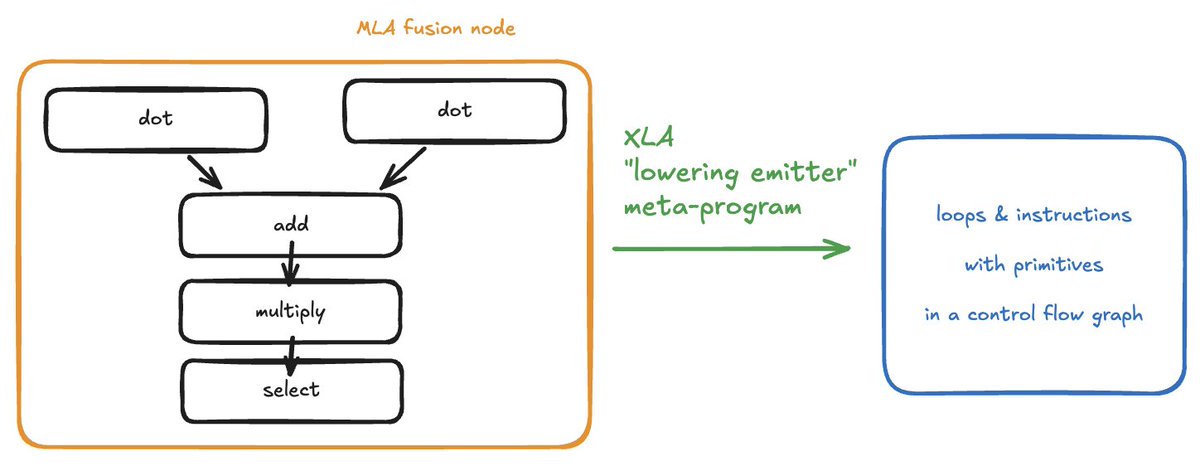
Compilers 2.0: AI as stochastic optimizer

作者基于十余年加速器编译器经验(曾创建XLA,现任OpenAI硬件团队)探讨AI时代的编译器演进。文章提出将AI视为'随机优化器'的新范式:传统优化编译器依赖固定规则与启发式,而LLM具备类似'optimizin Ollie'专家的程序优化直觉。文章回顾了STOKE随机超优化研究,指出Monte Carlo调整笨拙但快速,LLM智能但较慢,结合二者可智能地在优化空间中探索。虽然无法像传统方法那样保证语义正确性,但AI为自动化程序优化开辟了'编译器2.0'的新方向。

技术 › 编程语言 @cdleary 2026-09-0313.5 KB 364.5K 1.2K 73

从提示工程到图工程:完整五层架构地图

本文提出AI系统构建的完整五层架构:提示、上下文、工具、循环和图。作者指出,大多数AI系统问题并非模型本身,而是出在某一具体层上,且常被误诊。通过详细表格和实例,文章解释了每层的功能、失效模式及成本,并强调各层并非替代关系,而是层层包裹。核心观点是:修复错误层不仅浪费时间,还可能使问题恶化。文章提供了诊断指南和优化建议,帮助读者准确识别并解决AI系统瓶颈。

技术 › LLM starmex 2026-08-1529.0 KB 370.4K 238 82

机器学习的方法论总论

本文提出了一套机器学习方法论的统一框架,将学习算法拆解为十八个节点、四大块,以回答PCA、Transformer等不同方法在方法论上的异同。作者指出传统教科书定义、CRISP-DM流程和Domingos三元组的不足,特别是将“优化”作为第三列命名的问题,并引入闭式解、特征分解、积分等七种参数确定方式。文章详细阐述了定题与构造的前九个节点,包括三层代理(W/M/L)、目标与数据顺序、函数族、归纳偏置、参数化形态等,强调组合视角和归纳偏置的重要性。

技术 › LLM snowboat 2026-08-1386.0 KB 36.9K 60 80

从一张好看的图,到一套能持续生产的画风:我为什么做 hand-drawn-styles

本文介绍了作者开发 hand-drawn-styles 项目的初衷,即为了解决 AI 生成视频时画风不一致的问题。文章以北欧纸雕风格为例,详细讲解了如何通过控制生图和视频提示词,以及严格的验收标准,来实现稳定、高质量的视觉输出。作者建议从简单的 5 秒视频开始测试,逐步优化生产流程。

技术 › Skill 多肉|AI 内容增长架构师 2026-07-297.0 KB 18.3K 173

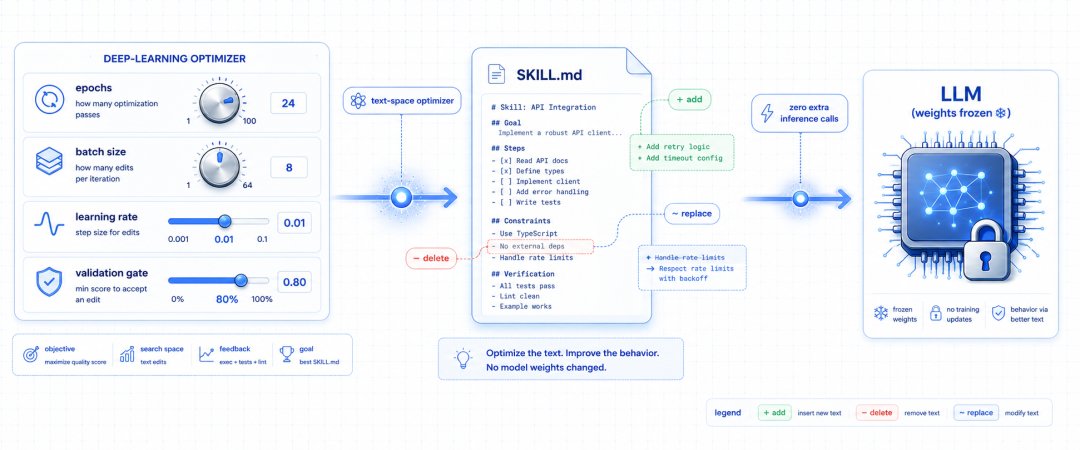
微软开源 SkillOpt:不动模型,只训练 Prompt

微软开源了 SkillOpt 项目,引入了“训练 Prompt”的新思路。与传统的 Agent Skill 开发不同,SkillOpt 在不改变模型权重的情况下,将神经网络训练方法(如 epoch、验证集)应用于优化 SKILL.md 文本。系统通过执行任务、打分、反思和筛选修改建议,实现技能文档的自动化迭代。论文表明,该方法在多模型环境下均有显著提升,且优化后的技能具备跨模型迁移能力。

技术 › Agent sitin 2026-07-132.2 KB

LLM 优化面试笔记:训练与推理核心技术

这是一份针对 AI 实验室面试准备的笔记,涵盖了高效训练和部署大语言模型(LLM)的核心优化策略。内容主要分为三部分:内存优化(如 Flash Attention、MQA/GQA、激活检查点)、计算优化(序列打包、高效变体 Transformer)以及推理优化(KV 缓存、投机解码、量化技术)。文章旨在总结在大规模模型开发中应对算力和内存瓶颈的关键技术。

技术 › LLM Gauri Gupta 2026-05-0654.2 KB 305K 758 65

Recursive Agent Optimization Actually Works

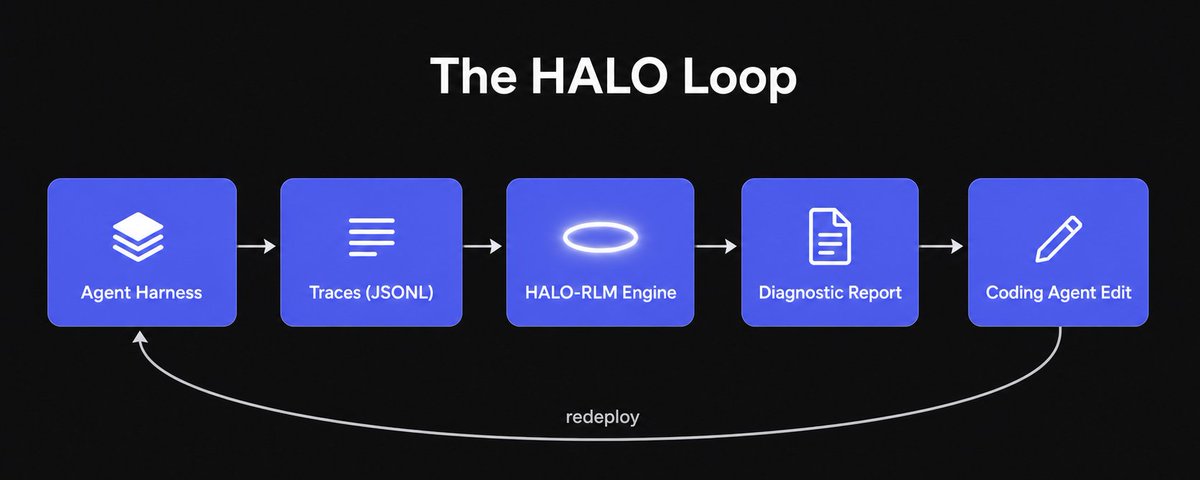
文章介绍了 HALO(分层 Agent 循环优化),一种构建递归自改进 Agent 框架的方法论。通过专门的递归语言模型(RLM)分析追踪数据并诊断问题,利用编码 Agent 修复漏洞并重新部署。在 AppWorld 基准测试中,经过 5 个循环优化,场景目标完成率从 73.7% 提升至 89.5%。该实验证明,利用 AI 审视自身追踪数据的“鸟瞰视角”能有效识别幻觉模式、工具调用错误及配置缺陷,为未来的框架设计提供了新的优化范式。

技术 › Harness Engineering Amar Singh 2026-05-055.7 KB 22K 228 85

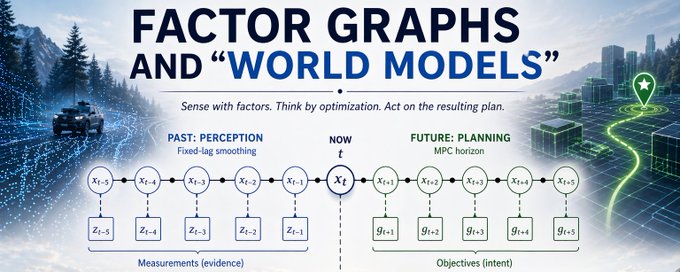
因子图与“世界模型”:统一的感知与规划框架

文章探讨了世界模型与因子图之间的深层联系。作者指出,因子图本质上是基于能量的模型,可用于状态估计和SLAM。通过将世界模型锚定在“现在”,文章提出了STAG框架,该框架利用统一的因子图优化机制,同时处理基于过去数据的感知和基于未来目标的规划,实现了感知与行动的无缝融合。

技术 › LLM Frank Dellaert 2026-04-2425.2 KB 33.2K 194 84

看完 Anthropic Academy 13 门课后,我对 openclaw 系统做了 17 个改动

作者基于 Anthropic Academy 的 13 门课程,对 openclaw 系统进行了 17 项深度优化。核心收获包括:采用 Adaptive Thinking 替代固定预算,可降低 30-50% 成本;引入 Think Tool 解决多步推理中的思考缺失;重构 Prompt 工程技巧(如 XML 标签分离、防幻觉指令);以及挖掘 MCP 的高级特性(Sampling、Roots)。文章按 ROI 排序提供了详细的改动清单。

技术 › Openclaw xiyu 2026-03-0311.5 KB 40.3K 350 91