Post-training RLM agents for end-to-end M&A Diligence
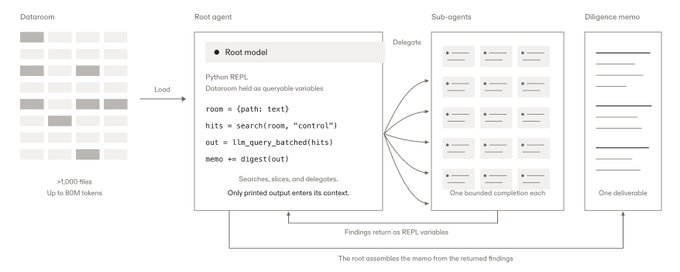
Harvey与Baseten合作,为M&A尽职调查构建了递归语言模型(RLM)harness:将整个dataroom(最多80M token)加载进Python REPL,由根代理协调子代理分工审阅文档。在LAB Diligence基准上,该harness使七个模型的平均评分标准通过率提升39.1个百分点。此外,通过强化学习对Qwen3.5-122B-A10B编排模型进行后训练,将通过率从29.9%提升至63.0%。结果表明,任务专用harness内的后训练是文档密集型法律工作的可行路径,团队正在扩展训练GLM-5.3作为根模型。