Wiki 知识库

全部文档 / 标签: 长上下文

24 篇
清除

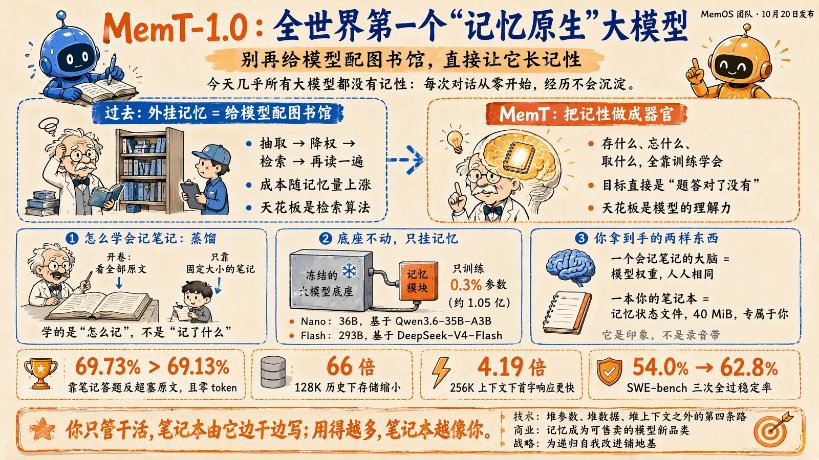
全世界第一个记忆原生大模型 MemT-1.0 上线

MemOS 团队发布全球首个“记忆原生”大模型 MemT-1.0,将记忆能力直接训练进模型权重,取代 RAG、Mem0 等外挂记忆方案。其思路是不改底座、参数冻结,仅在部分层并联约 1.05 亿参数的记忆块,通过蒸馏训练让模型自学“什么该记、什么该忘、怎么取用”,优化目标从检索命中率改为任务答对率。交付物包括通用模型权重(会记笔记的大脑)和用户专属记忆状态文件(仅 40 MiB 的笔记本)。数据显示其 40 MiB 记忆答题成功率 69.73%,略高于全量上下文的 69.13%,存储缩小 66 倍、首字响应快 4.19 倍。已在 Hugging Face 和 GitHub 开源,被视为开启模型“在使用中变强”的第四条技术路线。

技术 › LLM huangserva (@servasyy_ai) 2026-10-218.8 KB 73

7大核心升级,我们终于等来了一个“写作强于代码”的顶级模型:Gemini 4 Argon 深度实测

Google 旗舰模型 Gemini 4 Argon 于 10 月 14 日全面开放。文章详细解析了其 7 大核心升级:百万级 token 输出上限(长解码模式)、Arena 文字榜断层第一的写作能力、强于竞品的空间几何代码生成(3D 古建筑群)、深度推理与仅 15% 的超低幻觉率、原生多模态与 4K 音画同步视频生成、直接交付成品文件(PDF/Excel)而非代码,以及面向备考的苏格拉底式学习模式。作者附上 API 定价对比与 10 段实测提示词,认为其写作能力已超越 Claude Opus 5.5 和 GPT-6 Astra,性价比突出。
技术 › LLM Eian 2026-10-1418.8 KB 67.2K 197 84

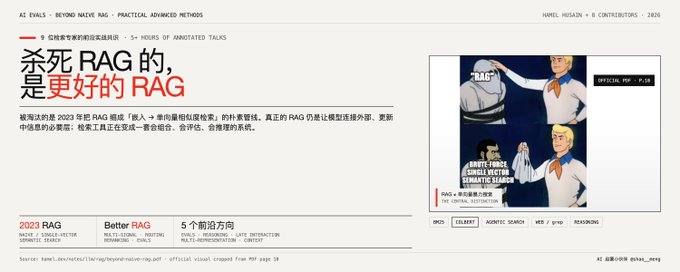
杀死 2023 RAG 的,是更好的 RAG:9 位检索专家的前沿实战共识「Beyond Naive RAG」

本文介绍 Hamel Husain 主编的演讲合集《Beyond Naive RAG》,汇集 9 位一线检索专家的共识:朴素 RAG(切块+单向量+余弦检索)已失效,但检索增强生成本身远未死亡。全书论证三条主线:长上下文不能替代检索(Context Rot 证明上下文越长模型越不可靠);评估先于优化(公开基准已污染,须建自有黄金数据集);复杂性不是目的(慎用图数据库等过度工程)。涵盖 ColBERT 后期交互、推理增强检索(Promptriever、Rank1)、多重表示与智能路由、FreshStack 评估指标等前沿方法,提出'评估驱动+多表示+推理增强+克制架构'的实践观。

技术 › LLM meng shao 2026-10-1211.9 KB 4.7K 43 84

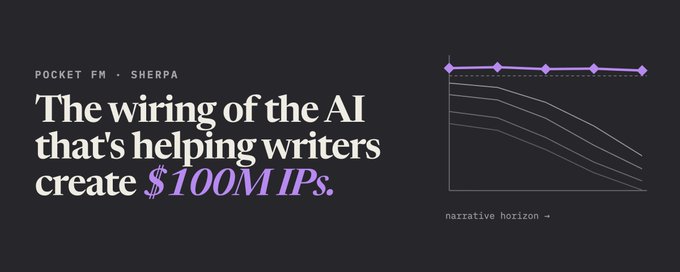
Why LLMs can't write well and how Sherpa fixes it

Pocket FM 创始人 Rohan Nayak 分享其 AI 写作系统 Sherpa 的构建历程。通用 LLM 因训练目标(逻辑推理、快速给答案)与创意写作需求(张力、情感、悬念、节奏变化)相悖而写不好故事,且缺乏清晰的强化学习成功信号。微调现成模型的尝试均告失败后,团队自研 Sherpa harness,由规划器、叙事世界模型(NWM,维护结构化故事状态与记忆)和散文引擎三大组件构成,并利用 Pocket FM 亿级用户的收听数据做强化学习,用户留存与完听率成为写作质量的天然反馈信号。盲测中 Sherpa 在 65.6%-97.1% 的配对比较中胜出,NWM 多跳检索准确率达 86.7%,成本约为同类方案的 1/21。

技术 › LLM Rohan Nayak 2026-10-0112.5 KB 349.1K 507 74

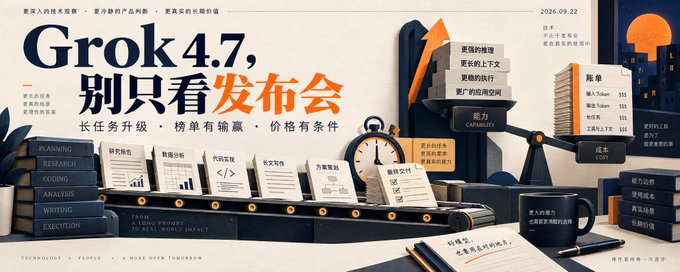
Grok 4.7 交卷:模型更强了,便宜这笔账得重算

xAI 于 9 月 21 日发布 Grok 4.7,主打长任务能力:更大基础模型、更长强化学习训练、支持 50 万 token 上下文。文章分析官方与第三方基准成绩,指出其在编程等部分任务进步明显但并非全面领先,需结合自身需求看待榜单。价格方面,标准 API 单价较低,但长上下文(20 万 token 以上)计费翻倍、Fast 版本仅限特定平台,且模型实际 token 消耗可能很高,单价低不等于总价低。作者建议用真实工作任务测试模型,关注交付质量与总成本,而非被亮眼演示或单价吸引。

技术 › LLM 李新宝 2026-09-227.1 KB 1.3K 4 78

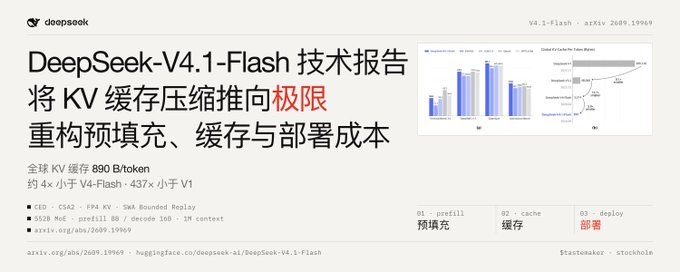
DeepSeek-V4.1-Flash 技术报告:将 KV 缓存压缩推向极限,重构预填充、缓存与部署的成本结构

本文深度解读 DeepSeek-V4.1-Flash 技术报告,该模型通过 CED 不对称编码器-解码器架构、CSA2 跨层稀疏注意力复用、FP4 主 KV 量化及 SWA Bounded Replay 近似恢复四项设计,将常驻 HBM 的全局 KV 缓存降至 890 bytes/token(约为上一代四分之一),持久化缓存降至八分之一。文章详细解析各项技术的原理与协作机制,澄清了对压缩数字的常见误读,评估模型能力变化,并与 PagedAttention、MiniCache 等已有 KV 压缩路线对比,指出该工作将缓存压缩从算法点推进为面向百万 token 长程 agent 场景的系统级共同设计,同时讨论其证据强度与局限。

技术 › LLM meng shao 2026-09-1921.7 KB 7K 25 82

How to Connect GPT-6 Astra to Your Obsidian Vault and Get Reasoning Depth No Other Model Gives You

本文详细介绍如何将 GPT-6 Astra 连接到 Obsidian 知识库。Astra 具备两大优势:可配置的推理深度(五档 effort 级别,可在对话中动态调整且保留缓存)和强大的长上下文检索能力(512K-1M token 范围内检索准确率达 96.3%,远超 GPT-5.6 Sol 的 73.8%)。文章给出两种连接方式:一是通过 Obsidian Local REST API 插件与 MCP 实现文件级读写,适合结构化操作;二是通过 computer-use 直接操作 Obsidian 桌面界面,适合图形视图、Canvas 等视觉空间任务。最后提供配置协议示例,指导如何按任务类型选择合适的推理档位并充分利用长上下文。

技术 › LLM CyrilXBT 2026-09-1230.1 KB 298.6K 233 82

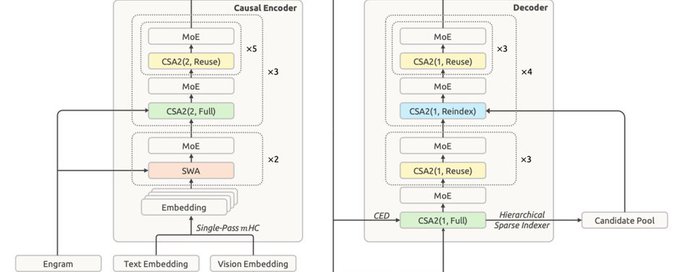
DeepSeek V4.1 Flash:架构学习笔记

本文是 DeepSeek V4.1 Flash 的架构学习笔记。文章详细解析了其 Causal Encoder-Decoder(CED)结构,该结构通过前后半段网络的不对称计算减少长输入处理成本。核心创新在于 KV 缓存压缩:通过 CSA2 跨层共享全局 KV、FP4 量化、分层稀疏检索以及 SWA 有界回放等设计,将全局 KV 降至约 890 字节/token,持久化缓存约为上一代的 1/8。文章还讨论了这些设计如何协同工作,使长上下文在 Agent 场景下更可负担。

技术 › LLM AI Dance 2026-09-1113.1 KB 21.3K 203 79

BestBlogs 早报:架构师 Agent、经济未来与 RLM 长上下文

本期早报精讲三篇文章:架构师 Agent 如何通过领域知识结构解决存量系统中的工程判断问题;Anthropic 经济情景探索器从任务视角分析 AI 对就业和增长的多情景影响;RLM 递归语言模型将长上下文转化为可执行状态,提升复杂任务准确率。速览涵盖 Agent 断点续传、OpenAI 数学争议、Codex 访谈、AI 编程成本、ADK for Kotlin、机器人触觉及 Kimi K3 流式加载等话题。

技术 › Agent ginobefun 2026-09-1022.3 KB 3.7K 3 76

Post-training RLM agents for end-to-end M&A Diligence

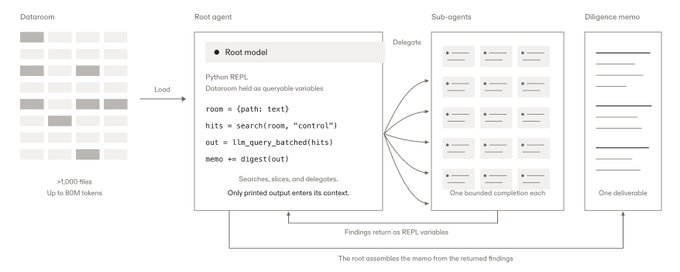
Harvey与Baseten合作,为M&A尽职调查构建了递归语言模型(RLM)harness:将整个dataroom(最多80M token)加载进Python REPL,由根代理协调子代理分工审阅文档。在LAB Diligence基准上,该harness使七个模型的平均评分标准通过率提升39.1个百分点。此外,通过强化学习对Qwen3.5-122B-A10B编排模型进行后训练,将通过率从29.9%提升至63.0%。结果表明,任务专用harness内的后训练是文档密集型法律工作的可行路径,团队正在扩展训练GLM-5.3作为根模型。

技术 › LLM Niko 2026-09-0920.6 KB 273.4K 280 78

🥇Top AI Papers of the Week

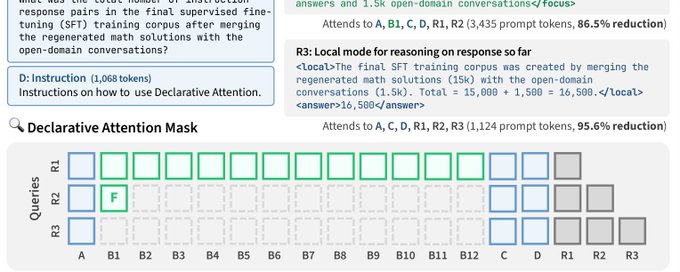
DAIR.AI 本周精选五篇 AI 论文:1)Declarative Attention,让模型在思维链中声明注意力区域,降低长上下文 KV cache 读取成本达 52%;2)Harness-of-Harness,将编码代理的执行组织为规划-开发-测试的迭代循环,实现多天无人值守开发,平均提升 52.25%;3)WikiSkill,Google 提出的技能 wiki 框架,让代理从自身运行记录中演化可迁移技能;4)SKILL.state,用显式可变执行状态替代追加式历史,使 prompt 从 O(T) 降至 O(1),提高准确性并降低 token 消耗;5)CORAL,Meta 的代理框架在生产推荐系统上持续优化,取得真实 A/B 验证效果。

技术 › LLM DAIR.AI 2026-09-0715.9 KB 43.6K 227 78

我让蚂蚁百灵的金融模型,和它自己打了 441 轮

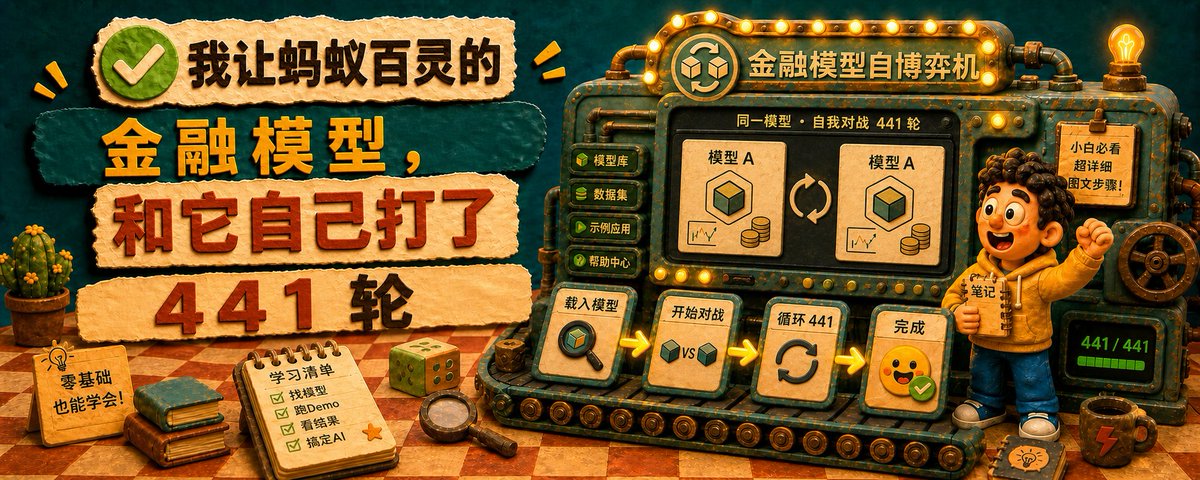
作者对蚂蚁百灵发布的金融模型 Ling-3.0-flash-Fin 与其通用基座 Ling-3.0-flash 进行了 441 轮对比实测,使用微软 FY26 Q4 财报和宁德时代 2025 年报等一手公开材料,设计八类任务。结果显示两个模型都能以分析师水准完成建模、口径辨析、抗幻觉等任务,准确率上金融版没有体现出明显优势;唯一显著差距在长篇输出场景,金融版更易'想太多'后返回空白(研报撰写失败率 18.6% vs 0%)。文章还给出反直觉发现:长上下文直投比 RAG 检索更准、更快、更便宜,并坦诚记录了测评过程中的多次自我纠错。

技术 › LLM 阿良|AI 工作流 2026-09-0319.1 KB 38.6K 141 90

GLM-5.3-Flash 发布:多模态大模型,开始真正“看着自己干活”了

文章介绍了智谱 GLM-5.3-Flash 模型的发布。该模型总参数量 320B、激活 18B,采用稀疏与线性注意力混合架构,注意力计算量降低 3 倍,支持 1M 上下文。作为 GLM-5 系列首个原生多模态模型,其最大亮点是视觉能力被直接纳入 Coding 循环,模型可观察网页截图、渲染结果和交互反馈,自主发现并修正问题,实现“生成—检查—迭代—交付”的完整闭环。文章还展示了其在游戏开发、3D 建模、办公文档和法律金融场景的应用,并给出 API 使用细节,认为大模型竞争正从回答质量转向完整工作的交付质量。

技术 › LLM Smartpig 2026-08-276.8 KB 6.5K 11 77

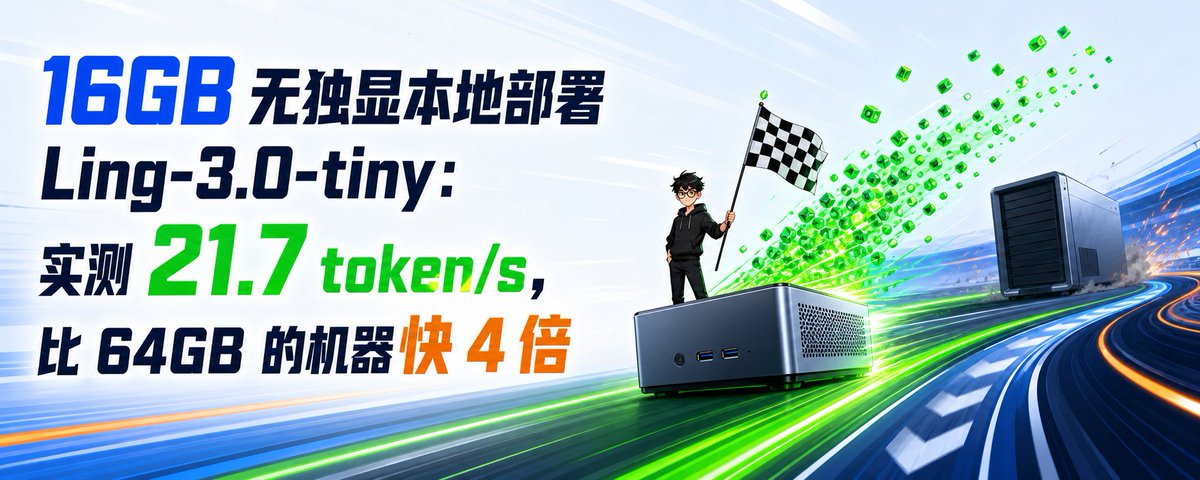
16GB 无独显本地部署 Ling-3.0-tiny 实测:21.7 token/s 与推理引擎版本的秘密

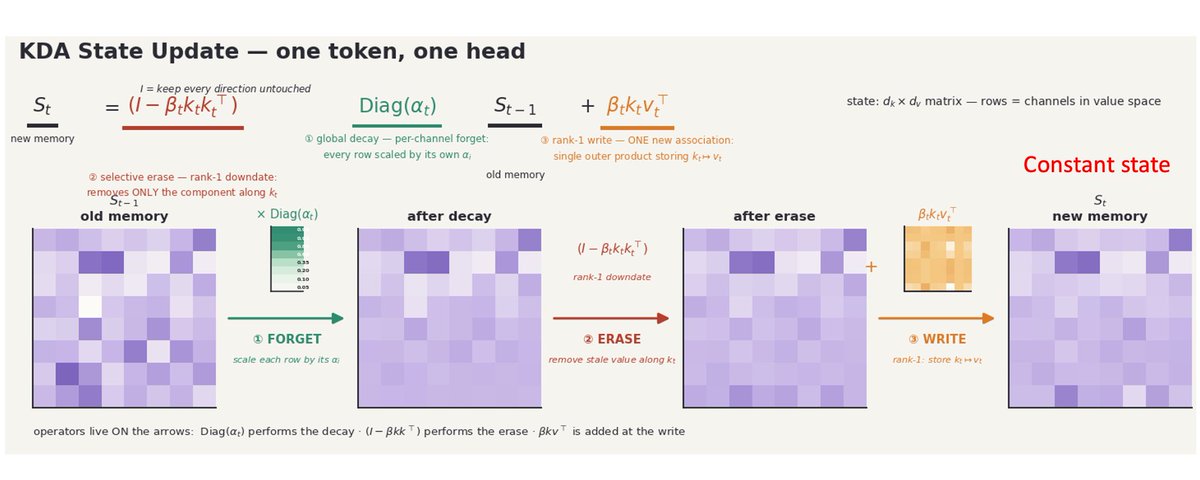
作者在一台单通道 16GB 内存、无独显的 Ryzen 5 5600G 台式机上,使用 llama.cpp 官方版部署 Ling-3.0-tiny(Q4KM 量化),实测生成速度 21.70 tok/s,比配置更强的 64GB+3090 机器快近 4 倍。经排查,差异源于推理引擎版本而非硬件。文章还分析了该模型线性注意力架构带来的超低上下文内存开销(约 6.79 KiB/token),总结了思考模式、Windows 编码、线程设置三个实践坑,并给出三步部署教程,证明普通电脑即可流畅本地运行该模型。

技术 › LLM 阿良|AI 工作流 2026-08-2414.2 KB 71.3K 177 90

Qwen3.8-27B Practical Guide: Control Reasoning Depth and Extend Context to 1M Tokens

Qwen3.8-27B is a compact, deployment-friendly dense model with native vision-language understanding and flexible thinking control. It introduces two key features: reasoning_effort to adjust reasoning depth per request, and ultra-long context support (262K native, up to 1M with YaRN). This guide provides practical instructions on using these features, including code examples for OpenAI-compatible API, vLLM, SGLang, and TokenSpeed, along with tips for optimal configuration.

技术 › LLM Qwen Developers 2026-08-155.7 KB 76.2K 1.2K 78

长上下文缓存能复用,为什么一压缩就失真?

文章探讨了 RAG 场景中 KV Cache 复用的挑战。现有方法在长上下文下面临存储与传输瓶颈,且直接复用或简单压缩会导致位置偏移和误差放大。C2KV 通过轻量级 Extractor 将文档压缩为可拼接、位置解耦的 KV 表示,实现了显著推理加速。文章分析了其在质量、延迟和工程落地上的权衡,强调 KV 复用已演变为存储、传输和质量共同约束的系统问题。

技术 › LLM 烟花老师 2026-08-0413.9 KB 1.2K 5

Kimi K3:超越 Fable 5 的开源模型完全指南

本文详细介绍了月之暗面发布的 Kimi K3 模型。该模型拥有 2.8 万亿参数和 100 万 token 上下文,性能超越 Claude Opus 4.8 和 GPT-5.6 Sol,对标 Fable 5。文章分析了其定价策略、架构创新以及模型自主优化架构的能力,展示了其在长程编码和 3D 前端开发方面的强大实力。

技术 › LLM Kirill 2026-07-2141.9 KB 1.3M 394

杨植麟 GTC 2026 演讲:如何扩展 Kimi K2.5

杨植麟在 GTC 2026 演讲中,详细阐述了月之暗面如何通过重构优化器、注意力机制和残差连接这三大基础组件来提升模型性能。他提出了 MuonClip、Kimi Linear 和 Agent Swarm 等技术方案,旨在让 Token 更值钱、长上下文更有效,并实现多 Agent 协作,从而推动开源模型逼近闭源前沿。

技术 › LLM 宝玉 2026-07-1912.6 KB

AI Agent 记忆机制原理与实战解析

文章深入浅出地讲解了 AI Agent 记忆系统的工作原理,从基础的单会话与多会话记忆保持切入,引出 Google 提出的情景、语义与程序性记忆三分法。通过对比 OpenClaw 的实现方式与存在的问题,重点剖析了企业级方案 EverOS 的架构。EverOS 将记忆细分为六大类,并通过语义巩固、主动上下文重建等技术优化记忆的抽取、更新与检索。文章还包含 EverOS 的 API 调用示例及 20 个真实落地场景,为开发者提供了 Agent 记忆系统的全景指南。

技术 › Agent 铁锤人 2026-05-1417.0 KB 445.2K 585 84

DeepSeek-V4 工程权衡分析:1M 上下文并非无损记忆

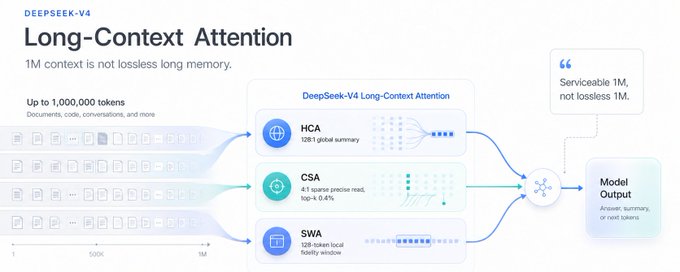
文章深入剖析了 DeepSeek-V4 如何通过 HCA、CSA 和 SWA 三通道并行架构,将 KV Cache 压缩至基线的 2%,从而实现工程上可行的 100 万 token 上下文。然而,这种极致的压缩是有代价的:MRCR 8-needle 测试准确率在 1M 长度下显著下降至 0.59。文章指出,V4 通过牺牲检索精度换取了推理成本的数量级降低,是一种‘有损的 1M’,并明确论证了该设计原理上无法完全替代 RAG 系统。

技术 › LLM GoGoNN 2026-04-2845.4 KB 16.8K 23 75

本周顶级 AI 论文综述:DeepSeek V4 与自进化智能体

本周综述重点介绍了 DeepSeek V4,这是首个默认支持百万 token 上下文的开源模型系列,通过 CSA/HCA 混合注意力机制和领域专家后训练技术,在推理性能上媲美 GPT-5.2。此外,还涵盖了 Apple 的 Mamba 架构知识蒸馏方法、Autogenesis 自进化智能体协议,以及 Skill-RAG 失败感知检索系统。

技术 › LLM DAIR.AI 2026-04-2733.5 KB 74.7K 165 68

DeepSeek V4是怎么训练出来的?58页论文深入解读

文章深入解读了DeepSeek V4论文,指出其核心价值在于将百万上下文、Agent原生能力与低价格结合,抬高了AI应用的地板。技术层面,V4通过mHC稳定残差连接,采用CSA+HCA混合注意力机制解决长上下文算力难题,并用Muon优化器替代AdamW。此外,文章还详细介绍了其1.6T参数量的训练稳定性技巧、反AI坍缩的数据构建以及基于“Specialist + OPD”的后训练范式转变。

技术 › LLM 花叔 2026-04-2527.6 KB 28K 155 83

RLMs are the new reasoning models

本文探讨了递归语言模型作为一种新的推理范式的重要性。RLM 通过将模型自己的提示视为可检查、切片和递归查询的环境,直接结合了推理和工具使用。文章回顾了推理和工具使用的历史发展,从思维链到 ReAct,再到 OpenAI o1 和 Claude 的工具使用。最新研究显示,RLM 在长上下文、记忆和长推理任务中表现出色,克服了传统单次前向传播的局限。

技术 › LLM Raymond Weitekamp 2026-04-2147.3 KB 68K 513 65