Wiki 知识库

全部文档 / 标签: 后训练

23 篇
清除

LoRA 与 QLoRA:用一块 GPU 微调大模型

本文从“模式”(一列乘一行的秩1矩阵)概念出发,系统讲解 LoRA 与 QLoRA 如何降低大模型微调的显存开销。LoRA 通过低秩近似冻结原有权重,只训练少量新增模式(B·A),将可训练参数减少到约万分之一;量化则用 4 位 NF4 格式配合分块缩放和双重量化存储权重,保留全部模式但降低每个数的精度。QLoRA 结合两者:冻结权重用 4 位存储,LoRA 分支用 16 位训练,使 65B 模型只需一块 48GB GPU 即可微调,Guanaco 在 Vicuna 评测中达到 ChatGPT 的 99.3%。文中还比较了低秩近似与量化误差结构的不同,并给出 7B 模型显存估算:全参数微调约 100GB,LoRA 约 15GB,QLoRA 约 5GB。

技术 › LLM Dongxi 东锡 NLP 2026-10-2412.7 KB 13K 32 76

指令微调:理解 Instruction Tuning

本文是后训练系列第二篇,介绍指令微调(SFT)。以斯坦福 Alpaca 用 52,000 条自动生成的数据微调 LLaMA 7B 为例,说明指令微调与预训练使用相同的下一个 token 预测损失,但数据和任务不同。文章详细讲解训练五步骤:收集、格式化、掩码、训练、评测,并通过 LIMA 和 FLAN 研究说明指令微调主要改变模型行为方式而非增加知识,少量数据即可泛化到新任务。还介绍了损失掩码原理、位置错开的实现细节、指令数据的三种来源及其局限:无法补充知识、比较回答优劣或检验正确性。

技术 › LLM Dongxi 东锡 NLP 2026-10-2312.4 KB 8.9K 59 83

预训练之后,为什么还要后训练?

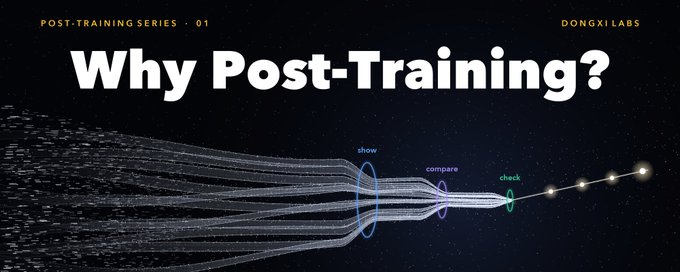
文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。

技术 › LLM Dongxi 东锡 NLP 2026-10-219.5 KB 26.6K 179 70

UC Berkeley 2026 秋季课程《Scalable AI》:从架构、预训练到推理的全栈工程

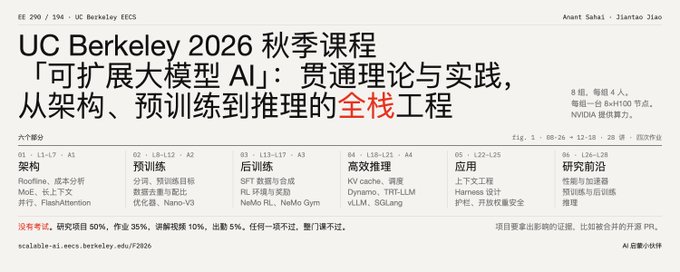
文章介绍 UC Berkeley EECS 2026 秋季开设的《Scalable AI》课程(EE 290/194),由 Anant Sahai 与焦剑涛联合授课,NVIDIA 提供算力支持。课程将大模型作为端到端工程对象教授,涵盖架构、预训练、后训练、高效推理、应用与研究前沿六个阶段,采用基于真实 H100 节点的项目制考核,无笔试,研究项目占 50% 且要求外部影响力证明。课程深度绑定 NVIDIA NeMo 工具链,反映了 AI 教育重心从论文向工程实践迁移的趋势,适合目标为 LLM infra 与 MLSys 的学生。

技术 › LLM meng shao 2026-09-299.4 KB 6.4K 53 73

台大李宏毅教授 2026 机器学习课程更新:大模型时代的 Agent 与自我进化

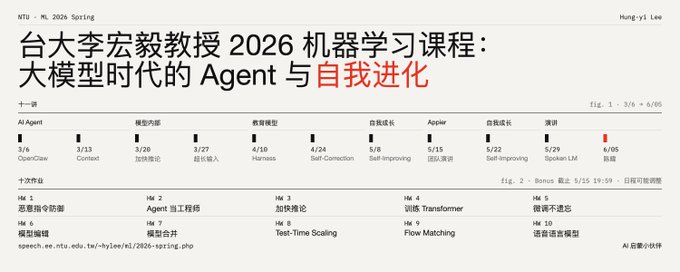
文章介绍台湾大学李宏毅教授 2026 春季机器学习课程,该课程完成了从经典机器学习到大模型时代前沿课的彻底转型。课程以四幕叙事展开:AI Agent 与 Context Engineering、模型内部架构(Flash Attention、KV Cache、位置编码)、模型教育(Harness Engineering、自我修正)、模型自我成长(Self-Improving、自我进化 Agent)。十次硬核作业与授课主题严格对应,涵盖 LLM 安全、Agent 搭建、推理优化、后训练等技能。文章认为课程演变折射学科趋势:Agent 成应用层范式、系统级工程能力重要、后训练时代重心移向环境设计与模型自我进化。

技术 › LLM meng shao 2026-09-2710.2 KB 22.4K 222 85

中关村学院 3 个月从零训练 7B SOTA 模型的启示

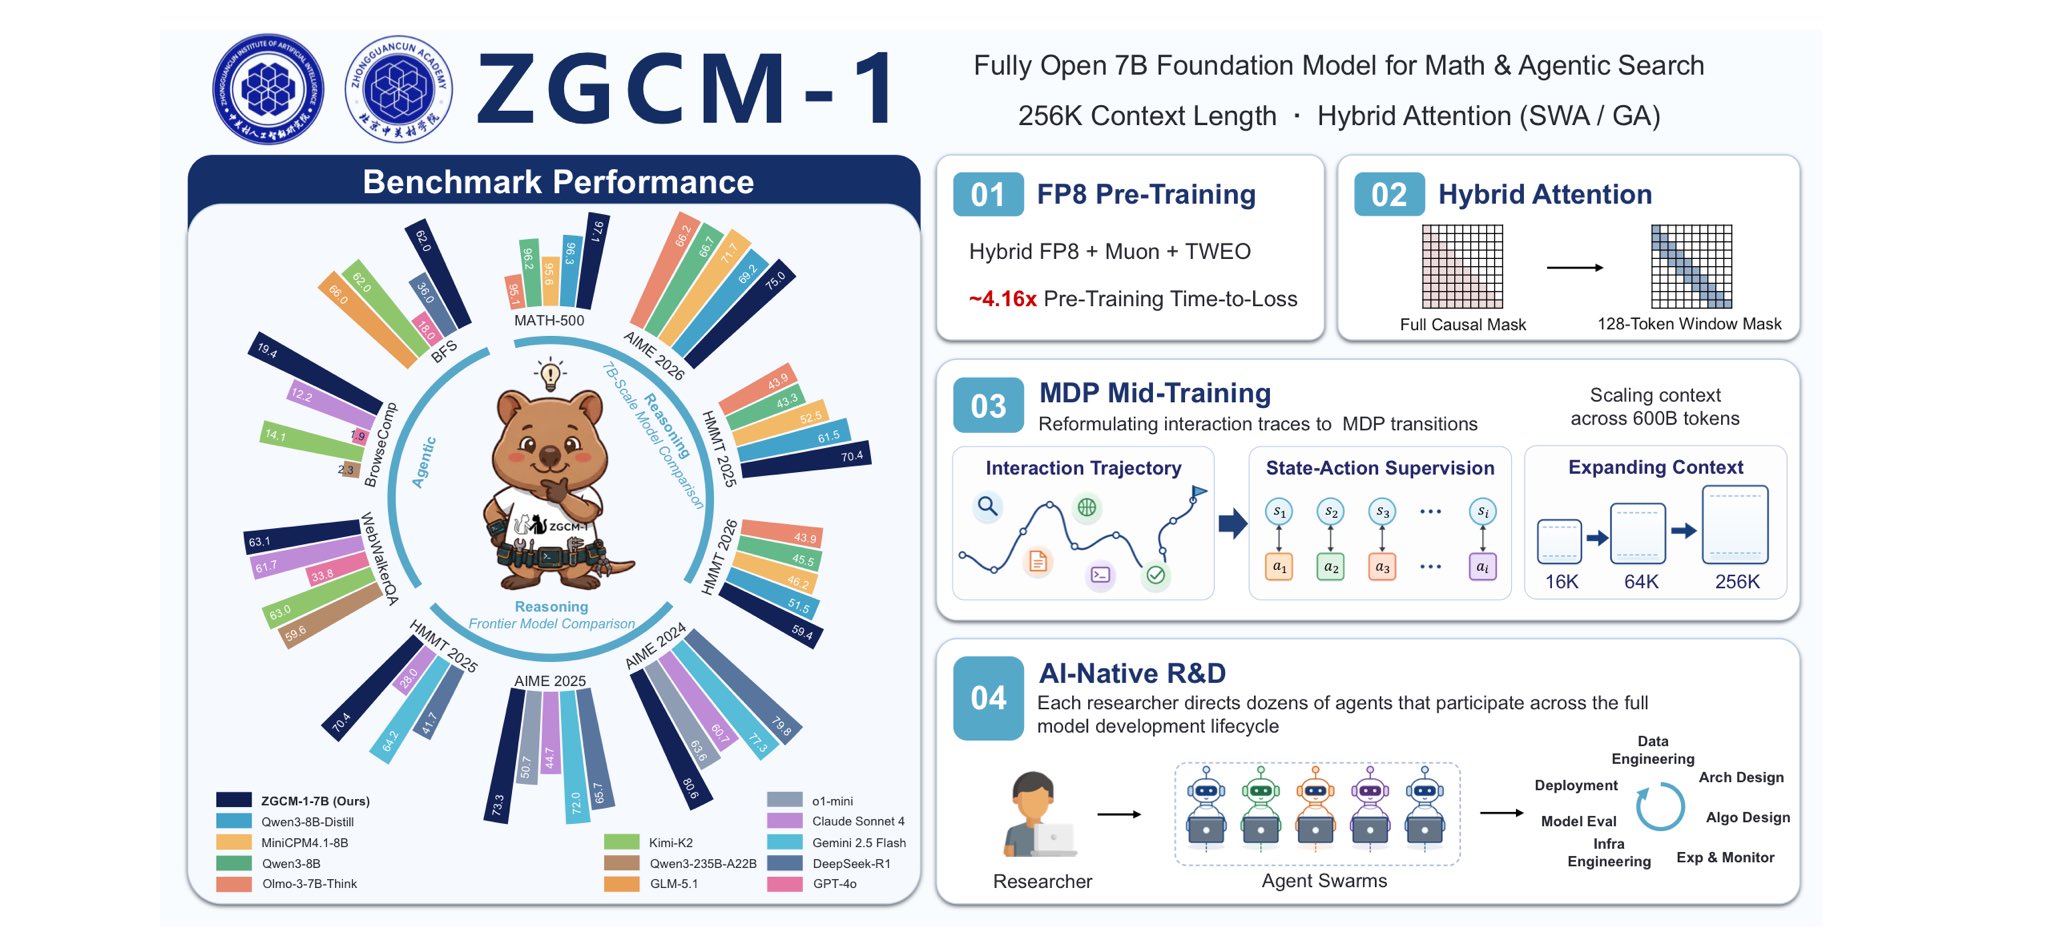
作者评述中关村学院何纪言老师带领 7 位博士生用 3 个月从预训练、中训练到后训练完全自主训练出 7B 模型并达到 SOTA 水平。文章提出三点观察:一是当前模型能力远未到全自主程度,在架构设计、算法设计等方面仅达 L2 辅助水平;二是模型训练会者不难,MiMo V2.6 RL 仅花 300 多万美金即达高水平,说明关键是人才而非算力堆砌;三是数据是新的代码,数据质量如同代码质量一样重要,该模型在数据清洗、课程学习、上下文扩增和 RL 优化上做了深入工作。

技术 › LLM Bojie Li (@bojie_li) 2026-09-262.6 KB 63

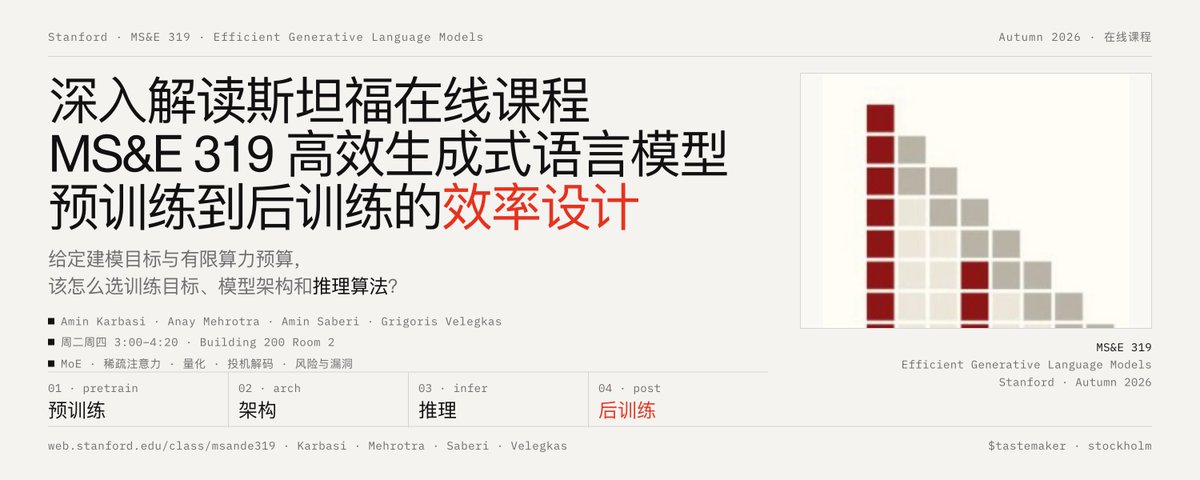
深入解读斯坦福在线课程 MS&E 319「高效生成式语言模型」

本文深入解读斯坦福 2026 秋季研究生课程 MS&E 319《Efficient Generative Language Models》。该课程以「效率」为设计科学,在算力预算有限的约束下,沿大模型生命周期系统讲授预训练、架构、推理、后训练四阶段的效率技术,包括多 token 预测、Muon 优化器、MoE、稀疏注意力、FlashAttention、KV 缓存压缩、量化、投机解码、LoRA、DPO 与蒸馏等,并涵盖越狱攻击与模型窃取等安全议题。文章认为该课填补了教育生态空位,内容前沿性与领域同步,揭示了每项效率技术背后的权衡取舍。

技术 › LLM meng shao 2026-09-2111.5 KB 18.9K 95 68

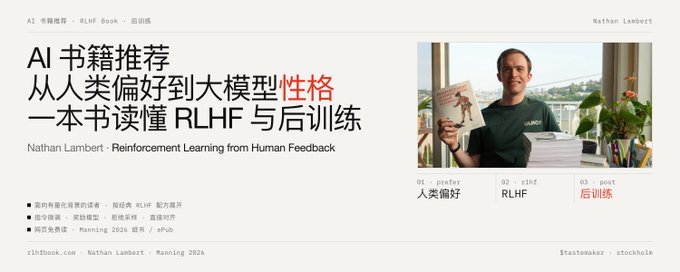
AI 书籍推荐:从人类偏好到大模型性格——RLHF 与后训练

作者推荐 Nathan Lambert 的新书《Reinforcement Learning from Human Feedback》,这是首本系统覆盖 RLHF 与后训练的专著。文章总结了全书三大核心论点:RLHF 本质是解决难以明确表述的问题;后训练是在固定底盘上挖掘潜能的'引导理论';数据远比算法重要。书籍内容涵盖指令微调、奖励模型、PPO/GRPO/DPO 等强化学习算法、RLVR、合成数据、过度优化、正则化与评估,最后指出 RLHF 已从哲学化的对齐成熟为产品工程,大模型性格可被设计但也存在被滥用的风险。

技术 › LLM meng shao 2026-09-157.5 KB 6.2K 55 82

Post-training RLM agents for end-to-end M&A Diligence

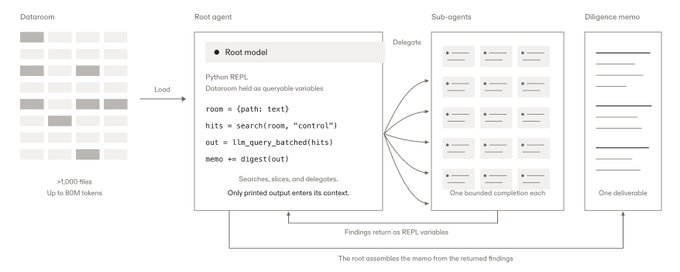
Harvey与Baseten合作,为M&A尽职调查构建了递归语言模型(RLM)harness:将整个dataroom(最多80M token)加载进Python REPL,由根代理协调子代理分工审阅文档。在LAB Diligence基准上,该harness使七个模型的平均评分标准通过率提升39.1个百分点。此外,通过强化学习对Qwen3.5-122B-A10B编排模型进行后训练,将通过率从29.9%提升至63.0%。结果表明,任务专用harness内的后训练是文档密集型法律工作的可行路径,团队正在扩展训练GLM-5.3作为根模型。

技术 › LLM Niko 2026-09-0920.6 KB 273.4K 280 78

The Missing Pieces in Recursive Self-Improvement

文章探讨递归自我改进(RSI)的瓶颈:当前 AI 智能体虽能迭代优化结果,却很少重新审视改进背后的策略。基于清华大学等机构的实证研究,分析显示智能体在 5,111 次训练运行中能显著提升模型性能,但仅有约 2% 的情况会切换训练策略,多停留在执行层面的微调。增加经验、人工指导或推理算力均无法根本解决该问题。研究指出,迭代不等于重新思考,Metaⁿ 和 Recuris 等新方法尝试通过递归分层改进策略、演化记忆机制来弥补这一缺失。

技术 › Agent Turing Post 2026-09-058.3 KB 8.2K 109 71

GLM 5.3: Scaling with Post-training, Intuitively Explained

文章解析了 GLM-5.3 如何在不重新预训练的情况下,仅通过规模化后训练(RL)超越 GLM-5.2,印证了 Sutton 的苦涩教训。重点包括:一是面向真实专家工作的环境设计,用研究代理生成长时程任务,配合严格的验证器三重检查防止 reward hacking;二是沿用 GLM-5.2 的 MoE 架构(744B 总参、~40B 激活),采用 MLA 压缩 KV cache、DeepSeek 稀疏注意力降低长上下文成本、MTP 投机解码平均每次接受约 4.5 个 token,以及 IndexShare 在相邻层共享索引实现 2.9 倍 FLOPs 节省;三是 SAO 算法与 slime 基础设施,将低廉的 rollout 转化为稳定的大规模后训练。

技术 › LLM Alex Ker 2026-08-2913.2 KB 103.9K 410 77

实测GLM5.3:1/3参数量+后训练逼平GPT-5.6

本文实测了智谱最新发布的GLM-5.3模型,该模型基于GLM-5.2的750B参数基础模型,仅通过后训练提升性能,在AA榜上以60分进入前十,成为同分段参数最小的模型。作者通过多个编码与安全案例测试,包括修复Ice菜单栏工具漏洞、开发2D跑酷游戏、3D愤怒的小鸟及音乐工作台等,展示了GLM-5.3在复杂编码、长程Agent任务和防御性网络安全方面的出色表现,并对比了DeepSeek、Grok等模型,认为后训练Scaling是提升模型能力的重要路径。

技术 › LLM 卡尔的AI沃茨 2026-08-2115.0 KB 4K 6 69

AI 记忆分数超过人类参考,这条新路线创业公司也能走

本文介绍了AI长期记忆领域的最新进展,重点分析了Alloomi公司在LongMemEval-S等评测中取得超过人类参考分的成绩。文章详细解读了其背后的技术路线——基于开源模型的自进化后训练流程,包括数据收集、质量筛选、专家锚定、后训练、评测准入和版本回滚等步骤。作者认为,这条路线降低了创业公司的门槛,将竞争焦点从算力转向数据和流程,为行业模型的发展提供了新思路。

技术 › LLM 产品经理老王霸 2026-08-1911.1 KB 17.4K 28 71

Own Your Intelligence: 企业自建 AI 能力实战指南

红杉资本团队撰文探讨企业是否应自建 AI 能力而非依赖前沿实验室。开源模型(如 Kimi K3、GLM 5.2)性能逼近前沿,后训练技术栈日益成熟,成本、速度、专有数据与自主掌控成为自建的核心动因。文章给出实践路线图:组建专职团队、公开研究成果,并系统介绍了评估(Evals)、Harness 与上下文工程、后训练(SFT/偏好调优/RL/蒸馏)以及在线学习四个技术步骤,帮助企业在特定领域超越通用前沿模型。

技术 › LLM Sonya Huang 2026-08-1811.2 KB 76.5K 352 79

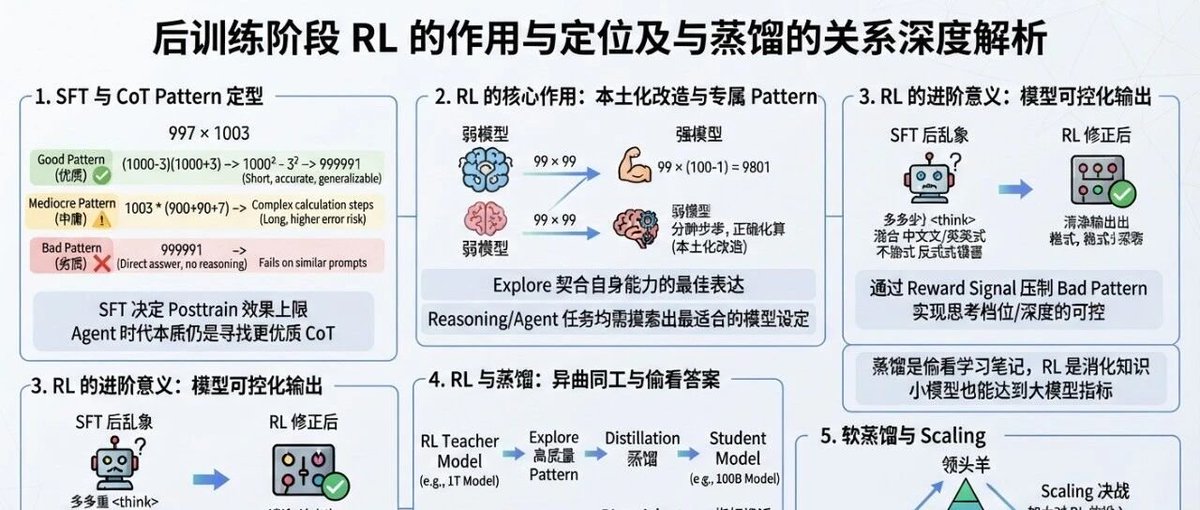
从 RL 到蒸馏,再到软蒸馏:Why RL Matters?

本文探讨了强化学习(RL)在大语言模型后训练阶段的作用,以及它与蒸馏(SFT)的关系。作者认为,SFT 阶段为模型提供了思维链(CoT)模式,而 RL 则帮助模型将这些模式“本土化”,找到最适合自身知识量和分词器的表达方式,并增强模型的可控性。同时,蒸馏(包括软蒸馏)可以高效地将强模型的能力迁移到弱模型,但过度依赖蒸馏会限制模型的进步。文章最后指出,领先团队应加大 RL 投入,而应用型团队则可优先选择蒸馏。

技术 › LLM ybq 2026-08-1611.6 KB 5.2K 43 73

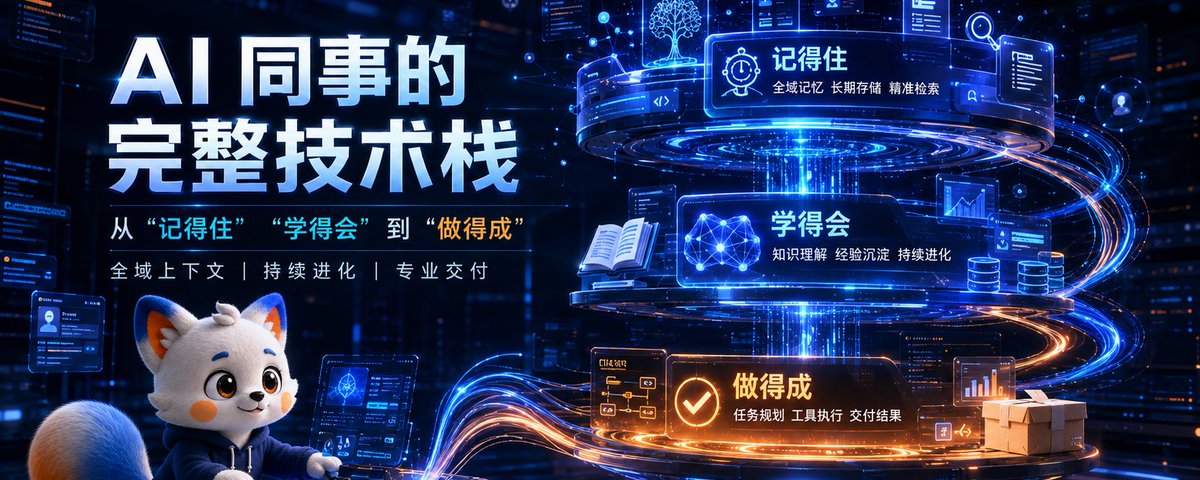
AI 同事的完整技术栈:从“记得住”“学得会”到“做得成”

本文介绍了 Alloomi 提出的 AI 同事完整技术栈,由三层能力闭环组成:Holistic Context 负责跨会话的上下文记忆,Self-Evolving Agent 通过后训练从反馈中学习,专业交付层验证实际工作成果。文章详细阐述了每层的技术机制、benchmark 结果及其局限性,并强调 OpenContext 仅是工程底座而非完整方案。最终指出,只有三层协同工作,才能实现可持续的 AI 同事。

技术 › LLM 一 2026-08-1511.7 KB 18.7K 44 73

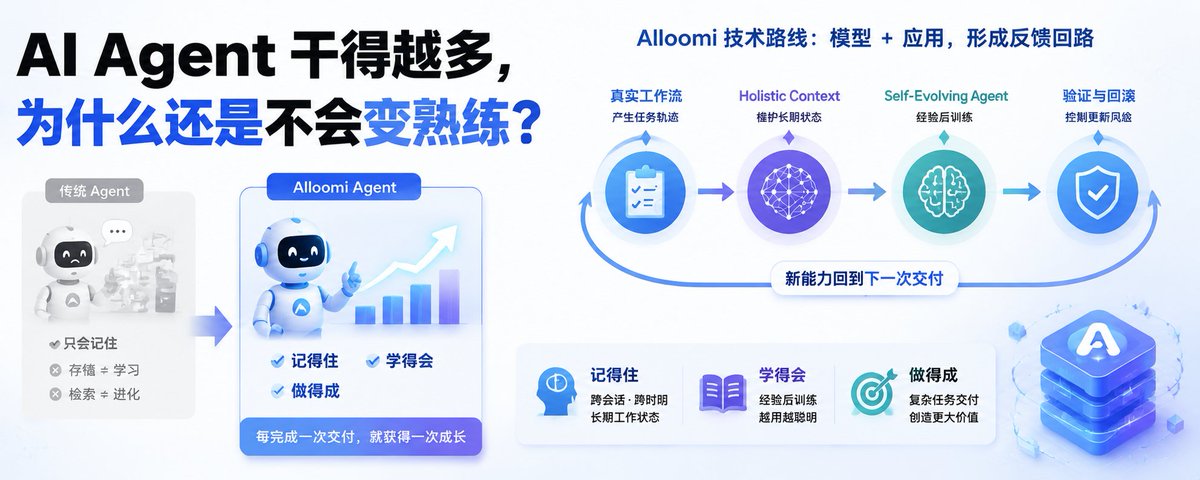
AI Agent 干得越多,为什么还是不会变熟练?

本文探讨了AI Agent在长期部署中面临的核心问题:完成多次任务后,其能力并未随之提升。作者介绍了Alloomi公司的技术路线,通过Holistic Context维护长期工作状态,以及Self-Evolving Agent将任务经验后训练进模型,形成“模型+应用”的反馈回路。文章详细解析了两份技术报告,包括上下文管理机制、后训练流程、基准测试结果及开源项目OpenContext的验证,指出当前证据仍属早期阶段,但为长期运行的Agent提供了可检查的工程入口。

技术 › Agent AI搞钱Hacker 2026-08-1315.0 KB 17.8K 46 82

蒸馏风暴:AI 公司不愿公开谈论的技术竞赛

本文深入探讨了 AI 领域中备受争议的“蒸馏”技术。文章追溯了蒸馏从最初的模型压缩方法到如今被用于“蒸馏攻击”的演变过程,分析了其技术原理、规模化实现方式以及引发的伦理与竞争争议。通过访谈多位研究员,文章揭示了蒸馏并非简单的复制,而是涉及复杂系统工程,且不构成长期壁垒。同时,文章也讨论了蒸馏与数据飞轮的关系,以及行业对黑盒与白盒蒸馏的不同态度,呈现了这项技术背后的商业、伦理与竞争图景。

技术 › LLM 晚点 LatePost 2026-08-1329.5 KB 36.6K 75 78

AI Agent 工程全景:600+ 场技术分享拆解与未来趋势

本文基于 AI Engineer 频道 600+ 视频内容,系统梳理了 AI 工程化十大核心技术主题,包括 Harness Engineering、Context Engineering、MCP 协议等。文章分析了过去一年的技术演进逻辑,并推演了未来 1-2 年从 AI Coding 向 Software Factories 转变的趋势,同时附带了各主题的代表性视频与索引。

技术 › Agent 观生AI 2026-08-0224.7 KB 5.9K 41

SFT、RL 与 On-Policy 蒸馏:原理与差异

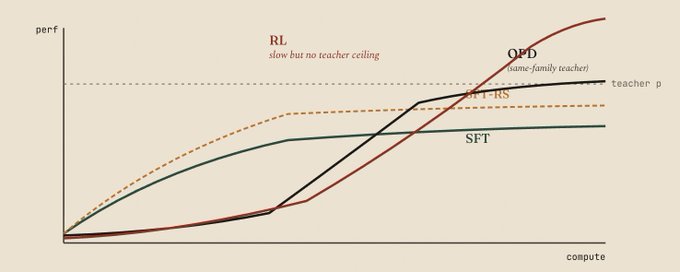
本文深入探讨了模型后训练中的 SFT 与 RL 流程,重点分析了基于同族模型(Same-family)的 On-Policy 蒸馏(OPD)技术。文章解释了 SFT 存在性能天花板的原因,以及 RL 如何通过复利效应突破这一限制。作者指出 OPD 结合了 SFT 的低成本和 RL 的复合优势,能高效利用教师模型的反向 KL 散度信号,是实现高性能模型微调的关键手段。

技术 › LLM will brown 2026-05-0150.2 KB 72

DeepSeek V4是怎么训练出来的?58页论文深入解读

文章深入解读了DeepSeek V4论文,指出其核心价值在于将百万上下文、Agent原生能力与低价格结合,抬高了AI应用的地板。技术层面,V4通过mHC稳定残差连接,采用CSA+HCA混合注意力机制解决长上下文算力难题,并用Muon优化器替代AdamW。此外,文章还详细介绍了其1.6T参数量的训练稳定性技巧、反AI坍缩的数据构建以及基于“Specialist + OPD”的后训练范式转变。

技术 › LLM 花叔 2026-04-2527.6 KB 28K 155 83

罗福莉:AI 范式已然巨变!OpenClaw 与 Agent 时代的深度解析

本文详细介绍了小米大模型负责人罗福莉关于 AI 行业发展趋势的深度见解。罗福莉指出,2026 年 AI 的核心已从预训练主导的 Chatbot 时代转向后训练主导的 Agent 时代。文章重点分析了 OpenClaw 框架的划时代意义,其通过分层记忆和模型编排弥补了短板,实现了极致的生产力提升。此外,还探讨了后训练算力权重的增加、团队组织方式的变革以及未来 AGI 的实现路径。

技术 › Agent Saito 2026-04-246.4 KB 143.2K 120 72

你不知道的大模型训练:原理、路径与新实践

本文深入探讨了大模型训练的全链路流程,指出2026年模型效果的差距主要源于后训练阶段。文章从预训练底座、数据配方、系统架构约束、后训练(SFT/RLHF/DPO)以及 Eval/Reward 机制五个维度,解析了如何通过工程化手段提升模型实际落地效果,并引用了 DeepSeek、Llama 等实例。

技术 › LLM Tw93 2026-04-0333.6 KB 650.9K 86