Wiki 知识库

全部文档 / 作者: VoxCat / 标签: AIGC

2 篇
清除

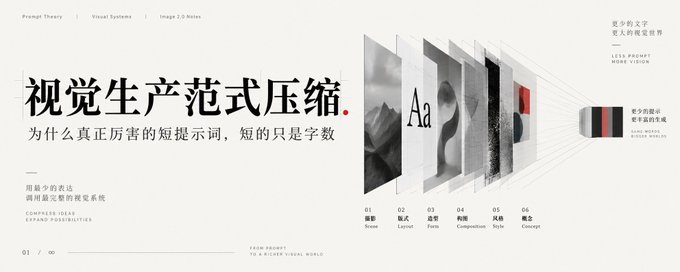
视觉生产范式压缩:看懂这篇,你才算开始会用 Image 2

作者通过长期测试 Image 2.0 图像生成模型,发现极短提示词反而能生成异常完整的画面,并提出“视觉生产范式压缩”理论。核心观点是:提示词信息量与字数无关,关键在于“高密度视觉概念”——如“编辑式人像”“极简时尚封面”等概念,能自然带出一整套摄影、造型、构图、版式等视觉惯例。好的组合应让不同概念各有侧重,形成一份简短的创意简报。这种方法通过控制高层结构、保留低层执行自由,让模型在成熟的视觉系统内完成设计。提示词的核心能力已从“描述画面”转向“选择视觉世界”。
技术 › LLM VoxCat 2026-09-118.9 KB 27K 95 81

我写提示词时,不再只靠感觉了

文章探讨了提升AI提示词(Prompt)质量的思考,对比了“情绪法”与“结构法”的区别。作者指出,单纯依赖情绪词汇虽能营造氛围但缺乏稳定性,而结构法通过定义载体、光线、构图等参数确保结果可控。最终提倡“混合法”,即用结构锁定画面骨架,再用情绪补足灵魂,将提示词从“许愿文”转化为精准的“视觉合同”。

技术 › LLM VoxCat 2026-05-146.7 KB 65.1K 263 83