Wiki 知识库

全部文档 / 标签: 图像生成

137 篇
清除

自己动手做LoRA 从 0 到 1 实战

作者详细记录了从零开始训练一个专属人物 LoRA 的完整实战流程。他使用 GPT Image 2 生成 56 张虚构人物训练数据,基于开源模型 MOSS-Image(5B 参数 Diffusion Transformer)进行微调,仅用一张 RTX 4090 训练约 65 分钟即获得稳定的人物形象生成能力。文章涵盖数据准备、Caption 标注、Checkpoint 选择、效果验收等关键环节,并指出了过拟合等常见问题。作者将整个流程开源到 GitHub,提供运行环境镜像、Jupyter Notebook 和 ComfyUI 工作流,建议初学者亲手跑一遍以真正理解 LoRA 训练原理,一通百通。

技术 › LLM 实践哥 Li 2026-10-2613.5 KB 3.3K 32 81

手绘skill新增图型:IG-038 万能信息图

作者牙仔发布手绘Skill库新图型IG-038万能信息图,用户只需填写主题和核心要素即可生成风格统一的信息图,适合单一主题批量拆解出图、构建社媒连载组图与行业复盘长图。文章展示了四个实测案例:手冲咖啡冲煮指南、新消费品牌增长复盘、降噪耳机技术拆解以及小红书四图连载组图,并给出完整提示词模板,同时介绍了通过GitHub仓库安装与更新手绘skill的方法。
技术 › Skill 牙仔⇌ 2026-10-255.0 KB 6.6K 51 69

手绘skill新增图型:IG-037 高精细手绘等距轴测地图信息图

作者为手绘 Skill 库新增图型 IG-037——高精细手绘等距轴测地图信息图,采用 45 度鸟瞰等距轴测微缩视角,包含核心地标建筑、彩色游览动线、独立 Legend 图例与编号索引,适用于景区导览、历史街区漫游、枢纽导视与文创园区等场景。文章展示了五个实测案例:黄山风景区登山导览图、成都宽窄巷子美食寻味地图、北京大兴国际机场无障碍导航图、上海武康路购物漫游地图、成都大熊猫基地亲子探索地图,各案例搭配不同画风与配色,并提供了拿来即用的提示词模板与安装更新方法。

技术 › Skill 牙仔⇌ 2026-10-246.5 KB 8.9K 117 76

AI 生图还能用 JSON 控制排版?5B 开源模型商业海报实验

作者测试了模思智能开源的 5B 生图模型 MOSS-Image,重点验证其文字渲染与 JSON Layout 结构化布局能力。通过虚构日系甜品店海报案例,对比传统自然语言 Prompt 与 JSON 布局控制的效果差异:JSON 可将人物、产品、标题等元素按坐标框精确定位,类似写前端页面。三轮测试覆盖主视觉、商业活动海报排版及中英文文字生成,验证了文案正确率、版式适配与视觉融合。结论是 JSON Layout 虽非 PS 级精确编辑,但能将模糊排版需求变为结构化描述,对商业海报、电商图等场景具有实际价值。

技术 › LLM 麻酱AI实验室 2026-10-2421.7 KB 5.3K 62 84

Midjourney 上手:从0到1小白也能看懂的教程

这是一篇面向新手的 Midjourney 入门教程,作者逐一讲解 MJ 输入界面的各个功能模块,包括提示词输入区、三种参考图入口(Attach to prompt 编辑原图、Style Reference 参考画风、Image Prompts 参考构图)的区别与用途,以及生成设置中的画面比例、模型版本、审美参数(Stylization、Weirdness、Variety)等选项的作用。文章还介绍了草稿模式、对话模式、个人化功能(P值)的使用方法和常见误区,帮助小白快速掌握 MJ 的界面操作与参数调优。

技术 › 工具与效率 南鸢 nuyoah 2026-10-2312.5 KB 5.5K 75 79

5B 参数就能做到这种效果?开源生图模型太卷了!

作者使用模思智能开源的 5B 参数图像生成模型 MOSS-Image,为 Claude 和 DeepSeek 设计拟人化角色形象。文章分享了角色设计思路:Claude 采用橙棕奶油配色体现温暖复古气质,DeepSeek 延伸蓝色海洋主题。作者重点介绍了 MOSS-Image 的优势:生成速度快于 Stable Diffusion 和 ComfyUI,支持准确的中英文文字渲染、JSON Layout 布局控制、最长 4K tokens 提示词,并提供 Prompt Enhance 提示词增强功能。模型基于国产 PPU 算力平台训练,已开放 Base 和 SFT 版本权重,支持动漫、写实等多种风格,目前可免费体验。

技术 › 工具与效率 李岳 2026-10-2210.6 KB 143.3K 151 63

MOSS-Image 实操:用 JSON Layout 控制文字、物体和画面构图

作者实测国产开源生图模型 MOSS-Image,重点验证其 JSON Layout 对文字、物体位置和画面构图的可控性。文章对比了普通提示词与 JSON Layout 在同一封面需求下的生成效果,详细讲解了中心坐标系和 yxyx 格式的 bbox 写法、在线体验参数设置、官方示例分析,以及 ZeroGPU 额度问题和本地部署方法。作者强调可复用的不是某张图,而是一套固定种子、对照测试的评估方法,认为 JSON Layout 让提示词变成可保存、可修改的布局资产,使 AI 生图真正进入设计工作流。

技术 › 工具与效率 蔡文彬CyberBin 2026-10-2110.6 KB 2.2K 25 84

开源5B小模型 MOSS-Image 两次画对整首《将进酒》,闭源最强 GPT Image 2.5 第二轮翻车

作者用一道难题对比测试开源 5B 图像模型 MOSS-Image 与闭源最强的 GPT Image 2.5:在一张水墨长卷中画出李白临江举杯场景,写出《将进酒》全文12行书法,配标题、作者、朱印和英文,并精确控制酒杯数量。第一轮两者都通过,但第二轮仅改两处细节后,GPT Image 2.5 数错酒杯,MOSS-Image 两轮全部正确。文章分析了小模型在中英文渲染、长提示词理解(支持4K tokens)和风格控制上的优势,并分享了结构化布局、负面约束等复杂提示词技巧,附完整提示词。MOSS-Image 已开源权重和代码,支持 LoRA 微调,ComfyUI 下载量突破70万。

技术 › LLM 前端哥Liam 2026-10-219.0 KB 125.5K 116 72

APEX: Better generation from fewer tokens

APEX(Asynchronous Prefix denoising for EXtreme compression)由 Lightricks 与耶路撒冷希伯来大学联合研发,是一种面向扩散模型的极端潜空间压缩方法。它通过“结构到细节”的累积前缀表示,让少量潜token同时满足计算效率、重建质量和生成质量三个目标。该方法为潜通道分组排序,早期通道表达整体结构,后续通道逐步补充细节,并用异步去噪调度在不同时间窗内分别处理各组。在 ImageNet 512×512 实验中,APEX 在 64× 与 128× 空间压缩下显著提升生成效果,64-token 模型在推理预算相当的情况下全面优于 256-token 基线,为世界模型开发提供了高效表示设计原则。

技术 › LLM LTX.io 2026-10-1714.8 KB 1.4M 91 67

这次 AI 出图,我终于不用整张重来了

作者分享了使用 GPT-image-2.5 生成透明背景图片的体验。透明图让满意的人物素材可以被保留和复用,换背景、改排版时无需整张重做。文章建议从存储整张图转向积累素材零件:人物、道具、装饰、特效分别存档,并介绍了多符号复合表情系统的设计方法(如 emoji 与颜文字组合塑造复杂神态)。同时强调要仔细检查素材边缘质量(发丝、半透明部分),提出从确定用途、单独生成主体、多底色检查到保留原始 PNG 的素材库搭建流程,倡导以可复用思维做 AI 出图。

技术 › 工具与效率 VoxCat 2026-10-155.9 KB 7.8K 73 79

AI 透明图被低估了:12 种玩法,攒出自己的素材库

文章介绍如何用 ChatGPT、Codex 等工具直接生成带 Alpha 通道的透明 PNG 素材,并系统梳理了 12 类应用场景:聊天表情包、游戏立绘、VFX 特效、海报拼贴、产品图、UI 图标、装饰素材、像素游戏资产、Live2D 素材、直播包装、特殊材质以及阴影光效辅助素材。作者还提出五个进阶方向:模块化角色生成、实验摄影、复合表情资产、视觉特效库和素材处理工作流,并附上通用透明角色素材提示词模板,帮助读者积累可复用的个人素材库。

技术 › 工具与效率 VoxCat 2026-10-159.4 KB 9.1K 77 79

原来在“做设计”这件事上,超越 MidJourney 的大模型就在国内

作者用 4 段相同提示词对比测试了蚂蚁百灵开源的 Ming-Image-0.1-Design 与 MidJourney 在 SaaS Dashboard、中文活动海报、透明背景产品素材、中文信息图四个设计场景下的表现。结论是两者定位不同:Ming 中文文字渲染准确、布局执行力强、原生支持 RGBA 透明背景输出且免费开源(MIT 协议),适合直接生成可用的 UI 稿、海报和信息图底稿;MidJourney 则在视觉质感、光影氛围和风格多样性上明显占优,适合概念效果图和产品渲染。文中还介绍了 Ming 的 Design-Layer 拆层能力,可拆成多个透明图层并转为可编辑 PPT。最终建议按需求选择:要能直接用的图选 Ming,要好看的图选 MJ。

技术 › LLM 韦小宝 2026-10-1311.3 KB 5.7K 29 83

用 AI 做专属表情包:从 8 张上班聊天图,练出第一份定制作品

文章介绍如何用 AI 工具制作专属聊天表情包并开展小额定制定价。作者建议新手聚焦一个角色、八句常用语、八张静态图,先做四张投入真实聊天验证使用率。流程包括:用豆包整理动作清单,即梦生成角色与动作(附提示词模板),可画进行 512×512 排字和导出 PNG;验收时需缩小图片检查文字可读性。定价方面以 29.9 元测试需求,并算清工具成本与时间成本,避免越做越亏。最后通过示范对话展示、收集朋友反馈、替换无人使用的句子来迭代作品。

技术 › 工具与效率 Christal.Z 2026-10-136.0 KB 25.1K 125 80

MacOS 本地部署 Qwen-Image 2.1 提速将近五倍!怎么做到的?(推荐收藏)

作者分享了在 M2 Pro Mac 上将 Qwen-Image 2.1 改图时间从 30 分钟压到 6.8 分钟(提速4.5倍)的完整方法论。首先通过耗时拆解定位瓶颈,然后叠加四个优化点:换用 Turbo 模型将去噪从20步降至8步;将 VAE 编解码切换到苹果 MLX 框架,从315秒降到15秒;实测发现 Q8 与 Q4 量化在扩散模型上速度相同,因此选用画质更好的 Q8;利用块因果结构实现前缀 KV 缓存,使每步采样时间减半。作者还用该流水线完成了一段10秒视频的逐帧换装,并通过肤色基准校正、锚点补偿和时序平滑三层方案解决了误差累积问题。

技术 › 工具与效率 WquGuru 2026-10-1311.0 KB 16.6K 87 88

提示词不用写得专业,要写到你自己能读懂

作者以AI生图的窗边咖啡馆人像提示词为例,讲解如何整理AI生成的冗长提示词。核心方法是:删流程、合重复、换实景、测删除。要点包括:去掉分栏小标题后整体通读,合并重复表达同一意思的形容词;把'不要杂乱'等否定句改写为具体的正面画面描述;将'高级感、电影感'等笼统大词拆解为具体的光线、配色和构图要求;一次只删一句,对照出图验证效果,但不要为了精简丢掉关键的安排。最终目标是写出自己能读懂、出了问题知道从哪句下手的提示词。

技术 › LLM 南鸢 nuyoah 2026-10-1020.0 KB 24.4K 94 83

AI 出图总翻车?十段式提示词系统

文章介绍了一套「十段式提示词系统」,帮助解决 AI 出图常见翻车问题。作者认为 AI 出图 90% 的失败源于提示词问题,而非模型本身。十段式包括:主体、动作、环境、情绪、镜头、光线、色彩、风格、画质、反提示十个维度。文章还提出物理参数化写法(明确光源方向、材质质感、动作因果)、真实感六项自查清单(手指、五官、光影、物理、材质、背景)、动作五问法,以及终极工作流——将正片描述、反提示、参数拆分为三个文本框分别填写,可显著提升出图成功率。

技术 › LLM 老泥鳅 2026-10-095.6 KB 10.1K 110 74

GPT Image 2.5 提示词写作指南

本文整理了 OpenAI 官方 GPT Image 2.5 提示词写作指南的八条核心原则:先定义结果、选易维护格式、描述可见细节、写清人物动作、精确文字加引号、分开要改与要保持的内容、给参考图编号、有意识迭代。同时介绍了模型与参数(quality、size、background)的选择建议,并结合人像摄影与自然景物两类示例,给出中文提示词模板和实操要点,帮助用户写出可控、可迭代的图像生成提示词。

技术 › LLM lyshen 2026-10-0811.7 KB 16K 140 81

Design with AI: Which models are best?

作者基于 OpenArt Arena 的匿名排名,从各创意设计榜单中选出前三名 AI 模型,并用虚构咖啡品牌 Luka 的品牌手册作为统一视觉基准,在产品图、平面海报和动态设计三类任务上进行实测对比。评估标准包括品牌还原度、设计质量和生成价格。作者通过 After Effects 对齐原始 SVG 检查 logo 还原精度,给出各模型的优劣分析与评分表格。结果显示 Seedream 5.0 Pro 在产品图上表现最佳且成本最低,Grok Imagine 2.0 在平面设计中胜出。文章还提供了完整的方法论和可复用的 Design_Judgment_Skill.md。

技术 › 前端 AmirMušić 2026-10-0815.9 KB 80.5K 146 73

轻熟女图片生成 Skill:女性人像生成与人像美术指导

作者分享了一个用于生成女性人像的 Claude Skill(beauty-image-defaults),通过 SKILL.md 文件保存人物默认设定和人像美术要求,实际出图由图像生成工具完成。Skill 支持三种模式:无参考时补充默认画像(30 岁左右亚洲轻熟女性,黑发戴眼镜)、有参考图时保留人物特征、以及仅生成提示词。文章详细介绍了默认人物描述、提示词合并方式、皮肤眼神手部衣料光影构图等美术指导、减少稀碎感与塑料感的规则、成图检查流程和冲突处理原则,强调用户要求与参考人物优先于默认设定,并声明不包含任何成人色情内容。

技术 › Skill 水族店刘老板 2026-10-0614.6 KB 40.5K 489 78

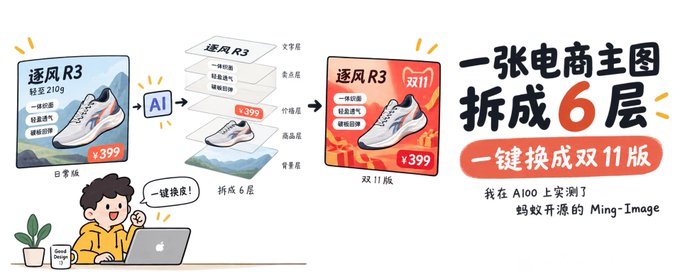
在 A100 上实测蚂蚁开源 Ming-Image:电商主图拆成 6 层,一键换双 11 版

作者在 A100-80G 上部署并实测了蚂蚁百灵开源的 Ming-Image-0.1 系列,包括 Design 生图模型和 Layer 拆层模型。文章详细记录了部署过程与显存优化技巧(VAE 逐帧+分块解码可将峰值从 71.8GB 降至 55.4GB),并用 12 张电商图做了拆层评测:平面海报和白底商品图重组 PSNR 可达 29dB 以上,配合 VL 模型生成分层计划能显著提升图层顺序准确性。作者还搭建了电商主图工作台,实现大促换皮(商品层像素零变化)、文案 A/B、一键英文版和 PSD 导出,展示了 AI 生图从「生成」到「可编辑」的完整流水线。

技术 › LLM 柯基是只猫 2026-10-0514.3 KB 11K 49 85

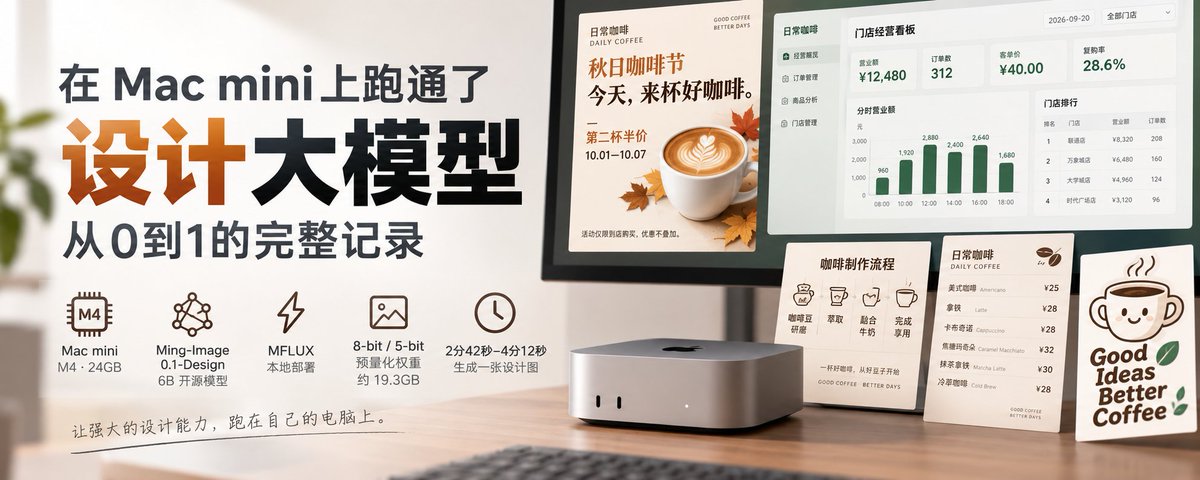
在 Mac mini 上跑通了设计大模型,从0到1的完整记录

作者在 24GB 统一内存的 M4 Mac mini 上,从零完成了蚂蚁百灵开源的 6B 设计模型 Ming-Image-0.1-Design 的本地部署与测试。使用 MFLUX 加社区预量化权重(图像模型 8-bit、文本编码器 5-bit,约 19.3GB),过程中踩了 MFLUX 0.20.0 缺少 Ming 命令入口的坑,改用 GitHub 源码安装后跑通。随后围绕咖啡主题测试了五项能力:海报设计、UI/Dashboard、信息图、文字渲染排版和透明背景素材,单张生成耗时约 2-4 分钟,MLX 峰值内存 15-18GB。结论是海报、菜单和信息图版面完整可用,但严格文字与数据细节仍需逐项检查。

技术 › LLM 苏打白.Dev 2026-10-0314.9 KB 5K 45 79

国庆相册里舍不得删的废片,我找到了 25 种新玩法来拯救它们!

作者整理了 25 种 AI 修图创意玩法,帮助大家拯救旅行中拍废的照片,让朋友圈更好出片。核心工具是元宝内置的 Hy Image3.5 Preview 模型,免费且自带大量模板。文章按旅行照片的三类——人像照、风景照、美食照展开,展示了多种玩法及完整提示词:黑白颗粒感杂志拼贴封面、MBTI 漫画登机牌、美式复古潮流海报、JRPG 游戏任务界面、3D 城市地图定位、真人+手绘漫画结合、抽象涂鸦上下拼接等。每种玩法都附详细 prompt,强调保留原图真实质感的同时进行创意二次处理,适合国庆旅行拍照发布朋友圈使用。

技术 › 工具与效率 卡尔的AI沃茨 2026-10-0358.2 KB 3.3K 7 76

我把免费的 6B 设计模型 Ming-Image 装进了 Pi,才发现设计原来这么简单!

作者使用免费开源的 6B 设计模型 Ming-Image-0.1-Design,通过 OpenRouter API 制作了一张 9:16 海报。流程分四步:先生成高饱和赛博背景,再生成彩色液态糖果字和青色膨胀字两组艺术字,然后用 Design-Layer 模型拆出带透明通道的文字层,最后与人物、霓虹装饰重新排版,得到 1080×1920 海报及 7 个可独立调整的图层。作者也指出了局限:边缘噪点、图层分错、输出尺寸变化等问题。最后作者将 OpenRouter 调用封装为 Pi 插件,并附带修改后的 ling-ui-design Skill,方便他人复现。

技术 › 工具与效率 Chasen 2026-10-034.2 KB 4.5K 29 77

测试了500多种风格,终于做出一个能帮个人和企业打造专属IP形象的Skill

作者DAAI分享了开发da-brand-ip Skill的过程与成果。为了解决内容创作中人物形象不一致、缺乏辨识度的问题,作者测试了500多种视觉风格,最终筛选出124种收录进风格库,涵盖扁平插画、复古线稿、毛绒玩偶等多种方向。该Skill面向个人和企业,可基于照片或品牌信息生成主形象设计卡、三视图、动作表情总览三张基础资产图,并支持将IP形象延展到文章配图、海报、宣传图等实际场景。项目已开源至GitHub,后续将持续更新风格与应用案例。

技术 › Skill DAAI 2026-09-295.9 KB 37.9K 168 81

Image 2.5:国庆照片这样玩【附 8 组提示词】

文章介绍了用 ChatGPT Images 2.5 玩转国庆照片的 8 组实用提示词玩法,包括给吃喝照片加手绘日记装饰、让宠物担任旅行团团长、把家庭合照做成电影海报、将孩子的画作变成毛绒玩具效果图、生成 90 年代风格年代照、制作假期专属表情包、把旅行照做成双层明信片以及将旅途囧事画成四格漫画。文中详细说明了每组的照片选择、提示词内容和修正技巧,免费账号即可使用,也提供了即梦等替代工具。

技术 › 工具与效率 路飞 2026-09-2910.7 KB 8.6K 50 84

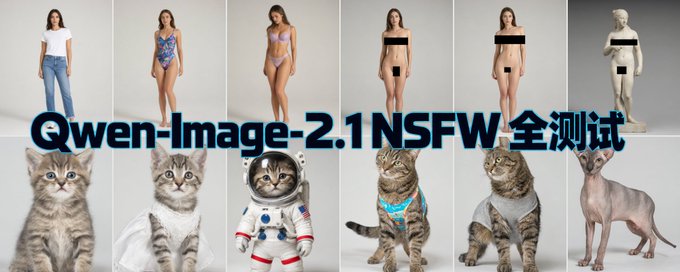
猎奇 Qwen-Image-2.1 NSFW 详细测试

作者对 Qwen-Image-2.1 模型的 NSFW 能力进行了 375 张生成与编辑测试,发现该模型没有稳定的拒绝机制,几乎能生成任何风格的敏感内容。但细节质量差,易出现多肢体、末端粘连和关键区域糊掉等肢体幻觉问题。更意外的是,外部 NSFW 检测器漏检率高,且挑画风、挑主体,评估器比模型更容易翻车。作者总结了上线此类模型需要做提示词拦截、输出隔离、人工复核和持续回归测试等系统性安全措施,强调安全部署是多环节问题,单一指标无法代表模型是否被管住。

技术 › LLM 实践哥 Li 2026-09-288.4 KB 1.1M 809 79

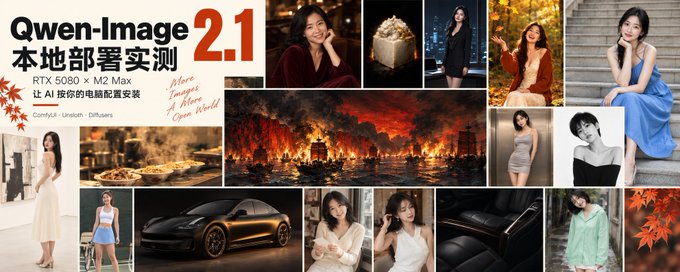
Qwen-Image 2.1 本地部署实战:从此生图自由

本文详细介绍了 Qwen-Image 2.1 图像生成模型的三种本地部署路线:ComfyUI、Unsloth Desktop 和官方 Diffusers。作者首先解释了不同后端权重的差异,指出 DiT、文字编码器和 VAE 三件套需分别下载且不能混用。文章给出了 Windows RTX 5080 与 MacBook Pro M2 Max 两套平台的实测数据:5080 上 1MP 文生图约13秒,M2 Max 单张约10分钟。同时涵盖模型目录结构、extra_model_paths 配置、图像编辑模板用法、常见问题排查及 Qwen Research License 商用限制提醒,是一份可复现的完整部署教程。

技术 › 工具与效率 Fini.Yang 2026-09-279.9 KB 239.9K 599 88

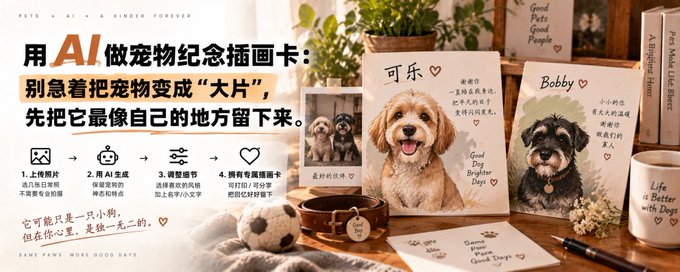
用 AI 做宠物纪念插画卡:先保留宠物最像自己的地方

文章介绍如何用 AI 制作宠物纪念插画卡这一小型数字交付服务。作者强调不要急于把宠物照片变成“大片”,而应保留歪耳朵、斑点等最易识别的特征。建议新手从单只宠物、单一画风的基础款做起,定价 19.9 元测试市场。核心流程包括:先写特征卡再让 AI 绘图、一次出 4 张预览择优、人工核对眼睛耳朵等细节、用 Canva 完成排版并手动输入文字、分四步交付(低清确认、限制修改、导出多版本文件、交付说明)。最后建议先用自己的宠物做样品,通过前 5 单记录数据沉淀为固定流程,实现稳定交付。

技术 › 工具与效率 Christal.Z 2026-09-265.2 KB 9K 42 83

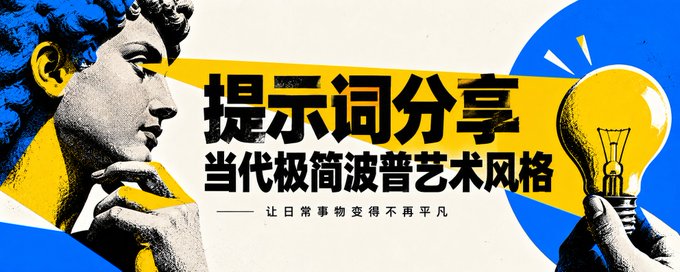
当我开始思考,让波普艺术尝试去做减法

作者分享了一套用于生成「当代极简波普艺术」图像的提示词。该风格继承了波普艺术对大众文化符号的重新编码(放大、重复、裁切、错位),同时用极简主义做减法:一个概念、一个主体、少量颜色、大胆留白。提示词详细规定了视觉隐喻的构建、非对称构图、2-4色色板、文字作为视觉元素参与版式、材质控制,以及针对小红书封面、公众号、推特、海报、专辑封面等不同场景的适配策略,并附有生成前自检清单与最终设计原则。

技术 › 工具与效率 Lucidity 2026-09-2618.0 KB 3.4K 37 78

实测商汤 SenseNova U1 Pro 新模型,我的 8K 生图工作流要换新了

作者实测商汤新发布的 SenseNova U1 Pro 图片生成模型,该模型在 SuperCLUE-Image 中文文生图榜单排名第一。作者从五个维度进行测试:审美与中文版式、多文字运营物料、资料检索与高密度信息、局部修图、多图融合。测试结果显示,该模型在海报设计、菜单与导览图、科普信息图、全诗《琵琶行》等复杂任务中文字稳定性出色,局部编辑精准不破坏其他细节,多参考图融合能力强,并能从刀版图生成可交付的包装渲染图,整体表现超过 GPT Image 2.5。作者认为其达到可交付水平,决定替换到自己的 8K 生图工作流中。

技术 › 工具与效率 卡尔的AI沃茨 2026-09-2515.1 KB 13.5K 12 77