Eval Engineering: the step that turns a $200 model into a $200,000 system
文章探讨了 Eval Engineering 的重要性,指出通过构建评估层,可以将基础模型转化为高价值系统。作者介绍了一种利用现有工具(如 LangChain、AWS 等)搭建评估引擎的方法,强调通过自动化的评估反馈机制来提升 Agent 的准确性和可靠性。
文章探讨了 Eval Engineering 的重要性,指出通过构建评估层,可以将基础模型转化为高价值系统。作者介绍了一种利用现有工具(如 LangChain、AWS 等)搭建评估引擎的方法,强调通过自动化的评估反馈机制来提升 Agent 的准确性和可靠性。
文章探讨了如何通过建立完善的评估系统来防止 AI 智能体随着时间推移而性能下降。作者提出了利用文件夹结构和特定提示词记录规则、错误和边界情况的解决方案,将模糊的“感觉”转化为具体的测试用例,从而确保智能体持续高效工作。
文章介绍了一套专为 Claude Code 设计的 Skill 长期自我进化系统。该系统旨在通过持续的迭代和优化,实现 Skill 的自我成长。核心设计理念包括:采用成对比较替代绝对评分、使用真实日志构建评估集、通过失败模式检测进行优化、利用竞技场机制进行优胜劣汰的变异筛选,以及为审美类 Skill 设定风格锚点。作者强调 Skill 是长期资产,该系统致力于通过日常使用和原则性调整,使其随时间推移变得更可靠。
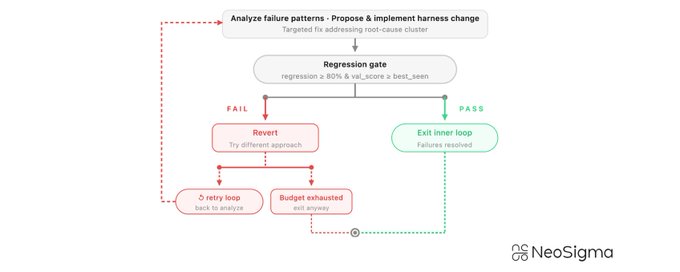
NeoSigma 开源了‘Auto-harness’系统,这是一个自改进循环框架,能将代理失败转化为评估结果并自动修复。实验显示,该系统使 Tau3 基准任务得分提升了 40%。文章探讨了故障聚类、回归门控和子代理管理等关键技术,标志着工程重心从编写代码转向构建能够自我维持和改进的系统。
本文探讨了如何通过改进编排框架来解决 Claude 在长时间运行任务(如前端设计和全栈开发)中的局限性。作者受 GAN 启发,设计了包含规划器、生成器和评估器的多智能体架构。通过引入上下文重置机制、制定明确评分标准以及分离生成与评估环节,该框架成功实现了自主构建高质量全栈应用的能力,显著优于单智能体模式。
Anthropic 官方 Skills 生成器 Skill-creator 迎来重大更新,新增四大核心功能:评估系统、基准测试、多代理并行测试及描述调优。此次升级解决了长期以来 Skills 质量“黑盒”的痛点,通过量化测试(如通过率、耗时、Token用量)和自动迭代优化,显著提升了 Skills 的触发准确率和执行效果。