Wiki 知识库

全部文档 / 标签: 模型优化

13 篇
清除

BestBlogs 早报|YC Paper Club 拆解推理服务系统,Amazon CEO 谈算力供需与投入,Naveen Rao 谈推理经济学

本期早报围绕推理计算的经济与工程展开。YC Paper Club 分享拆解推理请求生命周期,涵盖路由、缓存、分词调度、编译优化与服务质量监测,强调训练之后的服务开销巨大且需要系统性优化;Amazon CEO Andy Jassy 访谈解释了 2026 年 2200 亿美元资本开支背后的建设周期、现金流压力与企业 AI 应用的杠铃格局,指出推理降价将打开更多采用场景;Naveen Rao 则从能源效率视角讨论模型、硬件协同设计,预测推理可能成为 10 万亿美元市场,并探讨规格定义与验证在 AI 自动化交付中的关键作用。速览部分还涉及模型越界安全评估、桥水知识库建设和 AI 个人助理产品竞争。

技术 › LLM ginobefun 2026-10-2530.0 KB 1.5K 1 83

The Math Needed for AI Inference Engineering (Complete Roadmap)

本文系统梳理了AI推理工程所需的核心数学知识路线图。内容涵盖:浮点数表示(FP32/FP16/BF16/FP8/INT8等格式的位分配与精度/范围权衡)、舍入误差累积、溢出与下溢、机器epsilon、灾难性消除及稳定softmax与log-sum-exp技巧;量化数学,包括scale与zero-point线性映射、对称/非对称量化、粒度选择、范围裁剪、激活离群值处理及基于Hessian的曲率方法;以及线性代数计算成本分析,如矩阵乘法的浮点运算量与内存读写开销估算。作者强调在性能分析前能手算层耗时是推理工程中最有价值的习惯。

技术 › LLM vixhaℓ 2026-09-0827.9 KB 93.1K 870 85

KV Cache Engineering for LLM Serving, clearly explained

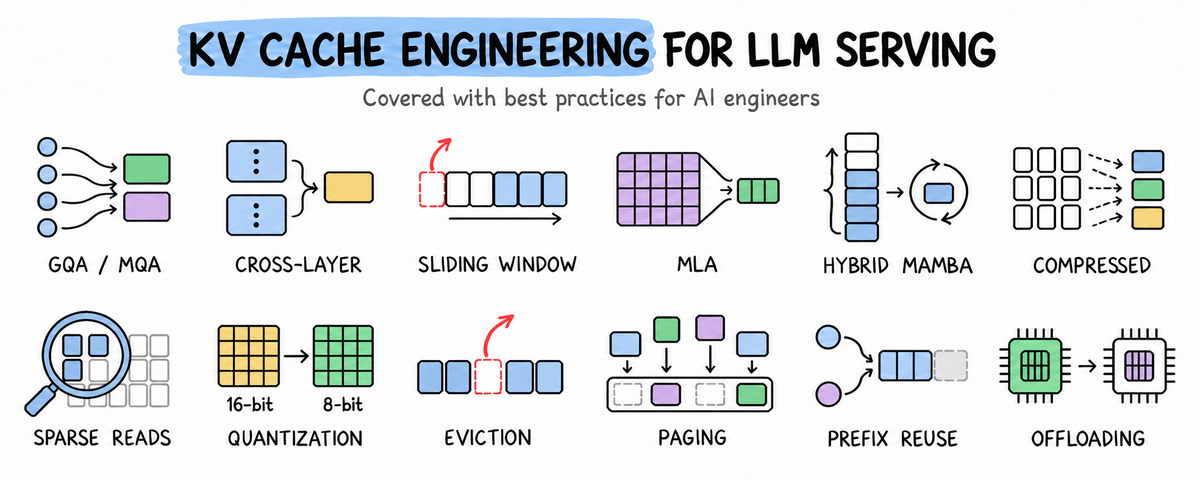
文章系统讲解了LLM推理中KV缓存的工程优化。KV缓存随序列长度增长,Llama 3.1 70B单条128K序列的BF16缓存约需40GB,成为GPU内存和注意力计算的双重瓶颈。作者将12种优化技术按减少的对象分类:GQA/MQA减少KV头数量,跨层注意力减少缓存层数,滑动窗口与淘汰减少保留token数,MLA减少表示宽度,量化减少字节数,混合循环层用固定状态替代增长缓存,分页与前缀复用减少分配浪费。文章配有可运行代码示例,并分析各技术的适用场景与权衡。

技术 › LLM Avi Chawla 2026-09-0640.4 KB 206.5K 557 82

Against agent sprawl: what comes after harnesses

本文探讨了在模型与工具链(harness)协同进化背景下,智能体(agent)数量激增带来的管理挑战。作者指出,前沿实验室将模型与工具链作为整体优化,导致用户需要运行多个异构工具链以控制质量、性能和成本,形成“工具链舰队”。然而,人类注意力有限,成为新的瓶颈。为此,作者提出“depot”(枢纽)作为新的抽象层,集中管理多个工具链,提供状态报告、人工审查、持久执行和内部通信功能,使人类能像管理者一样专注于关键决策。文章强调,审查和评估将成为新的核心工作,并展望了未来工具的发展方向。

技术 › Agent Alex Ker 2026-08-1610.6 KB 49.2K 196 72

The Scaffolding Tax: Investigating the Optimal Harness for a Model

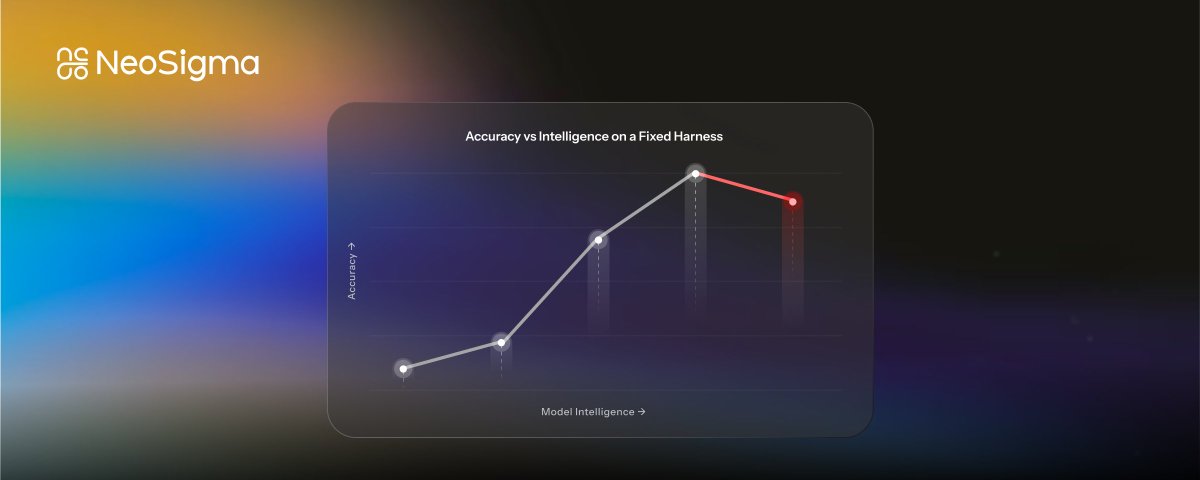
本文探讨了AI代理中模型与脚手架(harness)之间的关系,提出了“脚手架税”概念,即过时的脚手架会抑制更强大模型的表现。通过Terminal-Bench 2.0实验,作者发现固定脚手架在不同模型和推理努力水平下表现不一,强调模型与脚手架需协同优化。

技术 › Harness Engineering NeoSigma 2026-08-1413.9 KB 124.7K 16 72

Eval Engineering: the step that turns a $200 model into a $200,000 system

文章探讨了 Eval Engineering 的重要性,指出通过构建评估层,可以将基础模型转化为高价值系统。作者介绍了一种利用现有工具(如 LangChain、AWS 等)搭建评估引擎的方法,强调通过自动化的评估反馈机制来提升 Agent 的准确性和可靠性。

技术 › Agent Argona 2026-07-2921.7 KB 344.9K 354

Claude 5 模型上下文工程新规则

文章探讨了针对 Claude 5 模型的上下文工程新规则,指出新一代模型能力提升,允许大幅简化系统提示。主要变化包括:用模型判断替代硬性规则、用接口设计替代示例、采用渐进式披露、简化工具描述、使用自动记忆以及支持丰富引用。

技术 › Claude Thariq 2026-07-2510.8 KB

深度流形不是计划的

本文回顾了作者从Health AI到“深度流形”理论的研究历程。作者通过与导师石根华的探讨,发现神经网络与堆叠分片流形、不动点理论存在深刻联系。文章介绍了“蓝领智能”和“学习空间”概念,展示了通过理解学习空间大幅减少模型参数量的实践,并阐述了深度流形在AI数学框架及现实应用中的潜力。

技术 › AI理论 deep Manifold 2026-07-218.4 KB 1.8K 14

The architect's guide to harness engineering: How to choose or build the one for you.

本文是一篇关于 AI 架构工程(Harness Engineering)的指南,探讨了如何根据角色(非工程师 vs 工程师)选择或定制 AI 马具。文章分析了购买、定制和自建三种策略,并提出了评估有用马具的八大属性,涵盖上下文管理、工具支持、标准遵循等维度,旨在帮助读者做出最佳技术决策。

技术 › Harness Engineering Alex Ker 2026-07-1428.4 KB 98.7K 424

Adam's Law:为何高频表达能解锁 LLM 的最强性能

文章介绍了 FaceMind 团队提出的 Adam's Law(文本频率定律),即在语义不变前提下,使用预训练语料中频率更高的表达方式能显著提升 LLM 表现。该发现通过 100 种语言和四大核心任务得到验证,并指出当前数据工程忽视了“频率”这一关键维度。Anthropic 的 Claude Opus 4.7 更新间接验证了这一理论。

技术 › LLM Berryxia.AI 2026-05-3018.7 KB 21.3K 57 89

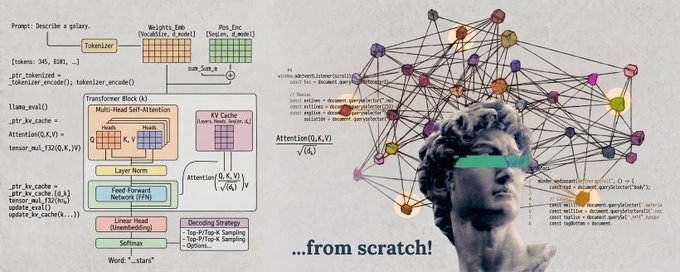
LoRA - LLMs 的低秩适配详解

文章详细介绍了 LoRA (Low-Rank Adaptation) 技术,这是一种用于高效微调大型语言模型的方法。通过冻结原始权重并学习两个极小的低秩矩阵,LoRA 能够在保持模型性能的同时,大幅降低显存占用、训练成本和存储空间。文章还解释了 LoRA 的核心数学原理、具体实施步骤以及为何全量微调成本高昂的原因。

技术 › LLM Amit Shekhar 2026-05-0814.9 KB 10.6K 186 69

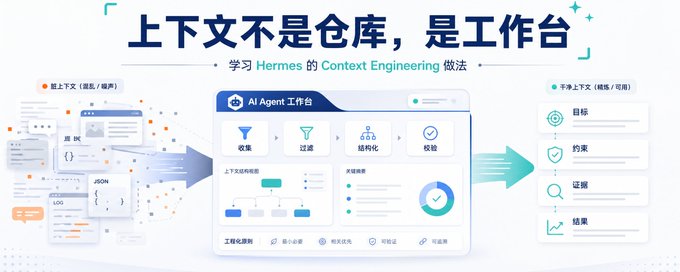
Hermes 给我的最大启发:上下文不是仓库,是工作台

本文指出 Agent 表现不佳往往是因为上下文管理不当,而非模型能力不足。文章引用多项研究证明长上下文不等于高效,并提出应像管理“工作台”而非“仓库”一样管理上下文。作者结合 Hermes 的实践,介绍了外部化记忆、子任务隔离、技能沉淀等策略,并重点推荐使用 XCrawl 等工具清洗网页噪声,以实现低噪、高效的 AI Agent 工作流。

技术 › Hermes 泊舟 2026-04-2818.8 KB 22.9K 95 79

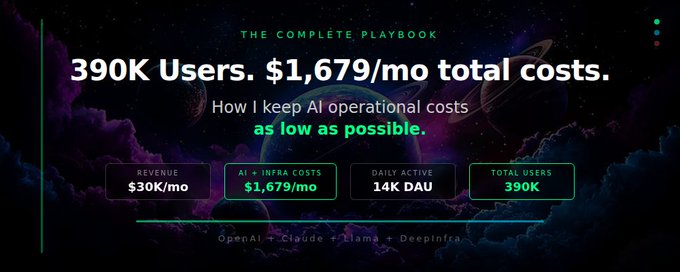
AI App 省钱指南:如何将月度账单控制在 1700 美元以内

作者分享了运营两个拥有 39 万用户的 AI 应用的实战经验,通过模型路由策略和智能缓存技术,成功将 AI 成本控制在每月 1700 美元。文章详细剖析了不同 OpenAI 模型的成本差异,并提供了针对简单、中等和复杂任务的最佳模型选择指南。

技术 › LLM Alex Nguyen 2026-04-1654.2 KB 13.4K 173 82