模型部署后的无标注自进化:SERPO机制解析
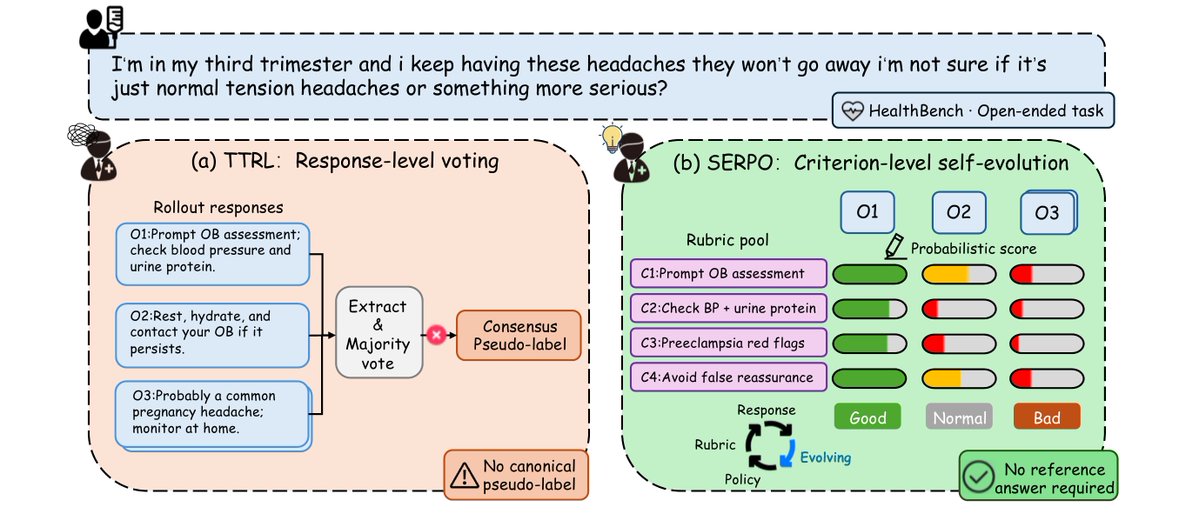
现有无标注强化学习(TTRL)多依赖多数票生成伪标签,难以处理医疗建议等复杂开放式任务。为此,文章提出SERPO(自进化判据策略优化)机制。它通过模型自身采样的回答提取质量判据生成奖励,无需任何外部监督或人工标注,并将收益直接写入模型权重。实验表明,SERPO不仅大幅提升了模型在垂直领域的性能,且在OOD测试和长程训练中持续进化,证明了其能将质量标准转化为持久的模型能力。
现有无标注强化学习(TTRL)多依赖多数票生成伪标签,难以处理医疗建议等复杂开放式任务。为此,文章提出SERPO(自进化判据策略优化)机制。它通过模型自身采样的回答提取质量判据生成奖励,无需任何外部监督或人工标注,并将收益直接写入模型权重。实验表明,SERPO不仅大幅提升了模型在垂直领域的性能,且在OOD测试和长程训练中持续进化,证明了其能将质量标准转化为持久的模型能力。
