Wiki 知识库

全部文档 / 标签: 模型部署

13 篇
清除

Hugging Face 详细教程:从调用模型到微调与部署

本文是一篇 Hugging Face 平台的系统教程,从零讲解大模型开发的完整工作流:安装环境、登录 Hub、用 Pipeline 快速推理、理解 Tokenizer、加载模型、使用 Datasets 处理数据、用 Trainer 微调模型、通过 LoRA/PEFT 高效微调大模型、上传模型到 Hub,以及用 Spaces 部署 Gradio Demo。文章还涵盖模型选择要点、常见问题排查(如显存不足、tokenizer 配置、训练效果差)和分阶段学习路线,并附官方文档链接,适合想将大模型真正用起来的开发者入门与进阶。

技术 › 工具与效率 Mr Panda 2026-10-0712.1 KB 9.3K 40 80

AI 工程师需要了解的 GPU 全部知识

本文面向 AI 工程师系统讲解 GPU 硬件知识:GPU 的三种类型(数据中心、工作站、个人级),内部结构(SM、Tensor Core、CUDA 核心、HBM 显存与 SRAM 缓存),并以 gpt-oss-120b 和 Kimi K3 两个开源 MoE 模型为例,用精确的数学计算说明推理的算力与显存带宽瓶颈、prefill 与 decode 的差异,以及训练与推理对 GPU 使用的不同需求,帮助工程师做出租用 GPU、模型部署等实际决策。

技术 › LLM Karan 2026-10-0219.3 KB 55.1K 427 82

How to train your own Jev for $17

本文介绍如何以约17美元的成本微调一个类似Jev的高效分类模型。作者基于Qwen3.5 4B,从MultiNLI、BoolQ、Banking77、AG News、SST-5等多个Hugging Face数据集中采样约3.8万个样本,通过脚本归一化数据后,使用Together AI的Fine-tuning服务启动训练任务(约25分钟完成),再将模型部署到Together AI的专用端点(dedicated endpoint),并通过API查询模型完成分类任务。文中还发布了可直接使用的together/Tev1-4B-experimental模型,适用于客服意图识别、文本情感分析、论文分类等实际场景,涵盖从环境搭建、数据准备、训练到部署查询的完整流程。

技术 › LLM Hassan 2026-09-2412.4 KB 822.4K 2K 76

如何用自己的数据微调一个小模型

本文是翻译整理的完整小模型微调指南(原作者Rahul),主张用1.5B参数模型配合200-500条高质量样本微调,即可在特定任务上超越通用前沿大模型。文章涵盖微调的正确认知(微调非提升智能而是稳定窄任务)、三个基线建立、选择Qwen2.5-1.5B等小基座模型、数据权利确认、PDF/OCR文本抽取与清洗、按公司切分数据集、QLoRA训练超参配置、幻觉数字检测评测、vLLM部署及监控重训策略。强调数据合规和评测纪律是真正值钱的部分,附完整可运行代码。

技术 › LLM yibie 2026-09-2010.3 KB 213.6K 1.1K 86

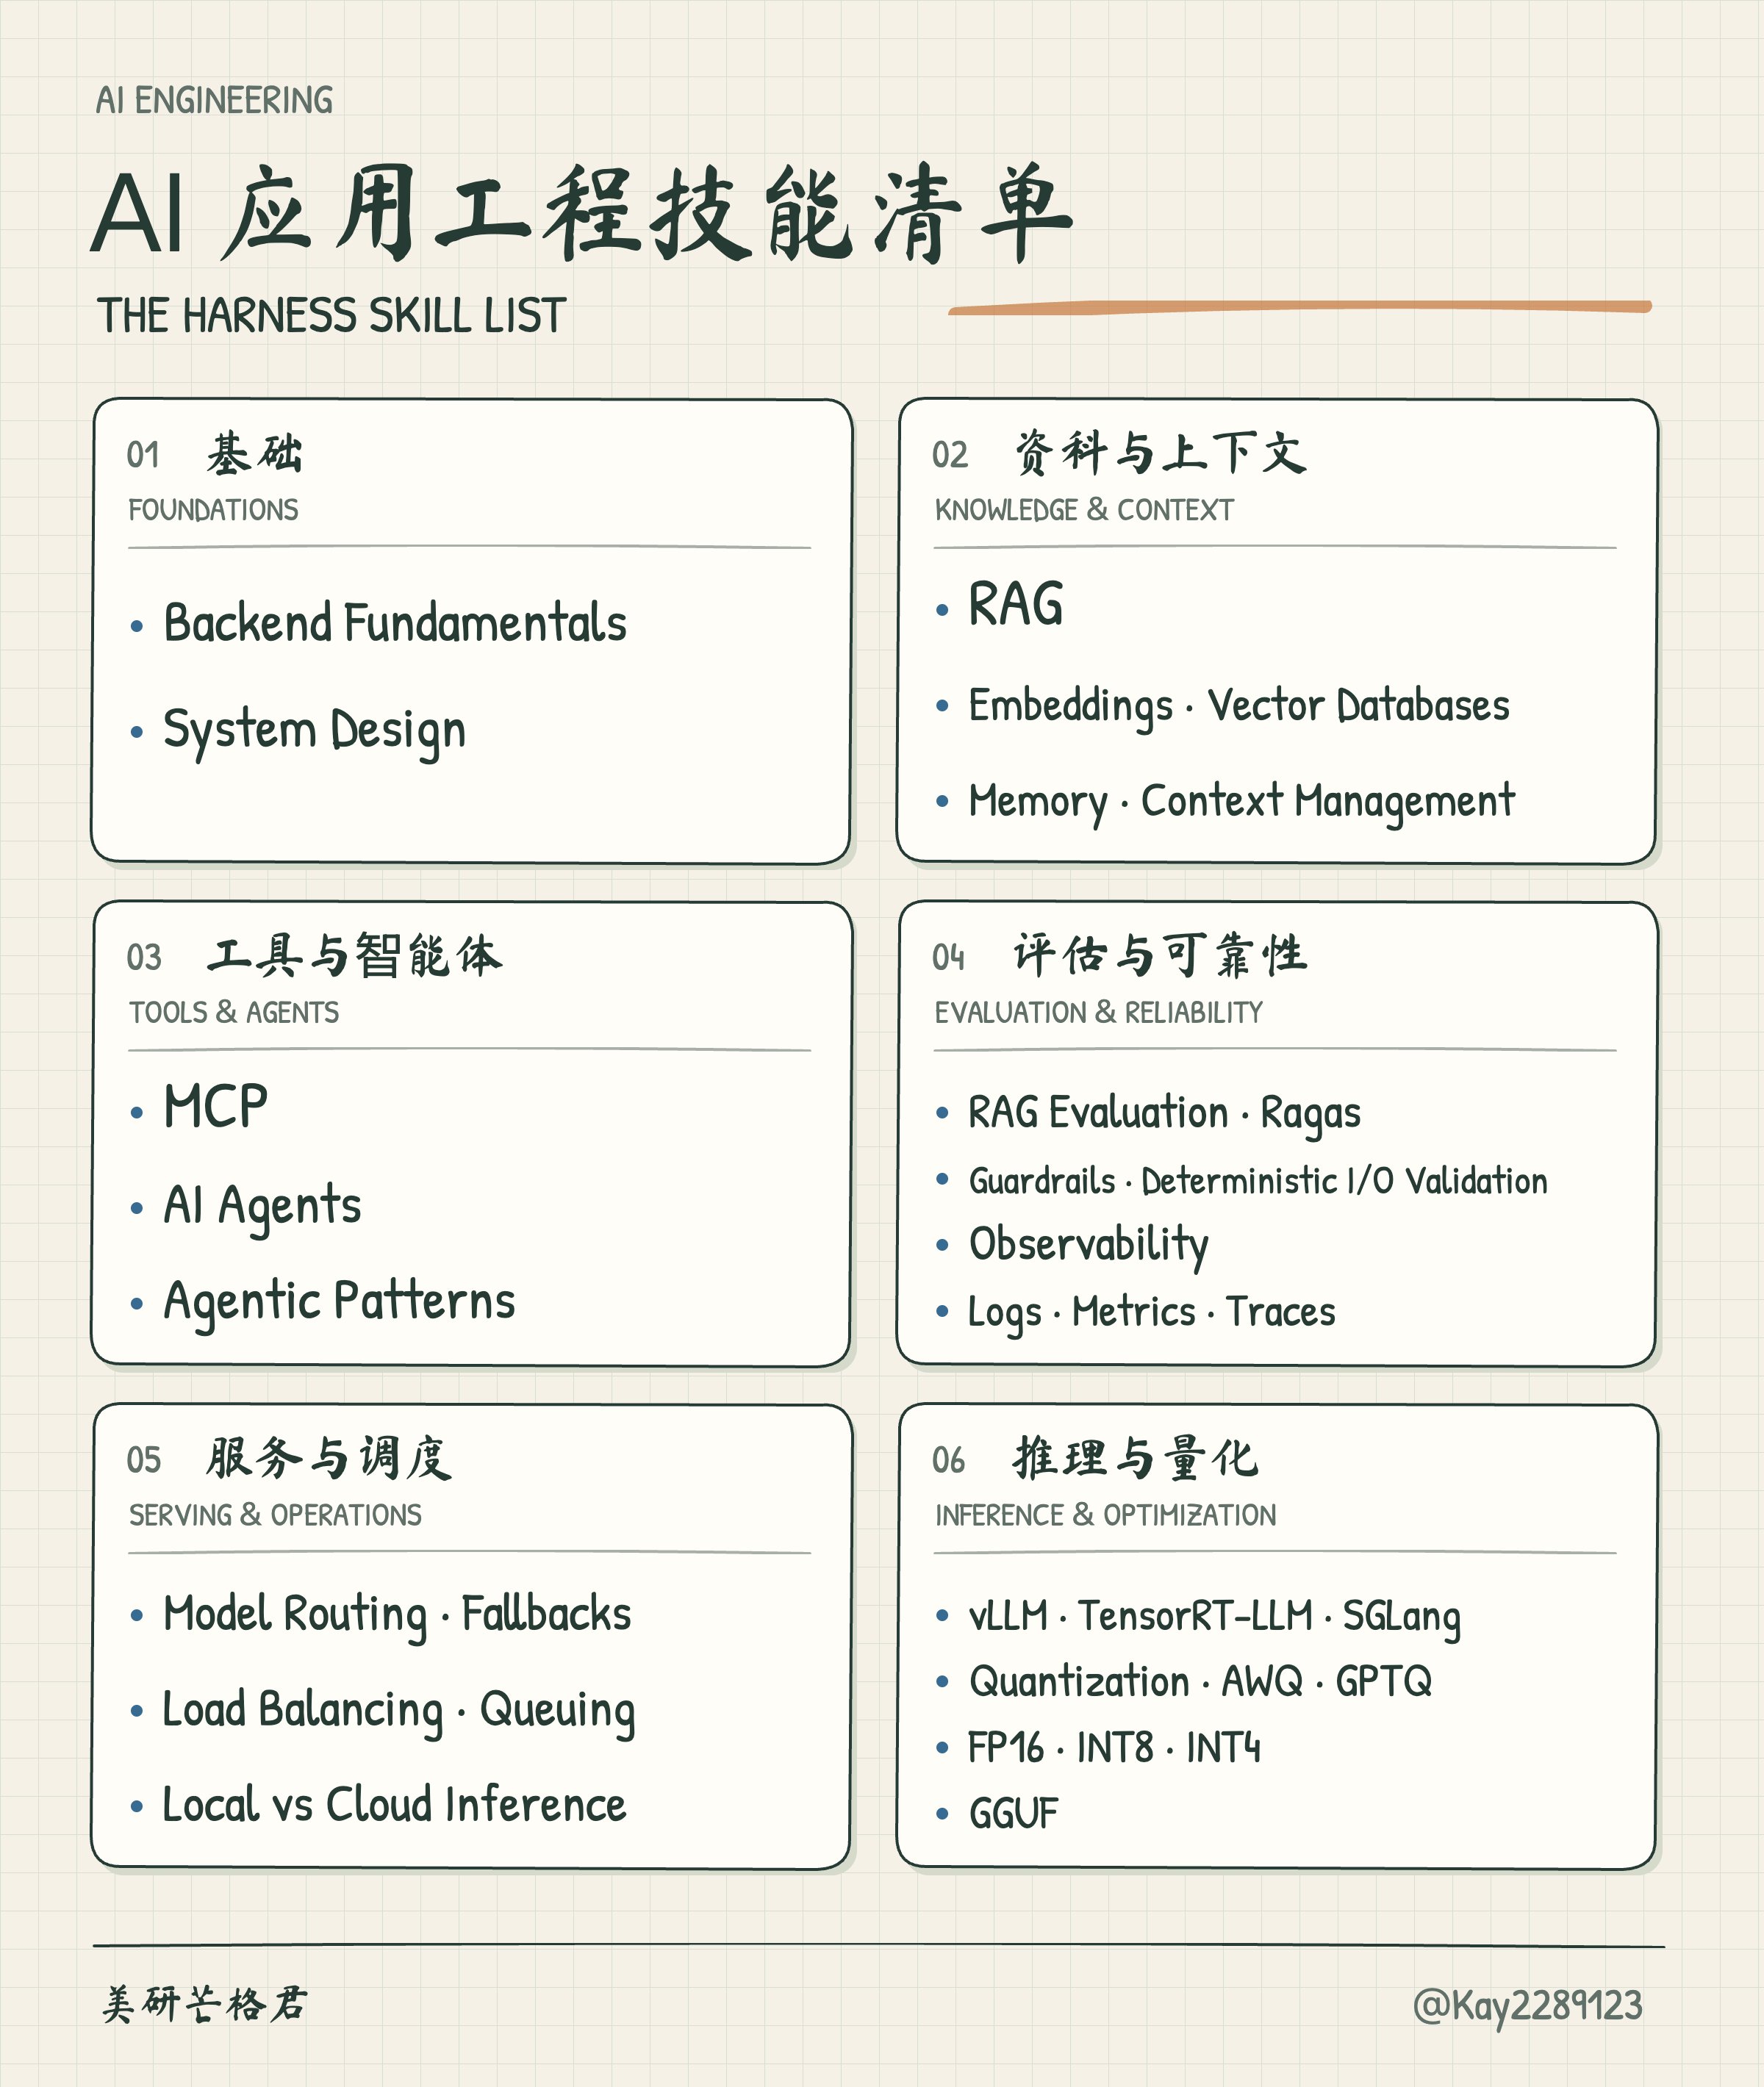
如果你想做 AI 应用不妨考虑一下 Harness 开发

作者结合实际工作经验,整理出一份 AI Harness 开发的 11 条技能清单,涵盖后端与系统设计、RAG 与向量数据库、记忆与上下文管理、工具调用与 MCP、Agent 编排、护栏校验、评测、可观测性、模型路由降级、排队负载均衡以及推理部署引擎。作者指出 Harness 开发是硅谷热门方向(如 YC Demo Day 上大量项目),建议普通开发者从 AI 应用入手,把模型接入具体业务,并给出将清单交给 AI 逐项学习的 prompt 方法。

推理工程入门指南

本文介绍了推理工程的概念、重要性及入门方法。推理工程负责在满足产品需求(正确性、响应时间、可靠性和成本)的前提下运行已训练模型,涵盖模型选择、评估、服务、性能优化和运维。软件工程师可凭借API设计、性能分析、缓存等技能进入该领域。文章通过vLLM、SGLang和llama.cpp三个开源项目,展示了如何解决高并发、重复计算和硬件适配等实际问题,并强调定义工作负载和复现问题的重要性。

技术 › LLM danialhasan 2026-09-1418.6 KB 54.5K 526 78

MLOps 可视化详解:完整生命周期指南

本文以图解方式系统讲解 MLOps(机器学习运维)的完整生命周期,解决模型从 Notebook 到生产环境的落地难题。内容涵盖六大阶段:数据管理与版本化(Airflow、DVC)、实验追踪(MLflow、W&B)、模型注册与验证、部署与服务(Docker、Kubernetes、CI/CD)、生产监控(数据漂移、性能衰减检测)以及自动化重训练。文章还介绍了 MLOps 成熟度模型,从手工操作到全自动 CI/CD/CT 的演进路径,强调 MLOps 是一个持续循环而非一次性部署。

技术 › DevOps Tech Fusionist | Kushal Gangil 2026-09-1210.5 KB 14.3K 172 74

第一次下载本地大模型,如何看懂 Hugging Face 上的各种参数?

本文面向第一次在 Hugging Face 下载本地大模型的用户,讲解如何理解各种参数和名词。作者提出把整条链路分为五层:硬件资源、模型本身、权重精度与量化、文件格式、推理框架。文章依次解释了显存与统一内存的区别、参数量与文件大小的估算、Dense 与 MoE 架构差异、Base/Instruct/VL 等版本选择、BF16/FP8/4bit 等精度概念、GGUF 格式与量化方案、Safetensors 分片与配置文件、Hugging Face 页面阅读顺序,以及 MLX、llama.cpp、Ollama、LM Studio 等工具的关系,帮助新手不再凭文件名猜测下载。

技术 › LLM 雪瑜 2026-09-0118.8 KB 19.3K 196 86

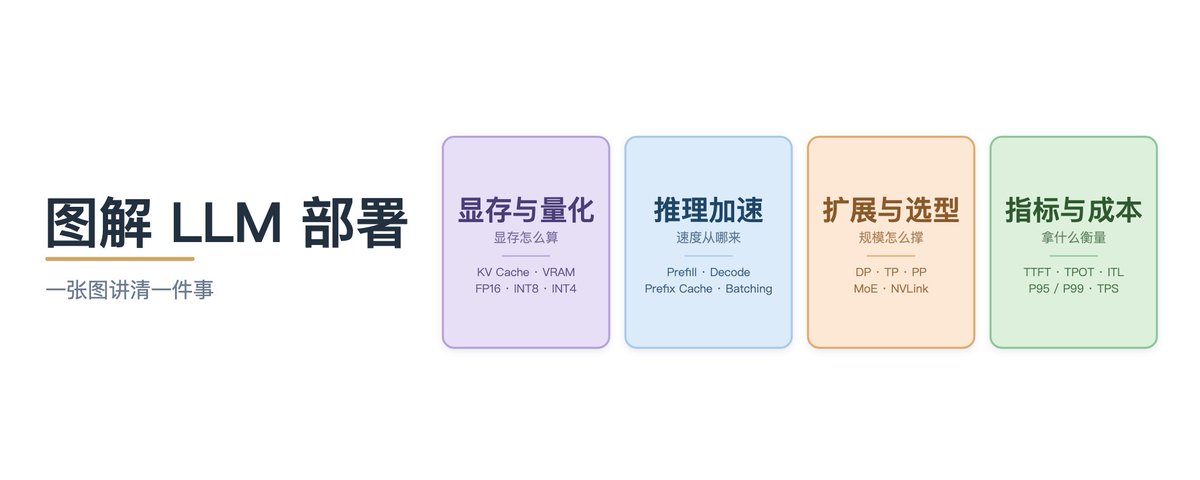
图解大语言模型部署

本文系统讲解大语言模型自部署的核心指标与实践要点,覆盖延迟类指标(TTFT、TPOT/ITL、P95/P99)、吞吐类指标(TPS、QPS、连续批处理)、资源类指标(显存与KV cache计算、量化精度)、服务质量(错误率、探针、可用性)以及成本核算(cost per token、TCO)。作者以 Ling-3.0-Flash MoE 模型在 DGX Spark 上的真实实测为例,将抽象指标落地为具体数字,帮助读者选对硬件配置、排查吞吐瓶颈与OOM问题、评估自建与API的划算临界点。

技术 › LLM WquGuru 2026-08-2927.1 KB 56.2K 199 89

MiniMax H3 双 4090 本地部署实操教程

本文详细介绍了在 Windows 宿主 + Linux Docker 容器环境下,使用双 RTX 4090(48GB)本地部署 MiniMax H3 视频生成模型的完整过程。内容包括本地部署的优势(成本、隐私、可控性)、双 GPU 架构分工、宿主机目录布局、模型文件清单、Docker 容器创建、启动验收、已验证的推理链、速度实测、分辨率与帧数注意事项、最小生成验证流程、复现清单以及生产链必需节点。文章提供了具体的配置命令和参数,并强调了可复现性的重要性。

技术 › 工具与效率 雪踏乌云 2026-08-1413.0 KB 22.2K 63 89

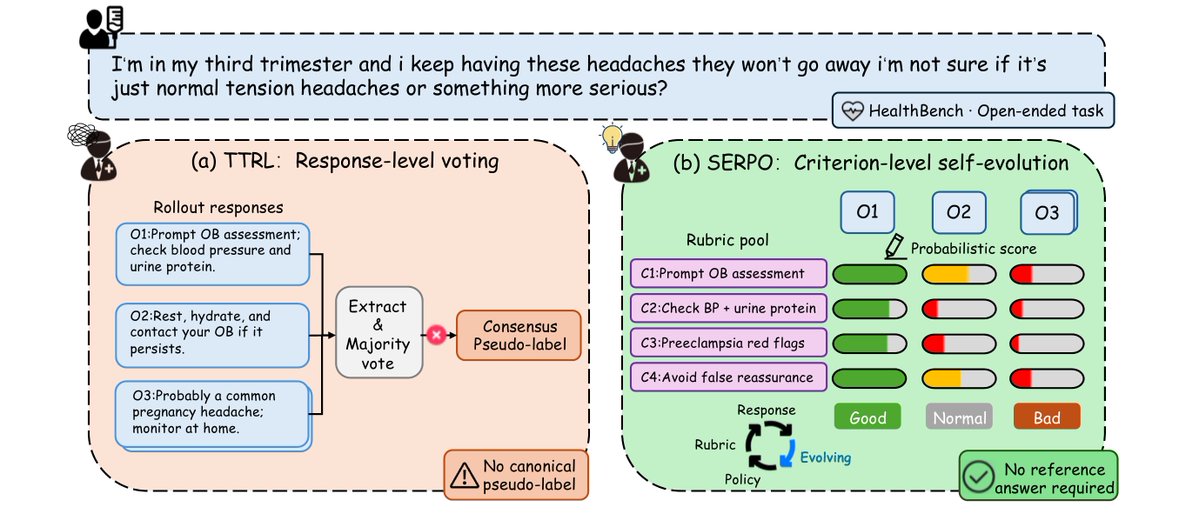
模型部署后的无标注自进化:SERPO机制解析

现有无标注强化学习(TTRL)多依赖多数票生成伪标签,难以处理医疗建议等复杂开放式任务。为此,文章提出SERPO(自进化判据策略优化)机制。它通过模型自身采样的回答提取质量判据生成奖励,无需任何外部监督或人工标注,并将收益直接写入模型权重。实验表明,SERPO不仅大幅提升了模型在垂直领域的性能,且在OOD测试和长程训练中持续进化,证明了其能将质量标准转化为持久的模型能力。

技术 › LLM 青稞社区 2026-08-1018.5 KB 2.7K 16 87

使用 Fireworks Agent 自动化 LLM 微调全流程

本文介绍了如何利用 Fireworks Agent 实现 LLM 微调(SFT)的全自动化。文章以 Andrej Karpathy 的“个人 LLM Wiki”理念为引,阐述了将知识注入模型权重比单纯依赖上下文窗口更高效。通过 Fireworks Agent,作者展示了从数据集检查、超参数搜索、模型训练到部署推理的完整闭环,无需人工干预繁琐步骤,仅需少量 GPU 时间和极低成本,即可训练出具有特定输出风格(如 Wiki 摘要风格)的模型,为构建自我进化的 Agent 铺平了道路。

技术 › Agent elvis 2026-05-2115.5 KB 46.8K 110 83