vLLM 架构之美:PagedAttention 与 Continuous Batching 解析
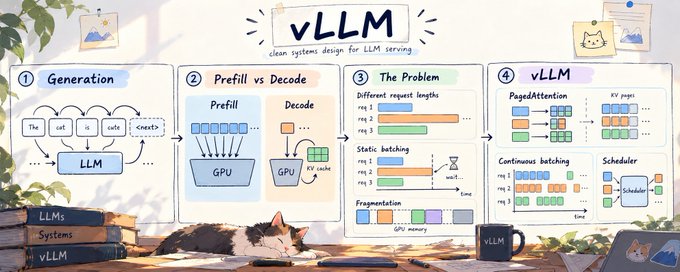
作者赞颂 vLLM 的软件设计之美。文章首先介绍 LLM 自回归生成的基本原理,以及推理的两个阶段:计算密集的 Prefill 和带宽受限的 Decode,指出 KV Cache 动态增长与静态批处理带来的内存浪费问题。vLLM 借鉴操作系统分页思想,将 KV Cache 切分为固定大小的块并维护逻辑到物理的块表(PagedAttention),将内存浪费降至约 3%;配合 Continuous Batching 和动态调度,避免已完成的请求阻塞整个批次,让 GPU 始终保持高效。作者认为 vLLM 的成功源于借鉴已被大规模验证的成熟系统概念。