Wiki 知识库

全部文档 / 标签: vLLM

29 篇
清除

AI 每日早报:DeepSeek 开源推理框架、Google TPU 推理引擎与 Anthropic 的 AI 队友实践

本期早报聚焦三条主线:一是 DeepSeek 全面开源内部推理框架 DeepInfer 与生产级 Token 编解码组件 deepseek-recipe,覆盖分布式推理、推测解码、结构化输出等能力,兼容英伟达与昇腾平台;二是 Google 为 vLLM 和 SGLang 推出原生 PyTorch TPU 后端,通过 TorchTPU、分层缓存与 TPU Sync 优化多轮 Agent 场景下的推理性能;三是 Anthropic 团队分享 Claude 如何从问答助手成长为承担团队职责的协作伙伴,涵盖追踪表维护、内部应用开发与会议协调等案例。速览部分还介绍了小红书 ROSS 训练方法、FairStress 公平性评估基准、Dyna Robotics 机器人 Scaling Law 及 SGLang 低延迟模式。

技术 › LLM ginobefun 2026-10-2128.3 KB 1.7K 1 77

想转 FDE?一个干了 4 年多的人告诉你:这活从开会聊需求,到私有化部署,都得会

作者基于4年多车企AI落地经验,按项目全流程拆解FDE(Frontier Development Engineer)岗位的真实工作内容:售前阶段的客户预期管理、深入业务打磨几千个标签体系、模型开发(从BERT加规则演进到大模型抽取加检索链路,涉及微调、embedding、评测)、私有化部署的工程细节(驱动、CUDA、vLLM、压测、稳定性)、以及上线后的数据报告与可视化。作者强调模型只是最不用担心的部分,难的是模型前后的业务与工程,并介绍了AI coding如何让他一个人交付客户demo。
技术 › LLM Simon聊AI 2026-10-0929.3 KB 26.1K 87 86

「Learn Inference」LLM 推理工程全景指南:从 Attention 内核到多云 GPU 容量,两阶段、三层栈、五大技巧

本文是 Philip Kiely 所著《Inference Engineering》的交互式伴读站点介绍,系统梳理 LLM 推理工程全貌。文章以 prefill/decode 两阶段为原子结构,按运行时、基础设施、工具链三层展开,逐章讲解模型结构(Attention、KV 缓存、MoE)、GPU 硬件选型(带宽 vs 算力)、软件栈(vLLM、SGLang、TensorRT-LLM)、五大优化技巧(量化、投机解码、缓存、并行、解耦)以及多模态与生产实践(扩缩容、路由、成本、可观测性)。核心思想是:先诊断瓶颈再优化,一切优化皆是权衡,具体知识会过期而底层约束移动缓慢。

技术 › LLM meng shao 2026-09-2918.6 KB 3.4K 11 86

把 GLM-5.3-Flash 变成一个 Jev 式的 System One 模型

本文介绍一种无需微调的方法,把现成的 LLM(GLM-5.3-Flash)变成类似 Jev 的专用决策模型(System One 模型)。核心做法是给选项编号、预填答案、通过读取选项索引上的概率分布,让模型在一次前向传播中给出类型化决策及其置信度。文章详细说明了 vLLM 部署中的三个实现细节(allowed_token_ids、logprob_token_ids、tokenizer 分词),并在 29 个公开数据集上与 Jev、Laya 进行基准对比:文本决策准确性与 Jev 相当,延迟相近但成本较高;由于具备视觉能力,还能做图像上的类型化决策,这是 Jev 和 Laya 做不到的。文章还讨论了推理模式的准确性收益与成本代价、选项数量与重命名对结果的影响,并开源了实现与基准代码。

技术 › LLM yibie 2026-09-2814.3 KB 2.8K 17 87

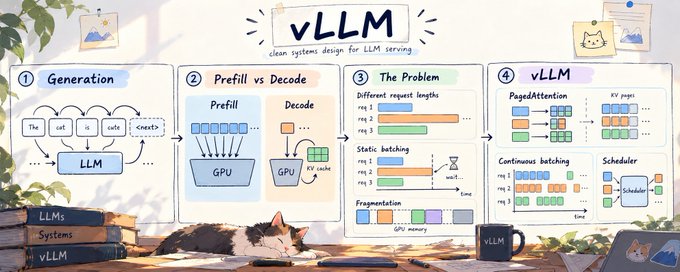
vLLM 架构之美:PagedAttention 与 Continuous Batching 解析

作者赞颂 vLLM 的软件设计之美。文章首先介绍 LLM 自回归生成的基本原理,以及推理的两个阶段:计算密集的 Prefill 和带宽受限的 Decode,指出 KV Cache 动态增长与静态批处理带来的内存浪费问题。vLLM 借鉴操作系统分页思想,将 KV Cache 切分为固定大小的块并维护逻辑到物理的块表(PagedAttention),将内存浪费降至约 3%;配合 Continuous Batching 和动态调度,避免已完成的请求阻塞整个批次,让 GPU 始终保持高效。作者认为 vLLM 的成功源于借鉴已被大规模验证的成熟系统概念。

技术 › LLM Atharva 2026-09-275.1 KB 21K 401 56

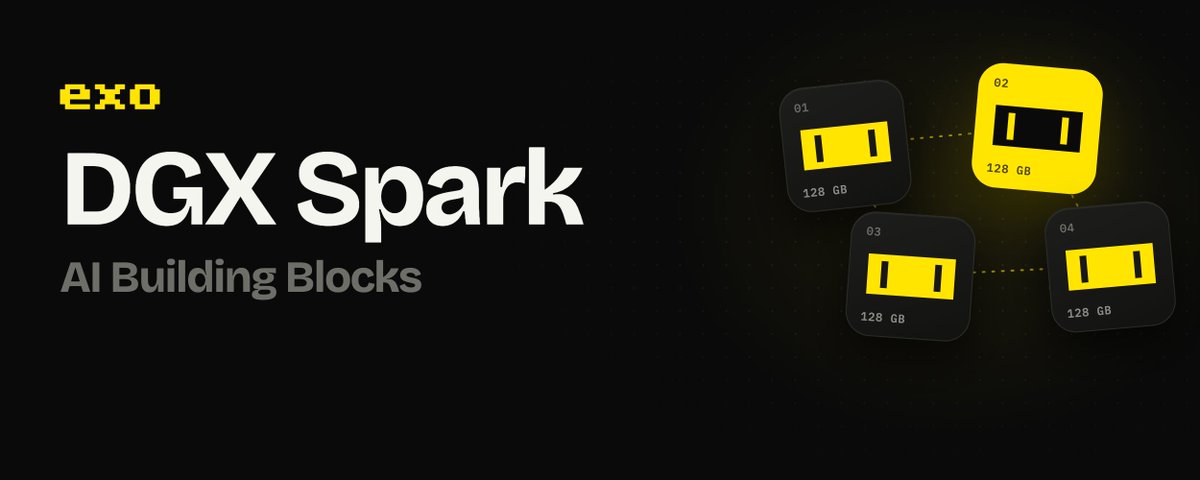
DGX Spark Handbook

本文是 NVIDIA DGX Spark 本地推理设备的使用手册。作者最初因其 273 GB/s 的低内存带宽而不看好,但随着 MoE 架构、推测解码等推理工程技术的成熟,DGX Spark 已能在本地以接近云服务的速度运行高智能模型。文章详细介绍了多台 Spark 通过 ConnectX-7 网卡链接实现近线性扩展带宽和内存的方案(四台可达 1092 GB/s、512 GB 内存)、低功耗适合家用部署的优势、MoE 与推测解码如何弥补硬件短板,以及单机同时服务 8 个并发会话的能力,并对比了与 Mac 的算力优势和成本分析。

技术 › LLM EXO Labs 2026-09-2651.7 KB 256.4K 703 75

在安全边界内运行私有本地 AI 的四种架构

文章指出企业 AI 部署并非只有'公有 API 或自建推理平台'的二选一,私有 AI 实际是一个从客户端设备到完全物理隔离的连续谱系。作者提出四种隔离层级:1) 使用 LiteRT、Gemini Nano 等在移动 NPU 和浏览器上进行零外泄客户端推理;2) 通过 Confidential Computing(机密虚拟机与 NVIDIA H100 TEE)对云端 CPU/GPU 内存硬件级加密;3) 在私有 VPC 内用 GKE + vLLM/JetStream 自托管开源模型权重,实现权重与日志的完全掌控;4) 使用 Google Distributed Cloud Air-Gapped 为主权工作负载提供物理断网部署。工程关键在于按威胁模型和延迟预算匹配硬件边界。

技术 › 网络安全 Sergio Villani 2026-09-2612.8 KB 30.4K 208 84

深读免费书「Inference Engineering」:Prefill 吃算力、Decode 吃带宽,讲透从 CUDA 到生产部署的推理优化

文章深度解读 Baseten 出版的免费工程书《Inference Engineering》,系统讲解如何把 AI 模型在生产环境中跑得快、省、稳。全书以三层推理栈(运行时、基础设施、工具层)为骨架,核心分析框架是瓶颈判断:prefill 算力受限、decode 带宽受限、图像视频生成算力受限。内容涵盖模型与硬件理解(算术强度、KV cache、选卡策略)、软件栈(vLLM/SGLang/TensorRT-LLM 三大引擎对比)、五大加速技术(量化、投机解码、缓存、并行、分离部署)及其交互关系,以及生产化部署的延迟全栈账本、故障处理与成本核算,强调约束换性能、技术按组合评估等基本原则。

技术 › LLM meng shao 2026-09-2111.2 KB 13.1K 145 84

某二次元 AIGC 团队 Infra 组招聘:地狱周收获与招人启事

作者介绍了其所在的二次元 AIGC 顶尖团队的 Infra Team,职责涵盖 SRE、Data Infra、推理与训练基础设施建设、安全及 AI Infra 等。团队定位为偏 Infra 的 Product Engineer,与业务深度协作,目标是让服务变得更好。作者分享了地狱周成果:完成全服务 Service Mesh 化、迁移至 Istio Gateway、搭建 1:1 测试集群并完成压测和故障演练,零事故完成机房维保。团队注重效率与沟通,反对纯 AI 生成文档,招聘 SRE、推理、研发效能三个方向的校招到 Senior 人才。

LLM Inference After Training: Prefill, Decode, KV Cache

本文系统讲解 LLM 推理阶段的核心原理。作者指出推理与训练不同,分为 prefill 和 decode 两个阶段:prefill 并行处理整个提示词、计算密集型、决定首 token 延迟(TTFT);decode 逐 token 生成、受 HBM 内存带宽限制、决定 token 间延迟(ITL)。文章介绍了 GPU 关键硬件概念(Tensor Core FLOPS、HBM、SRAM),逐步演示一个请求的完整流程(分词、采样、KV cache 机制),并将 FlashAttention、PagedAttention、continuous batching、RadixAttention 等优化技术归位到这两个阶段中,帮助读者理解推理瓶颈与优化方向。

技术 › LLM Karan 2026-09-1713.8 KB 29.4K 187 83

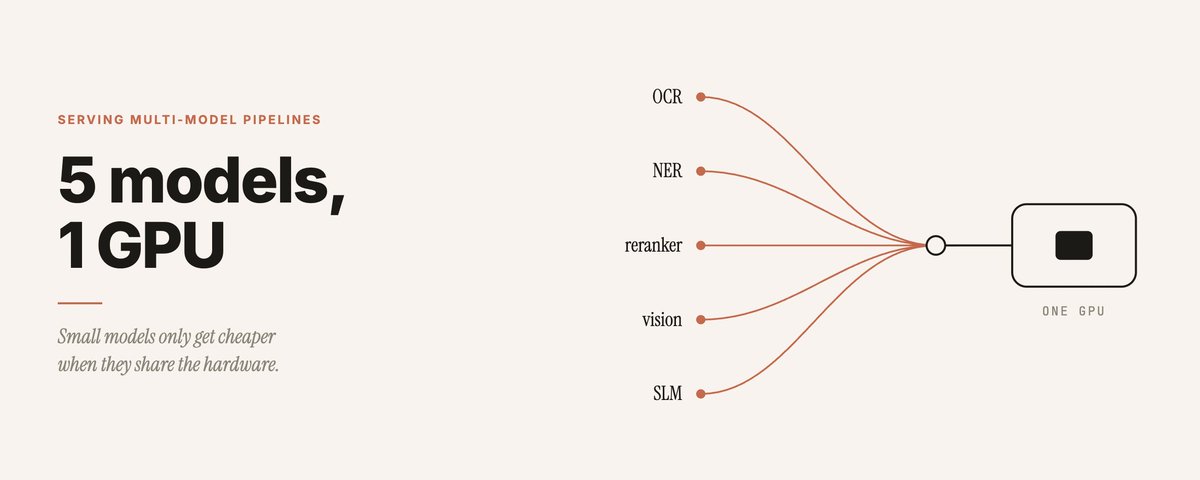
如何在一张 GPU 上服务 100 个微调模型

文章介绍如何在单张 GPU 上高效服务大量 LoRA 微调模型。将适配器合并进基座会为每个变体生成 15.2GB 的完整模型副本,而分开保存适配器只需约 40MB,共享基座后 100 个变体仅占 19.3GB。作者对比了四种部署形态(合并独立 endpoint、启动时注册、请求时解析、托管按租户),并在 Runpod 上用 Qwen 1.5B 训练三个 LoRA 适配器做实验。结果显示共享 endpoint 复用 worker 池,显著减少冷启动与显存浪费;同时强调应分开记录等待时间与执行时间,并通过镜像缓存优化冷启动延迟。

技术 › LLM yibie 2026-09-1611.8 KB 5.4K 38 86

CMP 170HX矿卡软件解锁:8GB显存解锁到64GB,价格涨三十倍的背后

NVIDIA专为挖矿打造的CMP 170HX矿卡,采用与A100相同的GA100芯片,但出厂通过OTP熔丝、寄存器和PCIe限制被锁死显存、算力和接口。2026年8月,研究员Jon Pry利用Falcon安全协处理器的固件校验时间窗口漏洞,通过ROP链获取执行权并修改PLM寄存器,实现纯软件解锁,开源工具CMPUnlocker可将8GB显存解锁至64GB HBM2e。解锁后带宽媲美RTX 5090,跑LLM推理性能反超4090。MiniMax H3开源引发大显存需求暴涨,卡价从三五百涨至1.4万。但文章也提醒风险:无FP8、无NVLink、驱动受限、HBM颗粒不可维修、价格窗口已关闭。

技术 › LLM huangserva 2026-09-159.2 KB 20.3K 38 81

推理工程入门指南

本文介绍了推理工程的概念、重要性及入门方法。推理工程负责在满足产品需求(正确性、响应时间、可靠性和成本)的前提下运行已训练模型,涵盖模型选择、评估、服务、性能优化和运维。软件工程师可凭借API设计、性能分析、缓存等技能进入该领域。文章通过vLLM、SGLang和llama.cpp三个开源项目,展示了如何解决高并发、重复计算和硬件适配等实际问题,并强调定义工作负载和复现问题的重要性。

技术 › LLM danialhasan 2026-09-1418.6 KB 54.5K 526 78

LLM 推理引擎到底是怎么工作的:从 token 到 KV 缓存、连续批处理,再到 Agent Loop

文章基于 TogetherAI 团队 Zain 的分享,沿一个请求的完整生命周期拆解 LLM 推理引擎(vLLM、SGLang、TensorRT-LLM)的内部机制。核心洞察是:prefill 计算受限、decode 内存带宽受限;KV cache 用空间换掉平方级计算,但成为显存瓶颈。引擎通过连续批处理让 GPU 每 pass 都不空闲,PagedAttention 像操作系统管理内存一样管理 KV cache(碎片率从 60-80% 降到 4% 以下),chunked prefill 摊平长 prompt 带来的延迟尖峰。Agent 循环因每轮重发完整对话、输入越来越长而输出极短,使其痛点落在 prefill 与 KV cache 上:prefix caching 可将 100 轮 agent 的总 prefill 工作量从约 55 倍降到约 10 倍,'缓存为王'是 agent 与引擎的交汇点。

技术 › LLM meng shao 2026-09-139.5 KB 46.7K 414 81

The Inference Engineering Skills Map

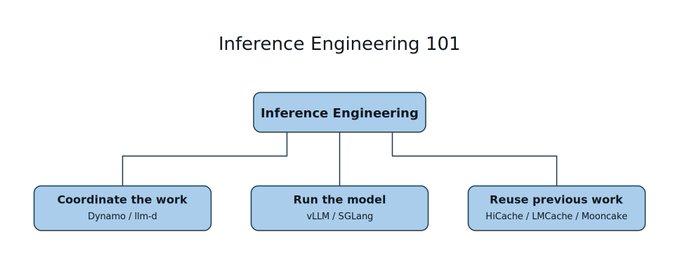
作者从 B2B SaaS Web 开发转向推理工程一个月后分享的入门知识地图。文章将推理工程分为三大类:协调工作(Nvidia Dynamo、llm-d 负责路由、调度与扩展,需智能负载均衡)、运行模型(vLLM、SGLang 处理批处理、张量并行、prefill/decode 分离)、复用先前工作(KV 缓存与 HiCache、LMCache、Mooncake 实现跨 GPU/CPU/NVMe 的分层前缀缓存)。作者强调从 Web 开发转型并不难,不需要精通 CUDA,先跑起模型、发送流量,再逐层深入即可。

技术 › 后端 Nick Khami 2026-09-118.5 KB 17.7K 512 73

vLLM x AgentX: Optimizing for Real-World Agentic Serving

本文介绍 vLLM 针对 Agentic 工作负载的服务优化方案。Agentic 流量具有多轮长会话、长上下文短输出、高前缀复用率和大量子代理调用的特点,对成本与延迟提出双重要求。在 SemiAnalysis 发布的 AgentX 基准上,vLLM 在 DeepSeek V4 Pro 上达到每 GPU 秒 130K tokens,在 MiniMax M3 上交互速度达 376 tokens/s,相比 Opus 5 API 定价有 14.6×–106× 的成本优势。文章详细阐述了数据平面的混合 KV cache 管理与分层卸载、执行平面的并行与内核优化,以及控制平面的 P/D 分离调度等全栈优化方法。

技术 › LLM vLLM 2026-09-0931.2 KB 41.2K 328 78

Static vs. Dynamic vs. Continuous Batching in LLMs, clearly explained

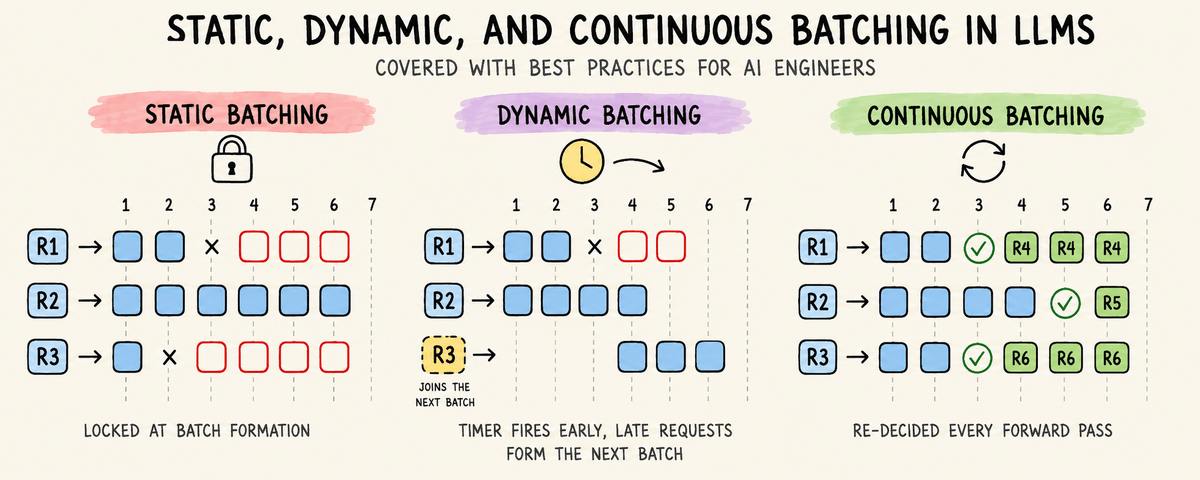
文章从第一性原理剖析了 LLM 推理服务中三种批处理策略。现代 GPU 在 LLM 解码时受显存带宽限制,计算单元大量空闲,批处理可将权重读取成本分摊到多个序列以提升吞吐。由于自回归解码的输出长度不可知、序列间相互依赖,传统批处理存在短板:静态批处理在批开始时一次决定,受最慢成员拖累;动态批处理加入定时器,缓解入批等待但仍整批绑定;连续批处理(iteration-level scheduling)在每次前向传播后重新调度,完成的序列立即让位给排队请求,是现代推理引擎高吞吐的关键。文章还讨论了固定输出场景下静态批处理的适用性,并给出 vLLM 和 Triton 的配置示例。

技术 › LLM Akshay 2026-09-0112.8 KB 57.2K 285 78

图解大语言模型部署

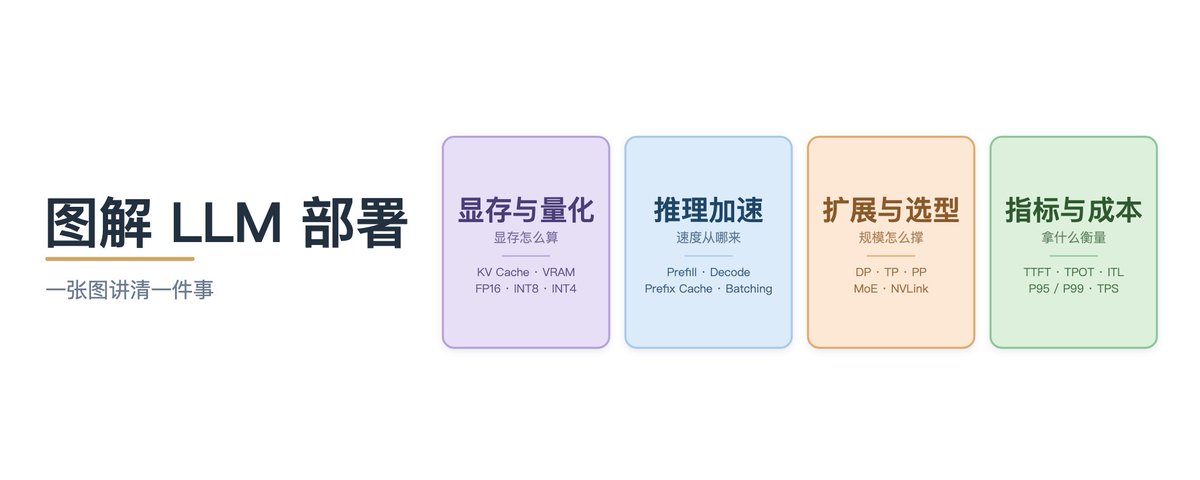
本文系统讲解大语言模型自部署的核心指标与实践要点,覆盖延迟类指标(TTFT、TPOT/ITL、P95/P99)、吞吐类指标(TPS、QPS、连续批处理)、资源类指标(显存与KV cache计算、量化精度)、服务质量(错误率、探针、可用性)以及成本核算(cost per token、TCO)。作者以 Ling-3.0-Flash MoE 模型在 DGX Spark 上的真实实测为例,将抽象指标落地为具体数字,帮助读者选对硬件配置、排查吞吐瓶颈与OOM问题、评估自建与API的划算临界点。

技术 › LLM WquGuru 2026-08-2927.1 KB 56.2K 199 89

保姆级教程:DGX Spark 本地跑通 124B 大模型全记录

本文记录了作者在公司配置的英伟达 DGX Spark 桌面级 AI 超算上本地部署大模型的完整过程。文章首先介绍选择 DGX Spark 的原因(数据隐私、成本可控),解析其 GB10 芯片与 128GB 统一内存的硬件配置,讲解稠密模型与 MoE 稀疏模型的区别,最终选定蚂蚁百灵 Ling-3.0-flash(fp4/int4 量化版本)进行部署。作者对比了 Ollama 与 vLLM 的优劣,选择 vLLM 完成部署,并借助 Claude Code 远程操作。最后进行了 MTP 推理加速测速对比,并成功将本地模型对接到 Claude Code 实际使用。

技术 › LLM AI少年 2026-08-1817.4 KB 184.5K 132 82

大模型本地部署完整指南:用 Ling-3.0-flash 搭建自己的 Agent 工作流

本文是一篇面向新手的本地大模型部署教程。作者在 NVIDIA DGX Spark(GB10 芯片、121.6GB 统一内存)上,使用官方适配的 vLLM 分支部署了蚂蚁百灵开源的 124B MoE 模型 Ling-3.0-flash INT4 版本。文章先科普了模型精度、Dense 与 MoE、推理引擎等概念,再详解下载权重、环境准备、启动服务与验证的完整流程,并开启 MTP 投机解码。性能测试显示 8 并发聚合吞吐达 141.38 tok/s,远超本机 Qwen3.8-27B;随后通过逻辑推理、安全边界、长文本三方向测试验证真实能力,最后介绍用 Python 脚本搭建终端 TUI 聊天界面,逐步走向 Agent 工作流与 Token 自由。

技术 › LLM Lonely 2026-08-1823.9 KB 278.4K 485 81

Qwen3.8-27B 本地部署教程(全网最详细版)

本文详细介绍了阿里通义千问团队发布的Qwen3.8-27B模型的本地部署方法。文章首先分析了不同硬件配置下可选的模型量化版本,然后提供了两套部署方案:一是使用GGUF+llama.cpp,适合24GB显存或Apple Silicon用户;二是使用官方FP8+vLLM,适合48GB以上NVIDIA显存用户。此外,还介绍了如何将模型接入IDE、Agent或自定义应用,并总结了常见的五个部署陷阱及解决方案。最后,作者强调了本地部署在数据隐私、模型可控性和理解底层技术方面的价值。

技术 › LLM Smartpig 2026-08-1510.3 KB 60.1K 342 91

Qwen3.8-27B Practical Guide: Control Reasoning Depth and Extend Context to 1M Tokens

Qwen3.8-27B is a compact, deployment-friendly dense model with native vision-language understanding and flexible thinking control. It introduces two key features: reasoning_effort to adjust reasoning depth per request, and ultra-long context support (262K native, up to 1M with YaRN). This guide provides practical instructions on using these features, including code examples for OpenAI-compatible API, vLLM, SGLang, and TokenSpeed, along with tips for optimal configuration.

技术 › LLM Qwen Developers 2026-08-155.7 KB 76.2K 1.2K 78

vLLM 背后的人:一个开源项目如何长成一家公司

文章讲述了 vLLM 项目从开源起步到成立公司 Inferact 的历程。联合创始人游凯超分享了团队拒绝高薪Offer、坚守开源的初心,以及 DeepSeek 在 Infra 领域的领先优势。文章还探讨了开源治理、模型与 Infra 的协同设计,以及 vLLM 如何应对社区噪音并实现商业化落地。

技术 › LLM 向 向阳乔木 2026-08-0518.8 KB 27.2K 25

PagedAttention & RadixAttention

本文深入探讨了 PagedAttention 和 RadixAttention 两种技术。PagedAttention 通过类似操作系统的分页机制管理 GPU 内存,解决 KV Cache 的内部和外部碎片问题,显著提升并发处理能力。RadixAttention 则利用基数树索引缓存的前缀状态,实现跨请求的计算和内存复用,进一步优化推理性能。

技术 › LLM prasanna 2026-07-2814.4 KB 43.7K 565

OpenRLHF 作者发布 Agentic RL 框架 Molt:9K 行核心代码支持超大规模 MoE 训练

OpenRLHF 作者发布了新的强化学习框架 Molt。该框架采用纯 PyTorch 栈,核心代码仅约 9000 行,专注于 Agentic RL 研究。它支持 Qwen3.5-397B 到 GLM-5.2 753B 等超大规模 MoE 模型训练,无需依赖 Megatron,具备高度的代码可读性和可修改性。

技术 › LLM 青稞社区 2026-07-1610.2 KB 9.5K 81

人工智能的工程全景(中):推理,后训练,对齐和安全

本文是AI工程全景的中篇,深入探讨了模型训练完成后的工程化路径。首先详述了推理优化的核心手段,包括模型瘦身(量化、蒸馏、剪枝、MoE)、投机解码以及主流推理引擎(vLLM, TensorRT-LLM, SGLang)的生态格局。文章分析了成本、延迟与吞吐的“不可能三角”,并重点介绍了“测试时计算”这一范式转变,即通过在推理阶段增加计算量来动态提升模型智能。

技术 › LLM snowboat 2026-07-0372.0 KB 19.2K 43