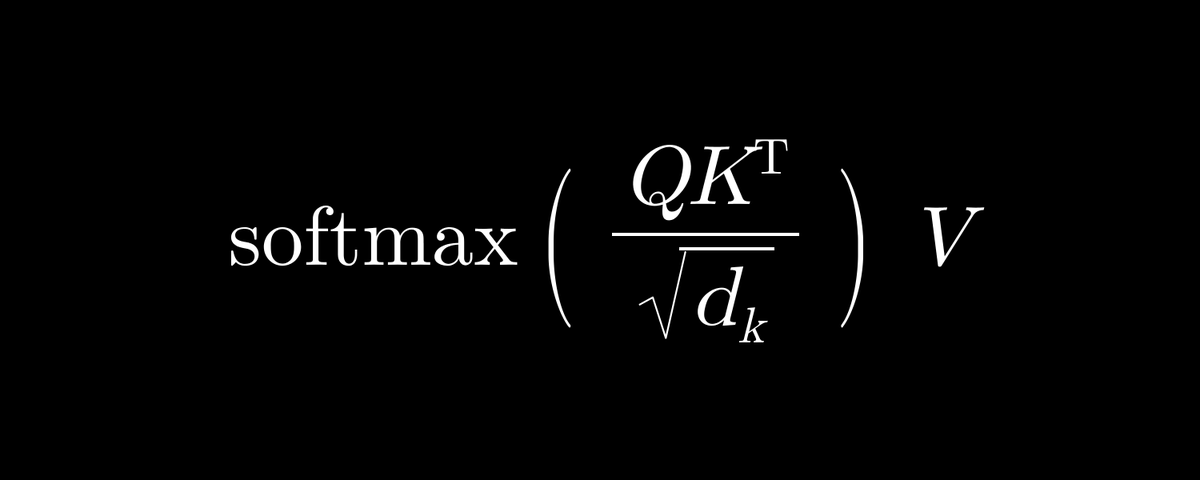
Wiki 知识库

全部文档 / 标签: 推理优化

46 篇
清除

推理是训练的 12 倍,可一块卡生成时只跑出 5% 的算力

文章基于 YC Paper Club 播客,剖析 LLM 推理成本真相:按两年模型寿命摊算,推理总算力约为训练的 12 倍。decode 阶段 MFU 仅 5%,瓶颈在显存带宽而非算力。DeepSeek 通过 KV cache 保留 72 小时、radix attention、零开销调度等手段将缓存命中率做到 96%,实现 38 美元一卡时、80% 毛利。文章还讨论了 SSM 等被低估的模型结构、服务商质量参差(同一模型不同服务商差距超开源闭源差距)以及开源推理生态的规模,指出推理成本优化才是 LLM 竞争的胜负手。

技术 › LLM Saito 2026-10-268.7 KB 140 77

From Big Tech SWE to AI Infra (Part 2): What I Learned in My First Year

作者分享从大厂软件工程师转向 AI 基础设施方向一年的学习历程与心得。毕业加入大厂后,因工作缺乏主动性空间和创造感,三个月后决定转向 AI infra。通过学习基础知识、深入研读 SGLang 源码、参与社区贡献,逐步加入 SGLang-Omni 项目并进入一家 AI infra 创业公司。作者认为这一年是高回报率的一年,但也指出 AI 领域竞争激烈、节奏快,转行需权衡个人追求。文章最后强调了开源的重要性,认为强大的 AI 工具不应只掌握在少数公司手中,呼吁更多人参与开源社区。
技术 › 后端 Yichi Zhang 2026-10-257.8 KB 20K 401 69

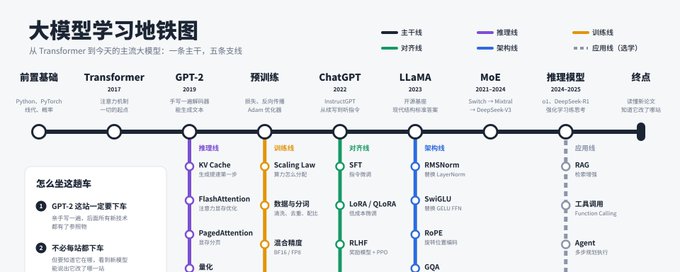
大模型学习地铁图:从 Transformer 到今天的主流大模型

文章以地铁图为比喻,为大模型学习者规划了一条清晰的学习路线。主干线按演进顺序设置八站:前置基础、Transformer、GPT-2(强调亲手实现作为锚点)、预训练、ChatGPT 时刻(RLHF)、LLaMA、MoE 稀疏专家、推理模型(o1/R1),终点是能独立读懂新论文。五条支线按兴趣选修:推理优化(KV Cache、FlashAttention、量化)、训练(Scaling Law、分布式并行)、对齐(SFT、LoRA、DPO、GRPO)、架构(RMSNorm、RoPE、MLA)、应用(RAG、Agent)。最后给出建议:GPT-2 必须亲手写一遍,主干加一至两条支线即可入门,学习原理时动手推算。

技术 › LLM 纳米AI 2026-10-2010.4 KB 52K 871 88

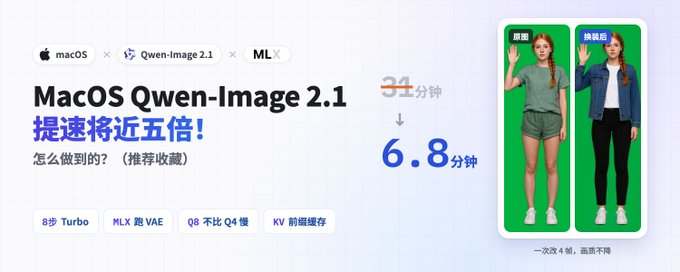
MacOS 本地部署 Qwen-Image 2.1 提速将近五倍!怎么做到的?(推荐收藏)

作者分享了在 M2 Pro Mac 上将 Qwen-Image 2.1 改图时间从 30 分钟压到 6.8 分钟(提速4.5倍)的完整方法论。首先通过耗时拆解定位瓶颈,然后叠加四个优化点:换用 Turbo 模型将去噪从20步降至8步;将 VAE 编解码切换到苹果 MLX 框架,从315秒降到15秒;实测发现 Q8 与 Q4 量化在扩散模型上速度相同,因此选用画质更好的 Q8;利用块因果结构实现前缀 KV 缓存,使每步采样时间减半。作者还用该流水线完成了一段10秒视频的逐帧换装,并通过肤色基准校正、锚点补偿和时序平滑三层方案解决了误差累积问题。

技术 › 工具与效率 WquGuru 2026-10-1311.0 KB 16.6K 87 88

把 96.5GB 的 GLM-5.3-Flash 塞进单张 4090 48GB,跑出 41.8 token/s

本文记录了在单张魔改 RTX 4090 48GB 上,通过系统级调优将 96.5GB 的 MoE 模型 GLM-5.3-Flash 推理提速至 41.8 token/s 的完整工程实录。作者采用混合 i-quant 量化,将 12,096 个专家常驻显存与锁页内存,通过实测发现减少 CPU 线程反而提升 42% 速度、扩大显存池至 46GB 带来质变、以及激进的 PCIe 搬运策略是致命代偿陷阱。文章逐毫秒拆解了 24.47ms 的 token 耗时去向,指出 PCIe 搬运是硬瓶颈,并对比了更稀疏的 Qwen3.8-Flash-Next 架构可达 120 tok/s 的原因。

技术 › LLM huangserva 2026-10-1217.6 KB 9.3K 57 89

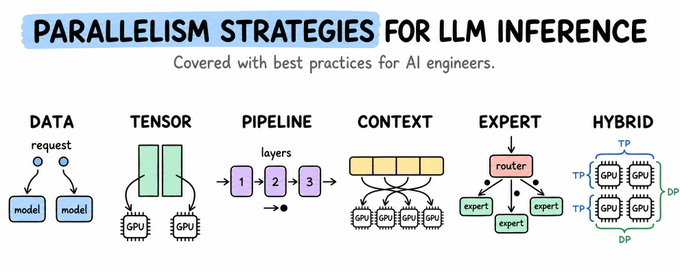
Parallelism strategies for LLM inference, clearly explained

本文系统讲解了 LLM 推理的多 GPU 并行策略。首先介绍推理的两个阶段(Prefill 影响 TTFT,Decode 影响 TPOT)以及部署中的四大资源限制(参数内存、KV-cache、计算、通信),然后通过五个关键问题框架分析各类并行策略:数据并行(复制完整模型、分区请求)、张量并行、流水线并行、上下文并行和专家并行。文章强调选择布局需权衡内存容量、请求延迟和吞吐量,避免通信开销超过硬件承受能力,并给出部署检查规则,帮助读者根据模型、硬件拓扑和工作负载选出合适的布局。

技术 › LLM Avi Chawla 2026-10-0629.4 KB 29.4K 178 82

权重压到 4 bit,大模型为什么还能工作?

文章以 Qwen3.8-27B 为例,系统讲解大模型权重量化的原理。从参数如何参与矩阵乘法运算入手,说明 bit 数与编码格式(FP16、BF16、INT4)的关系,演示 0.73 如何被 4 bit 编码为 0.8 并引入误差。深入分析了刻度选择中范围、分辨率与截断误差的取舍,权重误差如何随输入放大为输出误差,以及 GPTQ、AWQ、PTQ、QAT 等量化方法如何利用校准数据控制误差。最后估算 4 bit 模型的存储大小(约 13.5-19 GB),讲解 KV 缓存、混合注意力结构对显存的影响,并给出选择和评估本地量化模型的实用建议。

技术 › LLM gKev1n 2026-10-0511.9 KB 4.9K 36 84

AI 工程师需要了解的 GPU 全部知识

本文面向 AI 工程师系统讲解 GPU 硬件知识:GPU 的三种类型(数据中心、工作站、个人级),内部结构(SM、Tensor Core、CUDA 核心、HBM 显存与 SRAM 缓存),并以 gpt-oss-120b 和 Kimi K3 两个开源 MoE 模型为例,用精确的数学计算说明推理的算力与显存带宽瓶颈、prefill 与 decode 的差异,以及训练与推理对 GPU 使用的不同需求,帮助工程师做出租用 GPU、模型部署等实际决策。

技术 › LLM Karan 2026-10-0219.3 KB 55.1K 427 82

「Learn Inference」LLM 推理工程全景指南:从 Attention 内核到多云 GPU 容量,两阶段、三层栈、五大技巧

本文是 Philip Kiely 所著《Inference Engineering》的交互式伴读站点介绍,系统梳理 LLM 推理工程全貌。文章以 prefill/decode 两阶段为原子结构,按运行时、基础设施、工具链三层展开,逐章讲解模型结构(Attention、KV 缓存、MoE)、GPU 硬件选型(带宽 vs 算力)、软件栈(vLLM、SGLang、TensorRT-LLM)、五大优化技巧(量化、投机解码、缓存、并行、解耦)以及多模态与生产实践(扩缩容、路由、成本、可观测性)。核心思想是:先诊断瓶颈再优化,一切优化皆是权衡,具体知识会过期而底层约束移动缓慢。

技术 › LLM meng shao 2026-09-2918.6 KB 3.4K 11 86

UC Berkeley 2026 秋季课程《Scalable AI》:从架构、预训练到推理的全栈工程

文章介绍 UC Berkeley EECS 2026 秋季开设的《Scalable AI》课程(EE 290/194),由 Anant Sahai 与焦剑涛联合授课,NVIDIA 提供算力支持。课程将大模型作为端到端工程对象教授,涵盖架构、预训练、后训练、高效推理、应用与研究前沿六个阶段,采用基于真实 H100 节点的项目制考核,无笔试,研究项目占 50% 且要求外部影响力证明。课程深度绑定 NVIDIA NeMo 工具链,反映了 AI 教育重心从论文向工程实践迁移的趋势,适合目标为 LLM infra 与 MLSys 的学生。

技术 › LLM meng shao 2026-09-299.4 KB 6.4K 53 73

斯坦福大学 CS329Z「Engineering AI Agents」第二讲 LLMs for Builders:Agent 工程师必修的大模型底层原理

本文深度解读斯坦福 2026 秋季课程 CS329Z 第二讲「LLMs for Builders」讲义,面向 Agent 工程师系统讲解 LLM 底层原理。内容涵盖:自回归概率分解与解码采样策略;从 RNN 到 Transformer、线性注意力的架构演进及其工程取舍;预训练、中期训练与后训练(RLHF、RLVR)管线;推理阶段的 Prefill/Decode、KV Cache、投机解码与推理时扩展;最后落脚到 Agent 开发的结构化 I/O 与上下文工程实践,强调'设计决策→局限→应用策略'的因果链。

技术 › LLM meng shao 2026-09-2919.3 KB 19.4K 60 84

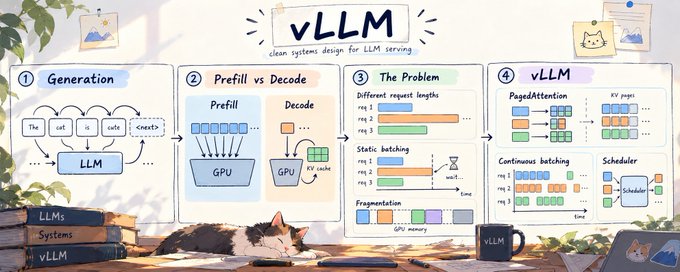
vLLM 架构之美:PagedAttention 与 Continuous Batching 解析

作者赞颂 vLLM 的软件设计之美。文章首先介绍 LLM 自回归生成的基本原理,以及推理的两个阶段:计算密集的 Prefill 和带宽受限的 Decode,指出 KV Cache 动态增长与静态批处理带来的内存浪费问题。vLLM 借鉴操作系统分页思想,将 KV Cache 切分为固定大小的块并维护逻辑到物理的块表(PagedAttention),将内存浪费降至约 3%;配合 Continuous Batching 和动态调度,避免已完成的请求阻塞整个批次,让 GPU 始终保持高效。作者认为 vLLM 的成功源于借鉴已被大规模验证的成熟系统概念。

技术 › LLM Atharva 2026-09-275.1 KB 21K 401 56

LLM Inference Handbook 精读:Prefill、Decode、KV Cache,与一切皆权衡的推理工程

本文深度解读 Modular 公司开源维护的《LLM Inference Handbook》,系统梳理 LLM 推理工程的知识体系。文章提炼三大核心框架:prefill(算力受限)与 decode(带宽受限)的两阶段二分法;KV cache 作为系统中心约束的地位,围绕它的 PagedAttention、prefix caching、PD 分离等技术网络;以及“一切皆 trade-off,唯一方法论是 benchmark”的工程哲学。内容还涵盖 continuous batching、speculative decoding、GPU 内存金字塔、FlashAttention、量化与蒸馏三部曲、Agent 生态与部署运维等主题,强调推理优化的本质是围绕有状态 KV cache 做内存管理与调度。

技术 › LLM meng shao 2026-09-2218.3 KB 14.6K 139 84

深读免费书「Inference Engineering」:Prefill 吃算力、Decode 吃带宽,讲透从 CUDA 到生产部署的推理优化

文章深度解读 Baseten 出版的免费工程书《Inference Engineering》,系统讲解如何把 AI 模型在生产环境中跑得快、省、稳。全书以三层推理栈(运行时、基础设施、工具层)为骨架,核心分析框架是瓶颈判断:prefill 算力受限、decode 带宽受限、图像视频生成算力受限。内容涵盖模型与硬件理解(算术强度、KV cache、选卡策略)、软件栈(vLLM/SGLang/TensorRT-LLM 三大引擎对比)、五大加速技术(量化、投机解码、缓存、并行、分离部署)及其交互关系,以及生产化部署的延迟全栈账本、故障处理与成本核算,强调约束换性能、技术按组合评估等基本原则。

技术 › LLM meng shao 2026-09-2111.2 KB 13.1K 145 84

Build your own Jev (100% local):用开源 LLM 构建本地决策引擎

文章介绍如何将开源 LLM 变成快速、本地的决策引擎,而无需重新训练。核心思想是:当应用已知所有可能的答案时,不必让模型生成文本或 JSON,而是通过 next-token scoring 一次性为每个候选答案返回分数和概率分布。作者讲解了固定答案打分与结构化输出的区别、LLM 第一个输出 token 的生成原理,并使用 SGLang 的 /v1/score 接口,结合 Qwen 和 DeepSeek 模型进行实测,与普通文本生成进行了基准对比。文中还提到概率的含义与校准问题。

技术 › LLM Avi Chawla 2026-09-2022.3 KB 1.1M 3.1K 76

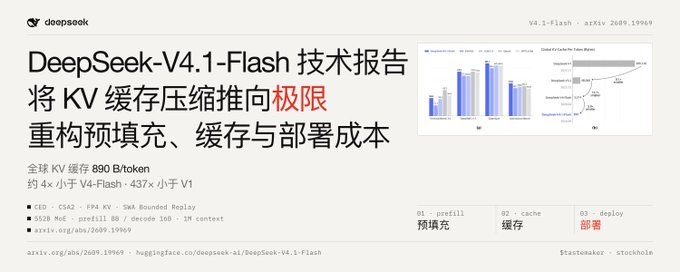
DeepSeek-V4.1-Flash 技术报告:将 KV 缓存压缩推向极限,重构预填充、缓存与部署的成本结构

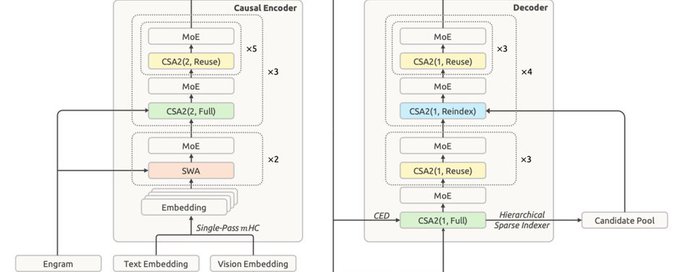
本文深度解读 DeepSeek-V4.1-Flash 技术报告,该模型通过 CED 不对称编码器-解码器架构、CSA2 跨层稀疏注意力复用、FP4 主 KV 量化及 SWA Bounded Replay 近似恢复四项设计,将常驻 HBM 的全局 KV 缓存降至 890 bytes/token(约为上一代四分之一),持久化缓存降至八分之一。文章详细解析各项技术的原理与协作机制,澄清了对压缩数字的常见误读,评估模型能力变化,并与 PagedAttention、MiniCache 等已有 KV 压缩路线对比,指出该工作将缓存压缩从算法点推进为面向百万 token 长程 agent 场景的系统级共同设计,同时讨论其证据强度与局限。

技术 › LLM meng shao 2026-09-1921.7 KB 7K 25 82

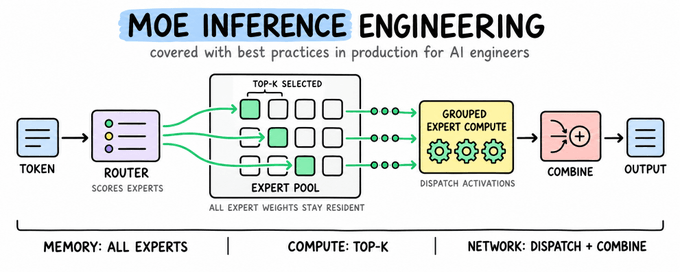
MoE 推理工程详解

本文系统讲解 MoE(混合专家)模型的推理服务工程原理。从稠密 Transformer 的 FFN 与 MoE 层的区别入手,介绍路由器如何为每个 token 选择专家、dispatch 和 combine 过程如何将路由决策聚合成专家专属矩阵,以及 grouped GEMM 如何减少内核启动开销。文章还涵盖专家并行、拓扑感知部署、显存需求(常驻参数 vs 激活参数)、负载不均衡、容量限制和量化等话题,并分析计算、显存带宽与互连流量之间的性能瓶颈权衡,以 Qwen3-30B-A3B 为实例说明。

技术 › LLM Avi Chawla 2026-09-1929.1 KB 148.8K 316 73

智谱用 GLM-5.3 自己优化了自己的推理系统

智谱披露 GLM-5.3-Flash 的全部生产推理已运行在超 10 万块国产 AI 加速器上,从跑通到上线不到两周,端到端吞吐量提升 3.2 倍,大量优化工作由 GLM-5.3 驱动的智能体完成。核心经验在于'密集反馈'机制:将资深工程师的隐性过程奖励显性化为分层验证接口,让智能体自主定位并修复精度漂移、GIL 并发瓶颈、重复计算等真实工程问题。国产芯片单 token 成本已对标英伟达 GPU。唐杰指出目标设定与高风险审查仍由人负责,但最小递归自我改进闭环已存在。

技术 › LLM 宝玉 (@dotey) 2026-09-174.2 KB 84

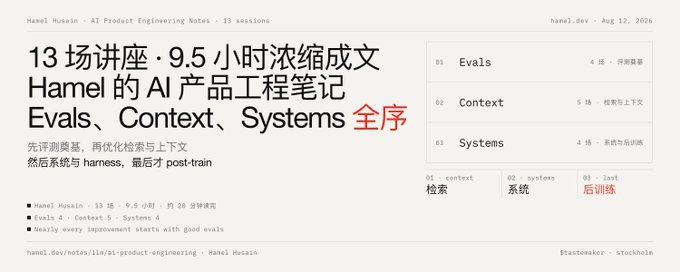
Hamel 的 AI 产品工程笔记:Evals、Context、Systems 的优化全序

本文整理了 Hamel Husain 的 Maven 课程「AI Product Engineering」13 场讲座(共 9.5 小时)的笔记精华,按 Evals、Context、Systems 三大主题组织。核心结论是 AI 产品优化的顺序:先优化检索与上下文(投入产出比最高),再改进系统与执行框架,最后才考虑 post-training。Evals 贯穿一切改进,是判断优化效果的前提。文章涵盖数据 Agent 评测、模型级联降本、自动化错误分析、多向量检索、嵌入模型优化、OCR 选型、推理延迟调试、开源模型经济学等具体实践,强调评测环境应反映生产环境的真实脏乱,模型推理能力往往远超其所得的检索质量。

技术 › LLM meng shao 2026-09-1722.2 KB 27.6K 144 87

LLM Inference After Training: Prefill, Decode, KV Cache

本文系统讲解 LLM 推理阶段的核心原理。作者指出推理与训练不同,分为 prefill 和 decode 两个阶段:prefill 并行处理整个提示词、计算密集型、决定首 token 延迟(TTFT);decode 逐 token 生成、受 HBM 内存带宽限制、决定 token 间延迟(ITL)。文章介绍了 GPU 关键硬件概念(Tensor Core FLOPS、HBM、SRAM),逐步演示一个请求的完整流程(分词、采样、KV cache 机制),并将 FlashAttention、PagedAttention、continuous batching、RadixAttention 等优化技术归位到这两个阶段中,帮助读者理解推理瓶颈与优化方向。

技术 › LLM Karan 2026-09-1713.8 KB 29.4K 187 83

Prefill and Decode:理解 LLM 推理的两个阶段

文章以'读长文档只要三条结论为何很慢,写两千字演讲稿反而很快开口'为切入点,讲解 LLM 推理的 prefill 与 decode 两个阶段。Prefill 并行处理全部输入 token 并保存 KV cache,决定首 token 延迟(TTFT);decode 自回归地逐个生成 token,受内存带宽影响,影响 token 间隔(ITL)。文章进一步介绍 chunked prefill、prefill/decode disaggregation 和 prefix caching 三种优化手段,并以 EXO 用 DGX Spark 做 prefill、Mac 做 decode 的演示说明跨设备分工的可能性,帮助读者具体分析 AI 响应慢的原因。

技术 › LLM Dongxi 东锡 NLP 2026-09-1511.3 KB 24.8K 89 74

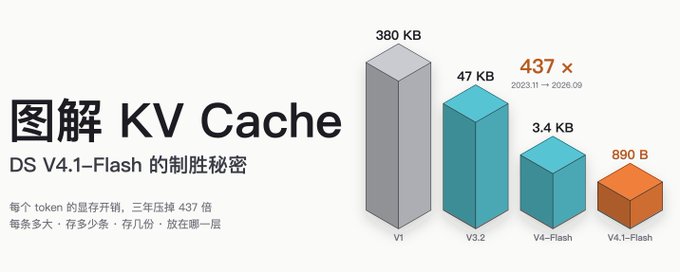
图解 KV Cache——DS V4.1-Flash的制胜秘密

本文图解 DeepSeek V4.1-Flash 如何将单 token 全局 KV Cache 从 V1 的 389KB 压缩至 890 字节。文章先介绍 KV Cache 原理与显存瓶颈,再梳理 GQA、MLA、量化、稀疏注意力、跨层复用等六次关键突破,最后详解 V4.1 在架构、精度、部署三层的联合优化,包括 CED、CSA2 三模式、层级稀疏索引器与 FP4 量化,并给出 890 字节的推导过程。

技术 › LLM WquGuru 2026-09-1423.6 KB 68.6K 376 83

LLM 为什么缓存 K 和 V,却通常不缓存 Q?

本文深入浅出地讲解了 LLM 推理中 KV cache 的原理。作者以长文档问答为场景,说明模型生成每个 token 时无需重复计算全部历史状态,解释了为什么缓存 K/V 而不需要缓存 Q:历史 Q 已完成对应位置计算,而 K/V 需供后续新位置读取。文章还讨论了 causal attention 的信息方向如何决定 cache 失效条件、KV cache 的显存开销计算、prefix caching 复用共同前缀的策略,以及 DeepSeek-V4.1-Flash 中 causal encoder-decoder、跨层 KV 共享与 shared KV representation 等架构优化。

技术 › LLM Dongxi 东锡 NLP 2026-09-139.5 KB 196.7K 623 82

DeepSeek V4.1 Flash:架构学习笔记

本文是 DeepSeek V4.1 Flash 的架构学习笔记。文章详细解析了其 Causal Encoder-Decoder(CED)结构,该结构通过前后半段网络的不对称计算减少长输入处理成本。核心创新在于 KV 缓存压缩:通过 CSA2 跨层共享全局 KV、FP4 量化、分层稀疏检索以及 SWA 有界回放等设计,将全局 KV 降至约 890 字节/token,持久化缓存约为上一代的 1/8。文章还讨论了这些设计如何协同工作,使长上下文在 Agent 场景下更可负担。

技术 › LLM AI Dance 2026-09-1113.1 KB 21.3K 203 79

DeepSeek-V4.1-Flash 发布:更聪明、更快速、更高效

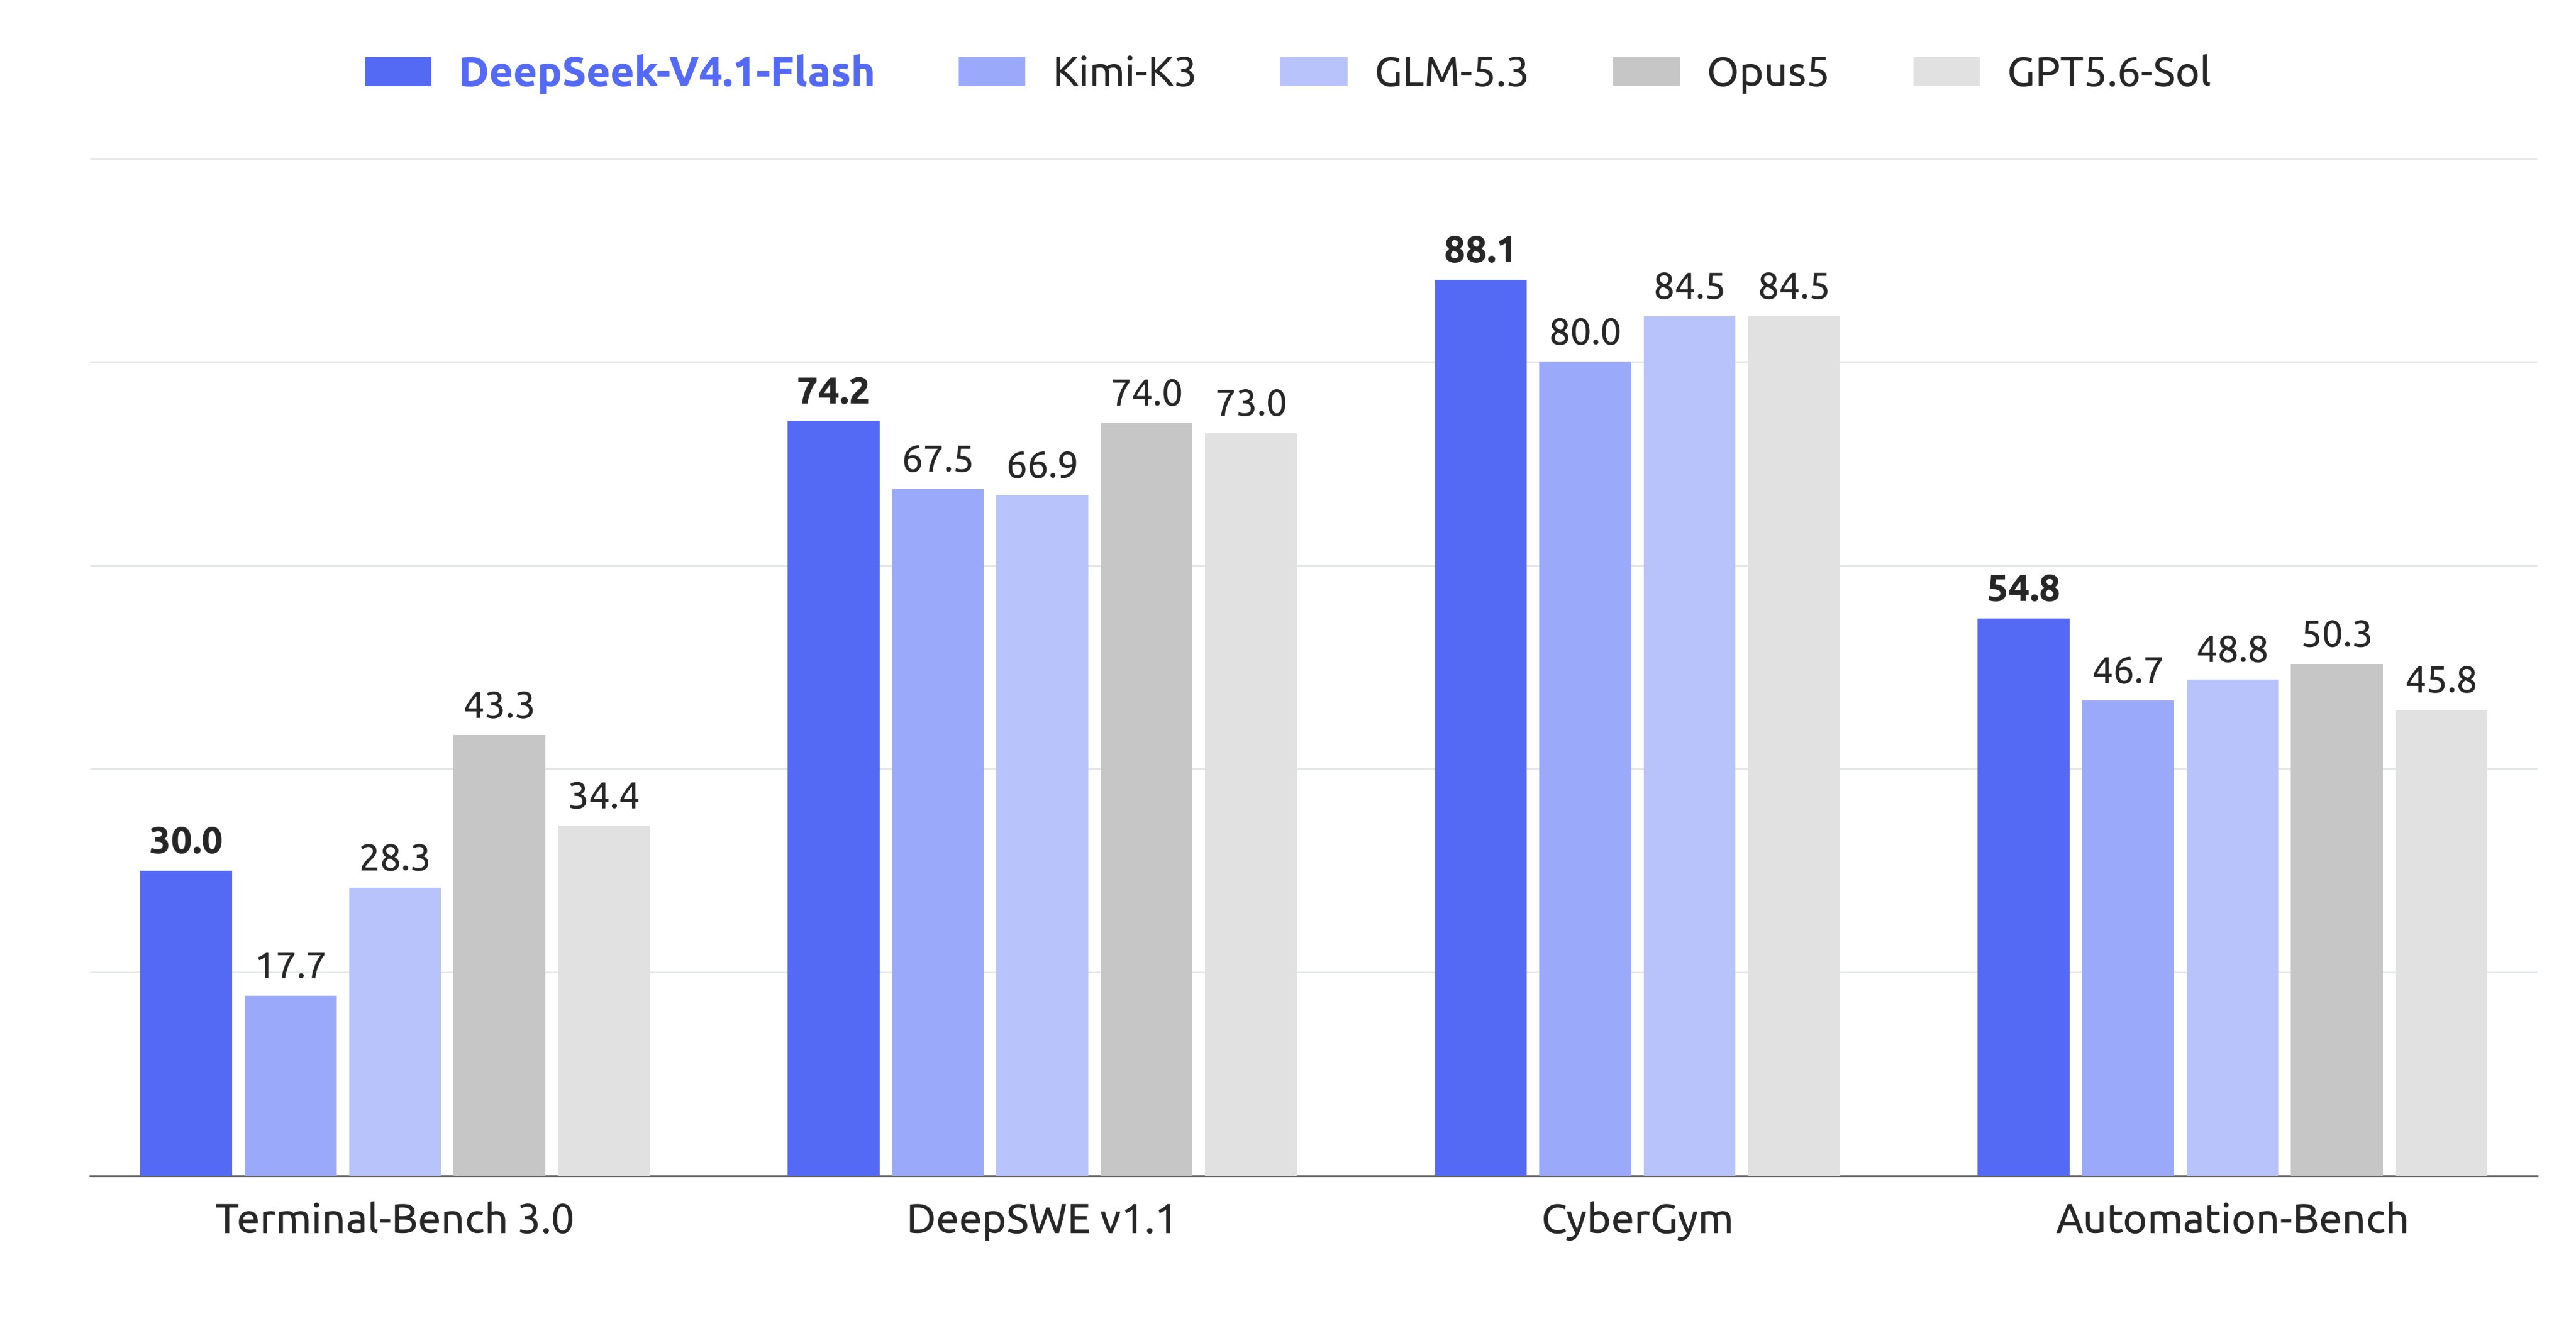
DeepSeek 发布新架构家族中最小的模型 V4.1-Flash,具备原生视觉理解能力。该模型采用非对称因果编码器-解码器架构,552B 参数 MoE,仅 8B 激活参数用于输入、16B 用于输出,通过新预训练方法和大规模 RL 后训练,性能超越旗舰模型 V4-Pro。KV 缓存仅需前代 1/4 的 HBM 和 1/8 的 SSD 存储,大幅降低 Agent 成本。模型已上线 DeepSeek API,支持多模态,API 价格下调,非高峰时段费率为峰值的 50%。官方将与开源社区合作推进推理支持,模型已在 HuggingFace 开放。

技术 › LLM DeepSeek (@deepseek_ai) 2026-09-103.3 KB 73

vLLM x AgentX: Optimizing for Real-World Agentic Serving

本文介绍 vLLM 针对 Agentic 工作负载的服务优化方案。Agentic 流量具有多轮长会话、长上下文短输出、高前缀复用率和大量子代理调用的特点,对成本与延迟提出双重要求。在 SemiAnalysis 发布的 AgentX 基准上,vLLM 在 DeepSeek V4 Pro 上达到每 GPU 秒 130K tokens,在 MiniMax M3 上交互速度达 376 tokens/s,相比 Opus 5 API 定价有 14.6×–106× 的成本优势。文章详细阐述了数据平面的混合 KV cache 管理与分层卸载、执行平面的并行与内核优化,以及控制平面的 P/D 分离调度等全栈优化方法。

技术 › LLM vLLM 2026-09-0931.2 KB 41.2K 328 78

什么是 GPU Kernel?

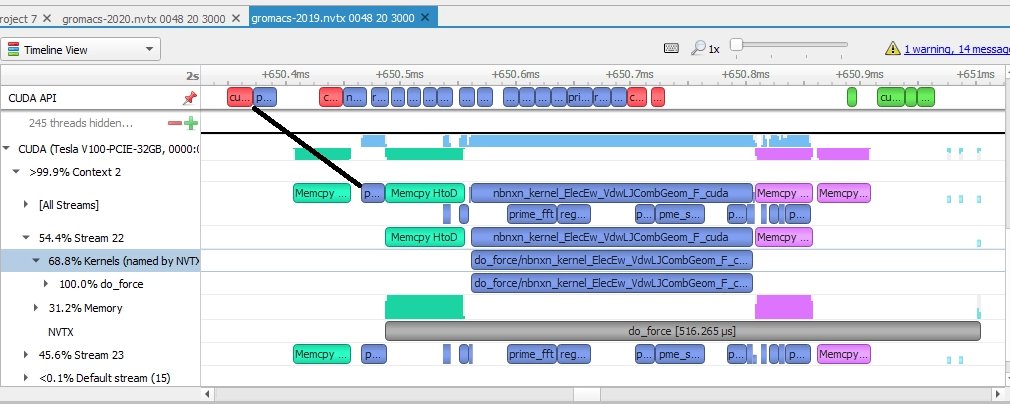
文章介绍了 GPU kernel 的概念及其在模型推理优化中的作用。Kernel 是运行在数千个 GPU 线程上的并行函数,区别于操作系统内核。作者解释了 kernel 的调用流程(如 torch.matmul 经由 cuBLAS 等库启动 kernel),以及编写自定义 kernel 的价值,重点介绍了 kernel 融合(fused kernels)技术,如 FlashAttention 通过在 SRAM 中完成多步计算减少对慢速 HBM 的读写。同时强调自定义 kernel 虽然炫酷但应放在最后考虑,Batching、量化、投机解码、编译器优化等上层手段收益更大。最后推荐从 Triton 入手,并介绍了 ThunderKittens、TileLang、CuTe、Mojo 等新兴 kernel DSL。

技术 › 工具与效率 lucas liao 2026-09-087.0 KB 45K 627 71

LLM 路由可能比不路由成本更高

文章探讨 LLM 路由(LLM Routing)的成本悖论:理论上将简单任务分配给廉价模型可节省大量成本(如 RouteLLM 实现约 85% 降本),Uber 因给 5000 名工程师统一部署 Claude Code 导致年度 AI 预算提前耗尽的案例也说明单一模型定价的问题。但传统路由方案在生产中会因四大失败模式而失效:分类调用额外计费、通用模型意图识别能力差、路由逻辑缺乏评估易腐化、以及模型切换破坏 KV 缓存导致全价重算。文章随后介绍 DigitalOcean 基于开源代理 Plano 的基础设施级路由方案:使用 1.5B 参数的专用路由模型(Arch-Router / Plano-Orchestrator)在代理内完成意图解析,准确率超越前沿大模型且更快,再结合成本与延迟数据对候选模型池按策略排序,实现成本与质量兼顾的动态路由。

技术 › LLM Akshay 2026-09-0715.7 KB 49.9K 475 75

LLM 注意力机制详解:从 Self-Attention 到 MLA

文章系统讲解了 Transformer 中各类注意力机制的演进:从自注意力、因果注意力、交叉注意力的基础概念,到 Multi-Head Attention(MHA)的表达力与显存代价,再到 MQA 通过共享 KV 头缩减缓存、GQA 在质量与内存间取得平衡成为主流、DeepSeek 提出的 MLA 通过低秩潜空间压缩 KV 缓存,以及 FlashAttention 通过改变内存访问方式优化计算效率。核心驱动力是 KV cache 的显存约束:长上下文大模型的注意力状态存储可与模型权重相当。每种机制都是为了解决前一设计的缺陷而诞生。

技术 › LLM Akshay 🚀 2026-09-0513.4 KB 191.5K 577 75

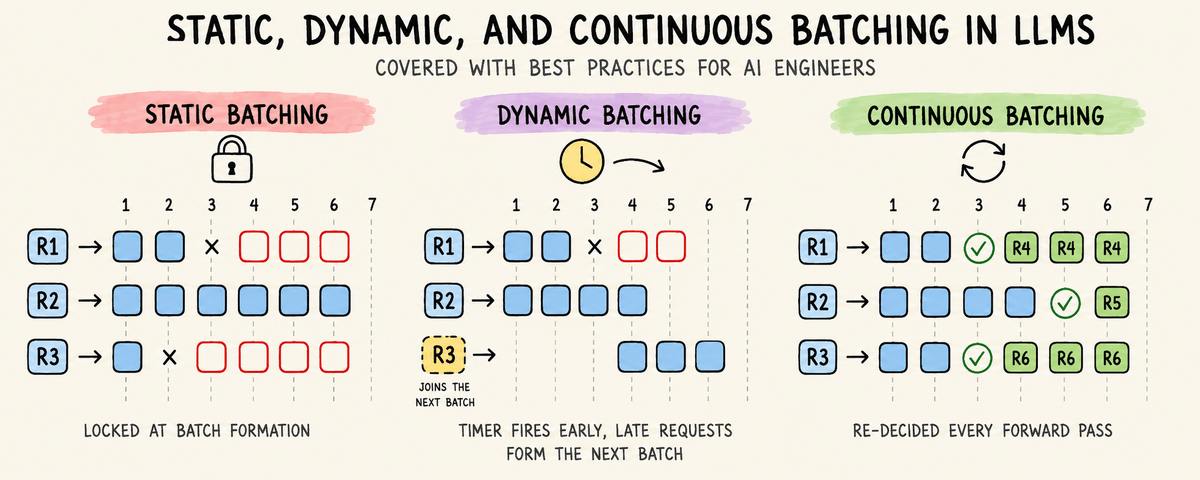
Static vs. Dynamic vs. Continuous Batching in LLMs, clearly explained

文章从第一性原理剖析了 LLM 推理服务中三种批处理策略。现代 GPU 在 LLM 解码时受显存带宽限制,计算单元大量空闲,批处理可将权重读取成本分摊到多个序列以提升吞吐。由于自回归解码的输出长度不可知、序列间相互依赖,传统批处理存在短板:静态批处理在批开始时一次决定,受最慢成员拖累;动态批处理加入定时器,缓解入批等待但仍整批绑定;连续批处理(iteration-level scheduling)在每次前向传播后重新调度,完成的序列立即让位给排队请求,是现代推理引擎高吞吐的关键。文章还讨论了固定输出场景下静态批处理的适用性,并给出 vLLM 和 Triton 的配置示例。

技术 › LLM Akshay 2026-09-0112.8 KB 57.2K 285 78