Wiki 知识库

全部文档 / 标签: GPU

31 篇
清除

NVIDIA RTX 20/30/40 显卡隐藏 Tensor Core 算力被破解解锁

民间开发者破解了 NVIDIA RTX 20、30、40 三代显卡被锁定的 Tensor Core 算力,无需更换硬件、刷 BIOS 或魔改驱动,通过底层方式解除性能限制。RTX 4090 算力从 165.6 翻倍至 331.6 TFLOPS,RTX 3090 Ti BF16 提升约 80%,部分老显卡如 RTX 2080 Ti 也接近翻倍。社区已发布多个 GitHub 开源项目和安装教程,Windows 11 上也有成功复现案例。不过有用户实测发现 token 输出速度反而下降,实际效果仍待验证。

技术 › 硬件 Max For AI (@MaxForAI) 2026-10-263.2 KB 76

LoRA 与 QLoRA:用一块 GPU 微调大模型

本文从“模式”(一列乘一行的秩1矩阵)概念出发,系统讲解 LoRA 与 QLoRA 如何降低大模型微调的显存开销。LoRA 通过低秩近似冻结原有权重,只训练少量新增模式(B·A),将可训练参数减少到约万分之一;量化则用 4 位 NF4 格式配合分块缩放和双重量化存储权重,保留全部模式但降低每个数的精度。QLoRA 结合两者:冻结权重用 4 位存储,LoRA 分支用 16 位训练,使 65B 模型只需一块 48GB GPU 即可微调,Guanaco 在 Vicuna 评测中达到 ChatGPT 的 99.3%。文中还比较了低秩近似与量化误差结构的不同,并给出 7B 模型显存估算:全参数微调约 100GB,LoRA 约 15GB,QLoRA 约 5GB。
技术 › LLM Dongxi 东锡 NLP 2026-10-2412.7 KB 13K 32 76

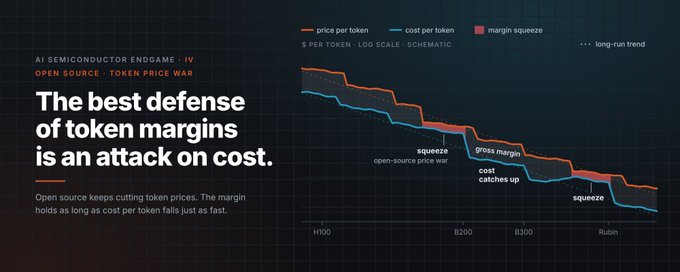
AI Semiconductor Endgame (IV):开源模型对半导体的影响

文章探讨开源模型的崛起是否冲击半导体需求这一热门问题。作者指出市场担忧的核心在于开源是否会压低毛利,进而削弱模型公司购买GPU的能力。但通过动态均衡框架分析,token价格下降的同时,硬件与软件的效率提升(每十年各贡献千倍优化)使成本同步快速下降,毛利得以维持。以每GW算力测算,旗舰模型推理毛利率仍达75%-80%以上,开源模型约60%-70%,token收入是硬件摊销成本的十倍。结论是开源不会伤害半导体行业,动态均衡将持续推动AI基础设施扩张。

投资 › 宏观经济 fin 2026-10-2130.1 KB 70.2K 299 82

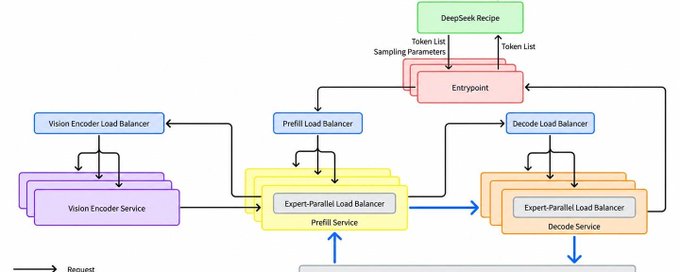
DeepSeek V4.1 Flash 大规模推理部署实践

文章介绍 DeepSeek V4.1 Flash 大规模推理系统的部署实践与开源推理框架 DeepInfer。系统设定三大目标:兼容多厂商计算芯片、基于通用硬件组织 Prefill 与 Decode(8 卡机 Prefill、64-128 卡超节点 Decode)、支持 KVCache 保留 72 小时以上以实现上下文复用、减少冗余计算。团队通过在计算、通信、调度与存储上的持续优化,在满足延迟要求下提升有效吞吐。DeepInfer 集成高性能算子与深度优化推理引擎,支持分布式推理、投机解码、SWA Bounded Replay 和结构化输出等能力。目前单集群服务吞吐达每天 155 万亿 tokens,整体收入为每卡每小时 38 美元(按低谷价格计)。

技术 › 后端 Latent.Space 2026-10-2182.1 KB 92.6K 432 69

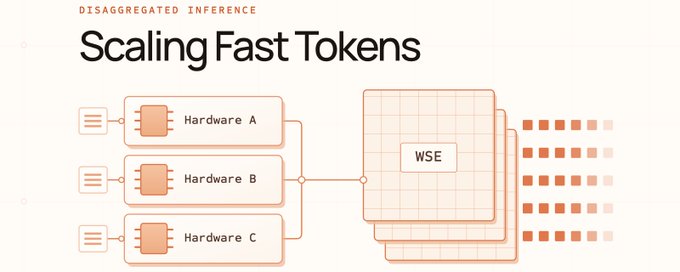
Disaggregated Inference From The Ground Up

本文由 Cerebras 撰写,从基础原理讲解推理系统中的分离式推理技术。文章先介绍加速器的构成(计算单元与存储),并引入算术强度概念,通过矩阵加法与矩阵乘法的实例说明数据搬运与计算的关系。随后分析 LLM 推理的两个阶段:prefill(处理整个 prompt,计算密集型)与 decode(逐 token 生成,受限于内存带宽),解释二者对硬件需求的不同。Cerebras 提出异构分离式推理,将不同类型芯片分配给不同推理阶段,在相同硬件数量下将吞吐量提升 5 倍且不损失单用户生成速度。

技术 › LLM Cerebras 2026-10-0219.6 KB 400.2K 299 70

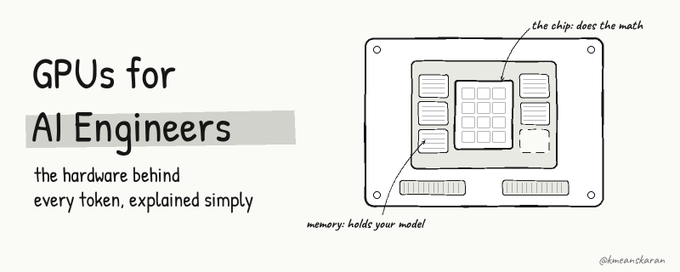
AI 工程师需要了解的 GPU 全部知识

本文面向 AI 工程师系统讲解 GPU 硬件知识:GPU 的三种类型(数据中心、工作站、个人级),内部结构(SM、Tensor Core、CUDA 核心、HBM 显存与 SRAM 缓存),并以 gpt-oss-120b 和 Kimi K3 两个开源 MoE 模型为例,用精确的数学计算说明推理的算力与显存带宽瓶颈、prefill 与 decode 的差异,以及训练与推理对 GPU 使用的不同需求,帮助工程师做出租用 GPU、模型部署等实际决策。

技术 › LLM Karan 2026-10-0219.3 KB 55.1K 427 82

「Learn Inference」LLM 推理工程全景指南:从 Attention 内核到多云 GPU 容量,两阶段、三层栈、五大技巧

本文是 Philip Kiely 所著《Inference Engineering》的交互式伴读站点介绍,系统梳理 LLM 推理工程全貌。文章以 prefill/decode 两阶段为原子结构,按运行时、基础设施、工具链三层展开,逐章讲解模型结构(Attention、KV 缓存、MoE)、GPU 硬件选型(带宽 vs 算力)、软件栈(vLLM、SGLang、TensorRT-LLM)、五大优化技巧(量化、投机解码、缓存、并行、解耦)以及多模态与生产实践(扩缩容、路由、成本、可观测性)。核心思想是:先诊断瓶颈再优化,一切优化皆是权衡,具体知识会过期而底层约束移动缓慢。

技术 › LLM meng shao 2026-09-2918.6 KB 3.4K 11 86

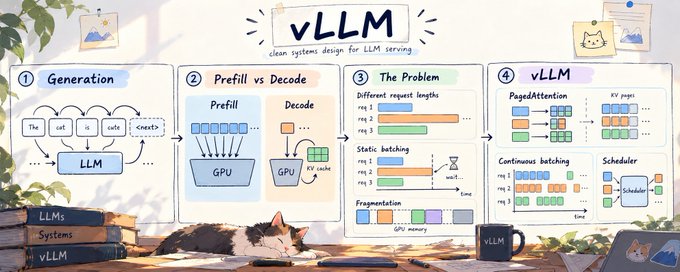
vLLM 架构之美:PagedAttention 与 Continuous Batching 解析

作者赞颂 vLLM 的软件设计之美。文章首先介绍 LLM 自回归生成的基本原理,以及推理的两个阶段:计算密集的 Prefill 和带宽受限的 Decode,指出 KV Cache 动态增长与静态批处理带来的内存浪费问题。vLLM 借鉴操作系统分页思想,将 KV Cache 切分为固定大小的块并维护逻辑到物理的块表(PagedAttention),将内存浪费降至约 3%;配合 Continuous Batching 和动态调度,避免已完成的请求阻塞整个批次,让 GPU 始终保持高效。作者认为 vLLM 的成功源于借鉴已被大规模验证的成熟系统概念。

技术 › LLM Atharva 2026-09-275.1 KB 21K 401 56

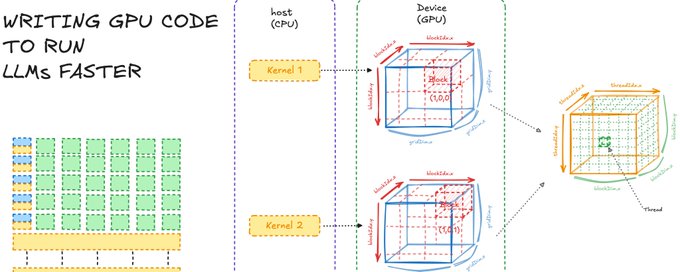
CUDA from zero to hero #1

这是一篇 CUDA 学习系列的第一篇笔记式文章,作者旨在从零基础带领读者掌握 CUDA 编程。文章首先解释 GPU 存在的原因:CPU 擅长串行计算,而矩阵乘法等 AI 核心操作天然可并行,因此 GPU 拥有大量 ALU 以实现高吞吐并行计算。随后介绍了 CPU 与 GPU 的架构差异,以及 GPU 的关键概念:全局内存(VRAM)、流式多处理器(SM)、块、线程和 32 线程的 warp,并指出全局内存到 SM 的数据传输效率极低。最后讲解了 CUDA 的网格-块-线程层级结构,并通过矩阵乘法示例演示如何编写 CUDA kernel。

技术 › 编程语言 Pramod Goyal 2026-09-2612.5 KB 284.4K 1.4K 68

LLM Inference Handbook 精读:Prefill、Decode、KV Cache,与一切皆权衡的推理工程

本文深度解读 Modular 公司开源维护的《LLM Inference Handbook》,系统梳理 LLM 推理工程的知识体系。文章提炼三大核心框架:prefill(算力受限)与 decode(带宽受限)的两阶段二分法;KV cache 作为系统中心约束的地位,围绕它的 PagedAttention、prefix caching、PD 分离等技术网络;以及“一切皆 trade-off,唯一方法论是 benchmark”的工程哲学。内容还涵盖 continuous batching、speculative decoding、GPU 内存金字塔、FlashAttention、量化与蒸馏三部曲、Agent 生态与部署运维等主题,强调推理优化的本质是围绕有状态 KV cache 做内存管理与调度。

技术 › LLM meng shao 2026-09-2218.3 KB 14.6K 139 84

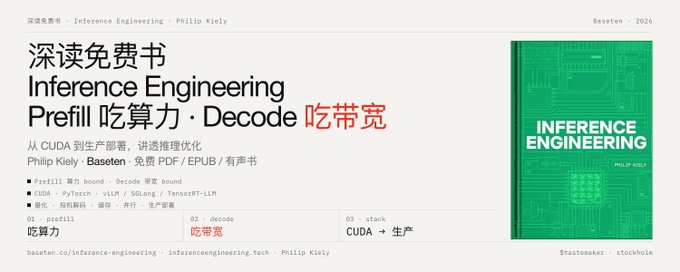
深读免费书「Inference Engineering」:Prefill 吃算力、Decode 吃带宽,讲透从 CUDA 到生产部署的推理优化

文章深度解读 Baseten 出版的免费工程书《Inference Engineering》,系统讲解如何把 AI 模型在生产环境中跑得快、省、稳。全书以三层推理栈(运行时、基础设施、工具层)为骨架,核心分析框架是瓶颈判断:prefill 算力受限、decode 带宽受限、图像视频生成算力受限。内容涵盖模型与硬件理解(算术强度、KV cache、选卡策略)、软件栈(vLLM/SGLang/TensorRT-LLM 三大引擎对比)、五大加速技术(量化、投机解码、缓存、并行、分离部署)及其交互关系,以及生产化部署的延迟全栈账本、故障处理与成本核算,强调约束换性能、技术按组合评估等基本原则。

技术 › LLM meng shao 2026-09-2111.2 KB 13.1K 145 84

MoE 推理工程详解

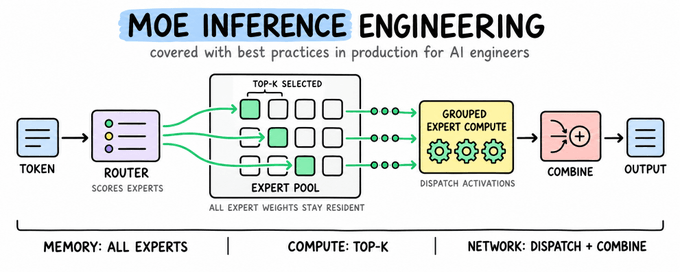
本文系统讲解 MoE(混合专家)模型的推理服务工程原理。从稠密 Transformer 的 FFN 与 MoE 层的区别入手,介绍路由器如何为每个 token 选择专家、dispatch 和 combine 过程如何将路由决策聚合成专家专属矩阵,以及 grouped GEMM 如何减少内核启动开销。文章还涵盖专家并行、拓扑感知部署、显存需求(常驻参数 vs 激活参数)、负载不均衡、容量限制和量化等话题,并分析计算、显存带宽与互连流量之间的性能瓶颈权衡,以 Qwen3-30B-A3B 为实例说明。

技术 › LLM Avi Chawla 2026-09-1929.1 KB 148.8K 316 73

LLM Inference After Training: Prefill, Decode, KV Cache

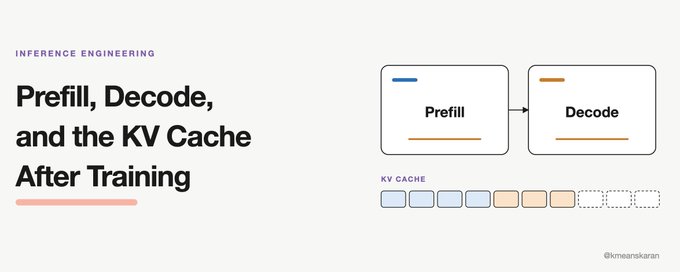
本文系统讲解 LLM 推理阶段的核心原理。作者指出推理与训练不同,分为 prefill 和 decode 两个阶段:prefill 并行处理整个提示词、计算密集型、决定首 token 延迟(TTFT);decode 逐 token 生成、受 HBM 内存带宽限制、决定 token 间延迟(ITL)。文章介绍了 GPU 关键硬件概念(Tensor Core FLOPS、HBM、SRAM),逐步演示一个请求的完整流程(分词、采样、KV cache 机制),并将 FlashAttention、PagedAttention、continuous batching、RadixAttention 等优化技术归位到这两个阶段中,帮助读者理解推理瓶颈与优化方向。

技术 › LLM Karan 2026-09-1713.8 KB 29.4K 187 83

CMP 170HX矿卡软件解锁:8GB显存解锁到64GB,价格涨三十倍的背后

NVIDIA专为挖矿打造的CMP 170HX矿卡,采用与A100相同的GA100芯片,但出厂通过OTP熔丝、寄存器和PCIe限制被锁死显存、算力和接口。2026年8月,研究员Jon Pry利用Falcon安全协处理器的固件校验时间窗口漏洞,通过ROP链获取执行权并修改PLM寄存器,实现纯软件解锁,开源工具CMPUnlocker可将8GB显存解锁至64GB HBM2e。解锁后带宽媲美RTX 5090,跑LLM推理性能反超4090。MiniMax H3开源引发大显存需求暴涨,卡价从三五百涨至1.4万。但文章也提醒风险:无FP8、无NVLink、驱动受限、HBM颗粒不可维修、价格窗口已关闭。

技术 › LLM huangserva 2026-09-159.2 KB 20.3K 38 81

FlashAttention-4 from Scratch to Near-SOTA in 60 Diagrams (cuda/ptx)

作者以60张图解的方式,从零开始在CUDA和少量PTX上构建B200的dense attention kernel,最终达到FlashAttention-4在4K/8K/16K序列长度下94.4%的性能。文章从baseline kernel讲起,逐步介绍每个优化,包含14个kernel的渐进式实现,重点分析Blackwell硬件上softmax与tensor core不对称扩展带来的瓶颈,并通过将softmax开销降低和与matmul重叠来优化。最后将kernel接入视频生成模型作为capstone项目。代码开源,适合GPU kernel研究入门。

技术 › 编程语言 Iaroslav Elistratov 2026-09-1566.6 KB 23.3K 316 92

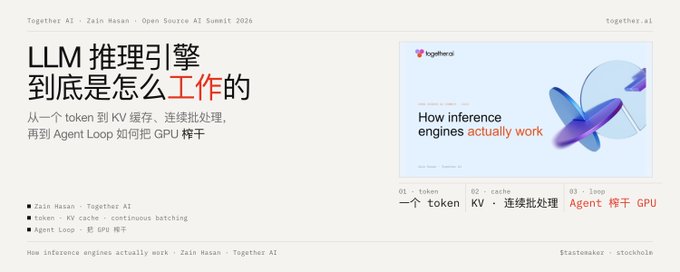
LLM 推理引擎到底是怎么工作的:从 token 到 KV 缓存、连续批处理,再到 Agent Loop

文章基于 TogetherAI 团队 Zain 的分享,沿一个请求的完整生命周期拆解 LLM 推理引擎(vLLM、SGLang、TensorRT-LLM)的内部机制。核心洞察是:prefill 计算受限、decode 内存带宽受限;KV cache 用空间换掉平方级计算,但成为显存瓶颈。引擎通过连续批处理让 GPU 每 pass 都不空闲,PagedAttention 像操作系统管理内存一样管理 KV cache(碎片率从 60-80% 降到 4% 以下),chunked prefill 摊平长 prompt 带来的延迟尖峰。Agent 循环因每轮重发完整对话、输入越来越长而输出极短,使其痛点落在 prefill 与 KV cache 上:prefix caching 可将 100 轮 agent 的总 prefill 工作量从约 55 倍降到约 10 倍,'缓存为王'是 agent 与引擎的交汇点。

技术 › LLM meng shao 2026-09-139.5 KB 46.7K 414 81

越来越值钱的互联:从存储到AI推理这条路,能让GPU少等一会儿,是被95%的人低估了的万亿市场

本文从GPU算力与内存速度不匹配的问题出发,深入分析AI推理中KV缓存的内存占用与复用机制,说明为什么给GPU扩容后计算芯片仍在等待数据。文章以Qwen3-32B为例量化KV缓存大小,比较本地缓存与远端缓存的传输开销,指出连接在缓存共享、跨机器传输中的关键作用。随后分析了铜互连与光互连各自的适用场景,介绍NPO/CPO技术路线,并以Marvell的CXL内存扩容控制器、交换芯片、信号调节芯片和Photonic Fabric为例,梳理连接芯片厂商的商业逻辑与验证进度,最后从客户成本账角度论证互联市场的价值,认为这是一个被低估的万亿级机会。

投资 › 股票 美研芒格君 2026-09-1220.7 KB 15.7K 95 83

The Inference Engineering Skills Map

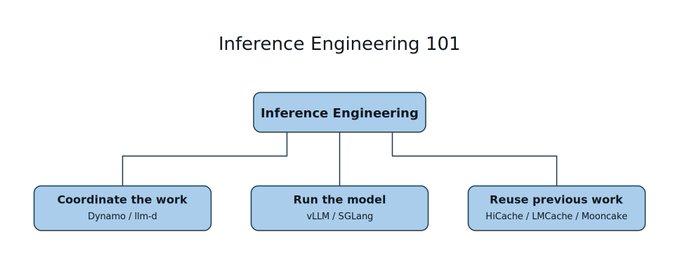
作者从 B2B SaaS Web 开发转向推理工程一个月后分享的入门知识地图。文章将推理工程分为三大类:协调工作(Nvidia Dynamo、llm-d 负责路由、调度与扩展,需智能负载均衡)、运行模型(vLLM、SGLang 处理批处理、张量并行、prefill/decode 分离)、复用先前工作(KV 缓存与 HiCache、LMCache、Mooncake 实现跨 GPU/CPU/NVMe 的分层前缀缓存)。作者强调从 Web 开发转型并不难,不需要精通 CUDA,先跑起模型、发送流量,再逐层深入即可。

技术 › 后端 Nick Khami 2026-09-118.5 KB 17.7K 512 73

深度拆解 OpenAI 自研推理芯片 Jalapeño:英伟达 GPU 的推理瓶颈与软硬协同解法

本文深度拆解 OpenAI 自研推理芯片 Jalapeño 的设计哲学。首先指出英伟达 GPU 在推理场景的三大缺陷:访存密集型任务下 SIMT 掩盖延迟失效、UMA 与庞大 L2 Cache 导致高延迟、全局同步与网络 I/O 瓶颈。接着分析 Jalapeño 的激进重构:砍掉全局 L2 Cache 采用去中心化 Core Slice 架构、在 SM 内塞入超标量控制核心、实现网络直达核心缓存。最后提出行业三大结论:别盲目搞 CUDA 兼容、训练与推理算力格局将两极分化、AI 设计芯片的闭环正在到来。

技术 › LLM lifcc 2026-09-096.0 KB 2K 2 72

什么是 GPU Kernel?

文章介绍了 GPU kernel 的概念及其在模型推理优化中的作用。Kernel 是运行在数千个 GPU 线程上的并行函数,区别于操作系统内核。作者解释了 kernel 的调用流程(如 torch.matmul 经由 cuBLAS 等库启动 kernel),以及编写自定义 kernel 的价值,重点介绍了 kernel 融合(fused kernels)技术,如 FlashAttention 通过在 SRAM 中完成多步计算减少对慢速 HBM 的读写。同时强调自定义 kernel 虽然炫酷但应放在最后考虑,Batching、量化、投机解码、编译器优化等上层手段收益更大。最后推荐从 Triton 入手,并介绍了 ThunderKittens、TileLang、CuTe、Mojo 等新兴 kernel DSL。

技术 › 工具与效率 lucas liao 2026-09-087.0 KB 45K 627 71

Let's Talk About Buying Compute

作者指出 GPU 行业最大的瓶颈并非芯片、CoWoS 或电力,而是信用与残值市场的缺失。银行将 GPU 折旧后残值建模为零,导致资产难以证券化、缺乏对冲工具,小玩家融资成本高达 SOFR+900bps,需巨额首付。文章分析了 NVIDIA 对 OpenAI 数据中心的残值担保、Lambda 和 CoreWeave 的贷款结构,指出这些交易实际依赖客户信用而非硬件清算价值;并对比二手车(Manheim 指数)等行业,介绍 Kalshi H100 合约、Silicon Data 租赁基准及 CME 计划上市的 H100/B200 租赁期货,探讨 GPU 残值定价与算力融资市场的未来。

投资 › 宏观经济 Eugene Ye 2026-09-0622.6 KB 339.1K 859 85

GPT-6 之后AI投资泡沫论的终结和新投资范式指南

文章认为GPT-6 Astra发布后,评测焦点不应是benchmark提升,而是'人可以离开电脑'这一范式变化:AI生产单位从一次回答转变为可持续数小时的数字劳动。作者提出评估Agent的三个核心指标:自主工作时间、监督密度和单任务完成成本,并指出Token计费正失去经济解释力,企业购买的是被正确完成的任务而非Token。基于此,关于GPU、云、数据中心的估值计算方式需要重建。作者以用GPT-6完成上市公司财务分析为例,说明AI可替代初级分析师并十倍放大资深分析师效率,主张建立以Agent-hours和成功任务成本为核心的新AI投资框架。

投资 › 宏观经济 Tigris 2026-09-0411.9 KB 97.6K 204 79

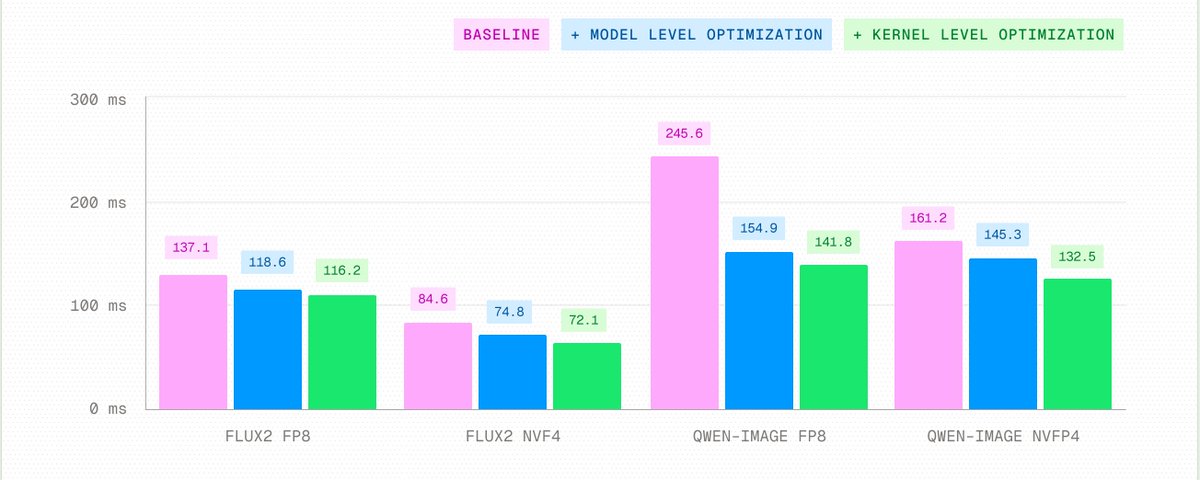
Agentic Kernels in Production

文章介绍了一个面向生产环境的 agentic kernel 优化框架,弥合基准测试与生产部署之间的差距。框架分为模型级优化和单 kernel 优化两层:先对完整 workload 进行 profile,提出算子融合、冗余消除等改进,再并行探索多个 kernel 实现并迭代优化。框架还具备自我改进机制,将成功与失败的优化经验存入知识库供后续复用。在实际部署中,该框架将 Qwen-Image 端到端延迟降低 42.3%,FLUX.2 降低 15.2%,MiniMax M3 吞吐提升 5.5%,具体优化包括 FP8 scale 预打包、QKV 投影融合、归一化与量化融合等。

技术 › LLM Brian Li 2026-08-2917.1 KB 265.1K 758 77

千问 Qwen3.8 27B 本地化部署:小白保姆级教程

本文是一篇面向小手的本地大模型部署教程,作者在配备 AMD Ryzen AI MAX+ 395、64GB 统一内存的 Ubuntu 24.04 机器上,完整演示了如何用 Ollama 部署千问 Qwen3.8 27B 量化模型(UD-Q3_K_XL)。文章首先解释了本地化部署、参数规模、量化(Q3_K_XL)、token 等基础概念,说明本地部署的隐私、离线使用、无次数限制等优势。随后分 Windows 和 Linux 两条路线讲解环境检查、Ollama 安装、模型下载(约 13GB,运行占 29GB)、首次对话,以及如何确认 GPU(ROCm/Vulkan)真正接管计算,并提供常见问题排查方法,最终一条命令即可在本地跑通模型。

技术 › LLM Adrian Punk 2026-08-2820.9 KB 1.1M 1.6K 76

算力期货:下一个万亿美元期货市场

文章探讨了算力金融化的兴起。CME集团与Silicon Data计划于2026年10月推出算力期货合约。2026年AI资本开支达7650亿美元,首次超越油气行业。算力市场面临GPU租金波动、芯片迭代贬值、数据中心建设周期长等风险,急需期货工具对冲。但市场扩展需解决集中度和可互换性两大问题:NVIDIA垄断底层芯片供应,同型号GPU性能差异可达38%。作者发布129页深度报告,分析算力作为资产类的潜力、历史期货市场成败案例、算力交易单位及受益者。

投资 › 宏观经济 Chamath Palihapitiya 2026-08-255.3 KB 219.3K 1.2K 79

AI基础设施的牛鞭效应

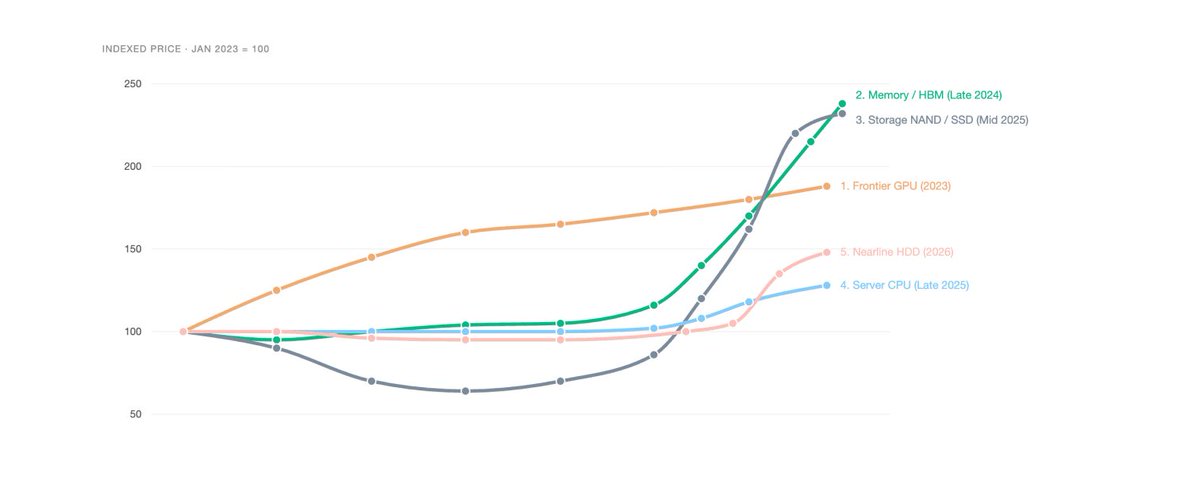
文章分析AI基础设施供应链中的牛鞭效应:从2023年GPU短缺开始,压力依次传导至内存、服务器CPU,再到2026年的大容量存储短缺。HBM生产挤占传统DRAM产能导致SSD价格暴涨,Agent工作流推动CPU需求上升。同时数据中心建设成本高达每吉瓦200亿美元,变压器和涡轮机交付周期长达数年。作者警告,若终端软件收入无法匹配巨额资本支出,2027-2028年新增产能交付时或将面临产能过剩危机。

投资 › 宏观经济 Tomasz Tunguz 2026-08-246.3 KB 40.9K 135 85

How a GPU Actually Works

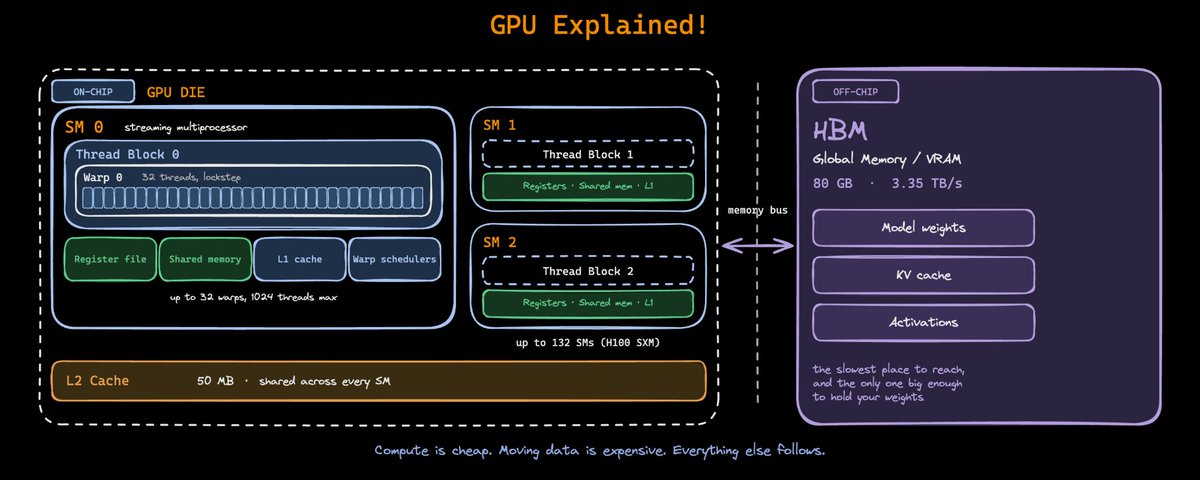
本文从硬件原理出发,解释了GPU为何在运行大模型时算力利用率低的现象。核心在于计算与内存带宽之间的不对称:算术操作便宜,而数据搬运昂贵。GPU通过大量简单计算单元和线程级并行来掩盖内存延迟,但受限于内存带宽,导致实际token生成速度远低于理论算力。文章还介绍了warp、分支分歧、内存延迟隐藏等概念,并指出性能优化技巧(如量化、投机解码、连续批处理)的本质是减少数据移动。

技术 › LLM Akshay 2026-08-1430.0 KB 853.2K 943 73

一口气了解英伟达

本文深入剖析英伟达的商业模式与战略布局。文章从英伟达的创业历程讲起,阐述了其从图形芯片到AI计算平台的转型,并重点分析了CUDA软件生态如何构建护城河。近期,英伟达与Apollo、BlackRock等六家机构签署谅解备忘录,计划动员超5000亿美元第三方资本,用于AI算力基础设施建设。文章详细拆解了这一融资平台的运作逻辑、潜在风险(如目标未到账、需求与融资缠绕、设备贬值、客户集中等),并总结了英伟达成功的关键:先做工具、沿客户阻力前行、让每层业务可独立核算。最后,作者提出了观察后续发展的三个具体信号。

投资 › 宏观经济 Luna 2026-08-1219.0 KB 5.1K 12 87

使用 SGLang 和 Torch Profiler 对 LLM 推理进行性能分析

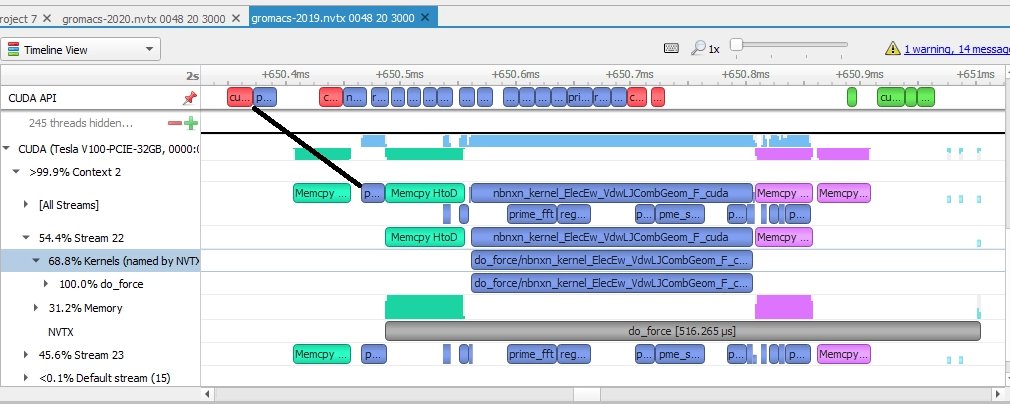
本文详细介绍了如何使用 SGLang 内置的 Torch Profiler 对大语言模型(Qwen3.5-0.8B)进行推理性能分析。作者阐述了如何通过追踪 CPU 和 GPU 端事件来定位计算瓶颈,并结合屋顶线模型证实单批次解码主要受限于内存带宽。文中展示了如何利用 Perfetto UI 分析 Prefill 阶段的性能追踪数据,将其底层计算操作与模型的混合架构(如 Gated DeltaNet 和全注意力机制)精准映射,帮助读者深入理解 LLM 的底层执行流程。

技术 › LLM Jino Rohit 2026-08-0913.8 KB 104.1K 916 88