Wiki 知识库

全部文档 / 作者: Jerry Fang

2 篇
清除

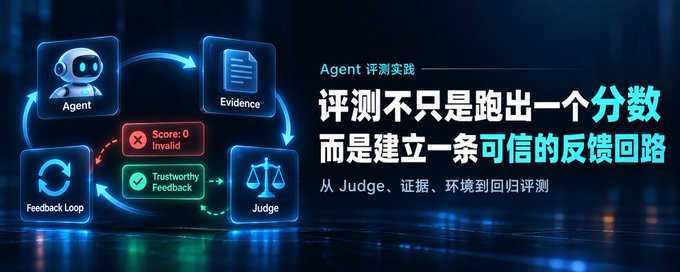
Agent评测入门,我最推荐Anthropic这篇文章

作者结合自身开发问答机器人Agent评测系统的工程实践,推荐并解读Anthropic的文章《Demystifying evals for AI agents》。文章分享了8个核心经验:Agent看到的信息与Judge评分时能获取的证据可能不一致,导致高准确率仍被判失败;LLM Judge的输出需要像外部API一样严格校验;信息不足时应允许Judge返回Unknown而非强行打分;评测环境配置、数据集同步、systemd部署等基础设施问题常导致结果不可信;需区分评分低与评分无效;要区分Capability Eval与Regression Eval,并使用pass@k、pass^k指标评估稳定性;以及务必人工检查Transcript而非只看分数。文章提供了大量真实踩坑案例,对Agent评测落地极具参考价值。

技术 › Agent Jerry Fang 2026-10-1622.1 KB 3K 17 87

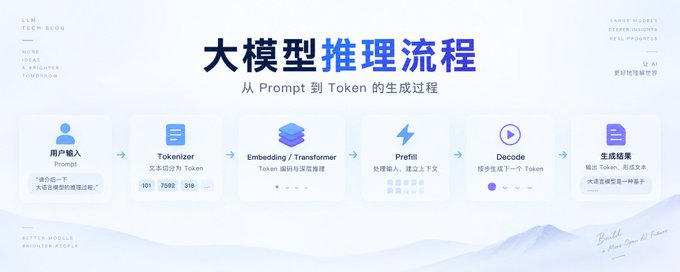
一文了解大模型推理流程

文章系统讲解大模型推理的完整流程:输入文本先经Tokenizer切分为token并转换为token id,再通过Embedding转为带位置信息的语义向量;随后进入Prefill阶段,模型并行处理整个prompt,通过Transformer的Self-Attention计算Q、K、V并生成KV Cache,经Causal Mask确保不偷看未来token;最后经LM Head和softmax输出第一个token。进入Decode阶段后,逐个生成token、不断更新KV Cache,直到满足EOS、max_tokens或stop条件终止,最终反解码为文本输出。

技术 › LLM Jerry Fang 2026-09-184.9 KB 1.4K 8 53