Wiki 知识库

全部文档 / 标签: Agent评测

7 篇
清除

Agent 高频题 04. Agent 效果怎么评测:评测集怎么建、指标怎么定、怎么证明变好了

本文是 Agent 高频面试题详解系列第 4 题,系统讲解 Agent 效果评测体系。文章基于 64 场面试面经分析,归纳出评测追问的八个方向,并结合 Anthropic、OpenAI 等实践经验展开:先明确评什么(Agent 评测难在结果在环境状态中、路径不唯一、结果不确定);评测集怎么建(题目来自真实失败、业务方、合成数据,注意分层、防泄露与防过拟合);谁来打分(代码判分、模型判分、人工判分三种方式的取舍,LLM-as-a-Judge 的位置偏差、冗长偏差等已知问题及校准方法);以及如何通过基线对比、多次运行排除随机性,证明改进真实有效。文章强调评的是 Harness 和模型的整体,判结果而非规定路径。

技术 › Agent 码良 2026-10-2562.0 KB 5.1K 38 88

Agent评测入门,我最推荐Anthropic这篇文章

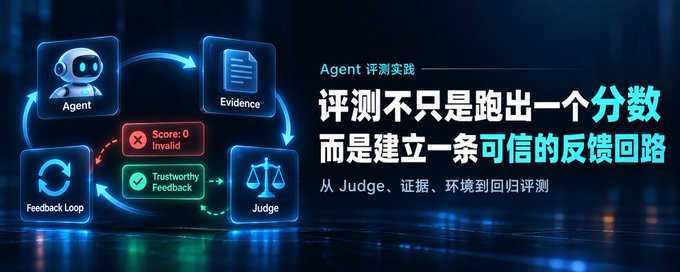
作者结合自身开发问答机器人Agent评测系统的工程实践,推荐并解读Anthropic的文章《Demystifying evals for AI agents》。文章分享了8个核心经验:Agent看到的信息与Judge评分时能获取的证据可能不一致,导致高准确率仍被判失败;LLM Judge的输出需要像外部API一样严格校验;信息不足时应允许Judge返回Unknown而非强行打分;评测环境配置、数据集同步、systemd部署等基础设施问题常导致结果不可信;需区分评分低与评分无效;要区分Capability Eval与Regression Eval,并使用pass@k、pass^k指标评估稳定性;以及务必人工检查Transcript而非只看分数。文章提供了大量真实踩坑案例,对Agent评测落地极具参考价值。

技术 › Agent Jerry Fang 2026-10-1622.1 KB 3K 17 87

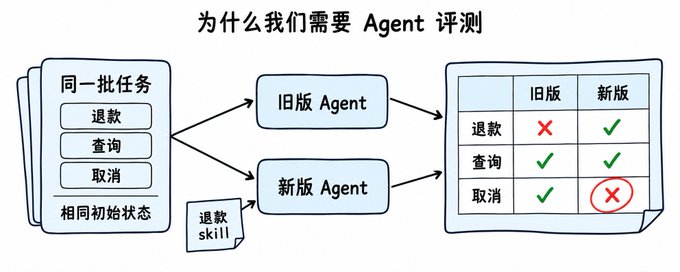
为什么我们需要 Agent 评测

本文是 Agent 评测系列的第一篇文章,作者结合业界共识与个人实践,阐述了 Agent 评测的重要性。文章从一次线上问题修复切入,说明传统后端开发流程难以应对 Agent 的概率性输出与执行路径的不确定性。作者给出 Agent 评测的定义:围绕具体任务,按明确标准检查 Agent 执行过程(trace)和结果的方法。核心价值包括:防止越修越坏、判断改动是否真的变好、确认任务稳定性、明确完成标准、指导迭代优先级。文章还提出评测落地的五步流程:整理任务、写清标准、准备一致环境、运行新旧版本对比、持续更新案例,并提醒注意评测集划分、标准本身可能出错等问题。

技术 › Agent 黄同学h 2026-10-1220.2 KB 15.5K 236 76

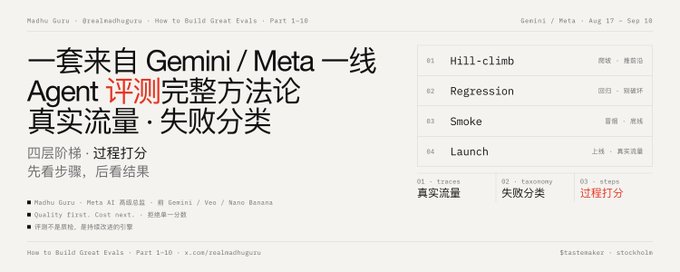
一套来自 Gemini/Meta 一线的 Agent 评测完整方法论:真实流量、失败分类、四层阶梯、过程打分

本文梳理 Meta AI 高级总监 Madhu Guru 的「How to Build Great Evals」十篇系列,总结一套 AI Agent 评测工程方法论。核心观点:评测应锚定真实用户流量而非实验室数据;先建立可信质量信号再降成本;挖掘 500-1000 条真实交互建立精确的失败分类;采用爬坡、回归、冒烟、上线四层阶梯组织评测;反对将质量压缩为单一平均分;按阶段度量中间步骤而非只看最终结果;评测体系须随用户行为演进持续更新。文章同时指出其局限:缺少统计测量学基础、未正面处理过程与结果评测的权衡。

技术 › Agent meng shao 2026-09-1111.1 KB 7.9K 75 85

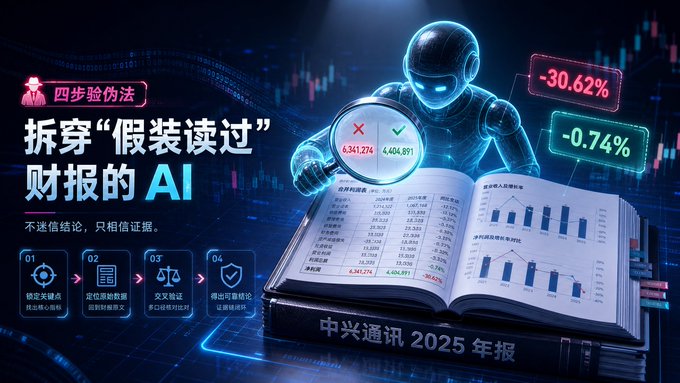
不迷信结论,只相信证据!四步验伪法教你拆穿"假装读过"财报的AI

文章指出炒股者多依赖二手信息,而AI读财报虽有价值,却存在编造数字、跨表算错、盲目自信、中途改口径崩溃等问题。作者以中兴通讯2024/2025年报为测试案例,用Apodex 1.1验证了一套四步验伪法:问网上搜不到的问题、强制列出数据出处、跑到一半改口径、手动核对至少一个数。测试显示AI能发现负少数股东损益异常并交叉验证数据,但作者仍抓到一处补充说明中约6%利润抬升的错误概括(实际两年相差一个数量级)。结论强调每个带百分比的句子都要核对,并介绍了FrontierAgent开源harness及相关工具。

技术 › Agent 得否 2026-09-0912.1 KB 19K 91 83

用 WikiBench 评估 OpenWiki

LangChain 开源了代码库文档生成与维护的 agent——OpenWiki,并构建了 WikiBench 来回答两个问题:wiki 是否真正帮助编码 agent?对 OpenWiki 的改动是否让它变得更好?WikiBench 基于 Harbor 框架运行,环境为固定 commit 的仓库,agent 生成 wiki,verifier 通过 reader agent 回答覆盖类和检索类问题,并用多个 LLM judge 基于事实 rubric 打分。实验显示:不同 harness 和模型在性能、成本和时间上差异显著;wiki 与源码结合使用效果最佳,wiki 更像索引而非替代品,可让 agent 回答更准确且成本更低。

技术 › Agent LangChain 2026-08-276.8 KB 38.1K 55 73

你的下一个联系人,可能不是人 | 实测 Bloome

文章深度评测了新兴的 IM 产品 Bloome,其核心在于打破传统交互假设,将 AI Agent 视为通讯录中的“一等公民”。用户可以像加好友一样添加 Agent,拉人机混合群聊,甚至付费订阅他人的专业 Agent。文章通过实测展示了 Bloome 在创建 Agent、多模型接入(如 Claude Code、Codex)以及群聊交互上的创新细节,探讨了这种新型“人+Agent”关系网对 AI 互联网未来的潜在影响。

技术 › Agent koji 2026-05-078.8 KB 1.4K 7 74