Wiki 知识库

全部文档 / 标签: Embedding

20 篇
清除

Agent 高频题 01. 讲讲你的 RAG 链路

本文是 Agent 高频面试题详解系列第一篇,聚焦 RAG(检索增强生成)链路。文章基于近两个月牛客网 82 场面试的统计,指出 RAG 是最常被追问的题目。内容先给出 RAG 整体架构图,解释为什么需要 RAG 及其与长上下文、grep、微调、工具调用、记忆等方案的边界;再沿离线、在线两条线逐环讲解:离线部分涵盖文档解析、切分策略、embedding 向量化、HNSW/IVF 索引原理;在线部分讲解问题改写、BM25 与向量多路召回、RRF 融合、交叉编码器重排等环节。每个环节均附上面试常见追问,并提供复习优先级参考。

技术 › Agent 码良 2026-10-2041.5 KB 10.7K 70 78

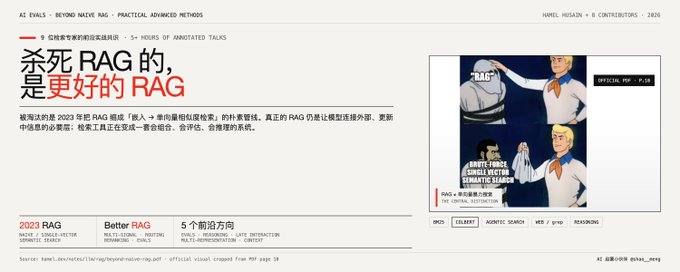
杀死 2023 RAG 的,是更好的 RAG:9 位检索专家的前沿实战共识「Beyond Naive RAG」

本文介绍 Hamel Husain 主编的演讲合集《Beyond Naive RAG》,汇集 9 位一线检索专家的共识:朴素 RAG(切块+单向量+余弦检索)已失效,但检索增强生成本身远未死亡。全书论证三条主线:长上下文不能替代检索(Context Rot 证明上下文越长模型越不可靠);评估先于优化(公开基准已污染,须建自有黄金数据集);复杂性不是目的(慎用图数据库等过度工程)。涵盖 ColBERT 后期交互、推理增强检索(Promptriever、Rank1)、多重表示与智能路由、FreshStack 评估指标等前沿方法,提出'评估驱动+多表示+推理增强+克制架构'的实践观。

技术 › LLM meng shao 2026-10-1211.9 KB 4.7K 43 84

万字总结:成为 Agent 工程师的学习线路

作者面试一家 AI+Web3 公司失败后,获得面试官分享的《Agent工程师入门指南》,并结合自己的学习心得整理成一条完整的 Agent 工程师学习路线。内容涵盖 LLM 基础(Transformer、Token、上下文窗口、采样参数、API 协议、流式输出、结构化输出、工具调用、Embedding)、Prompt Engineering(Zero-shot/Few-shot、CoT、ReAct、Reflexion)以及 RAG(文档解析、分块、检索与重排)等核心知识。每个知识点都附有学习文档链接、项目要求和验收标准,帮助学习者系统掌握 AI 应用开发技能并检验学习成果。

技术 › Agent Chasen 2026-10-1148.9 KB 130.2K 1.6K 85

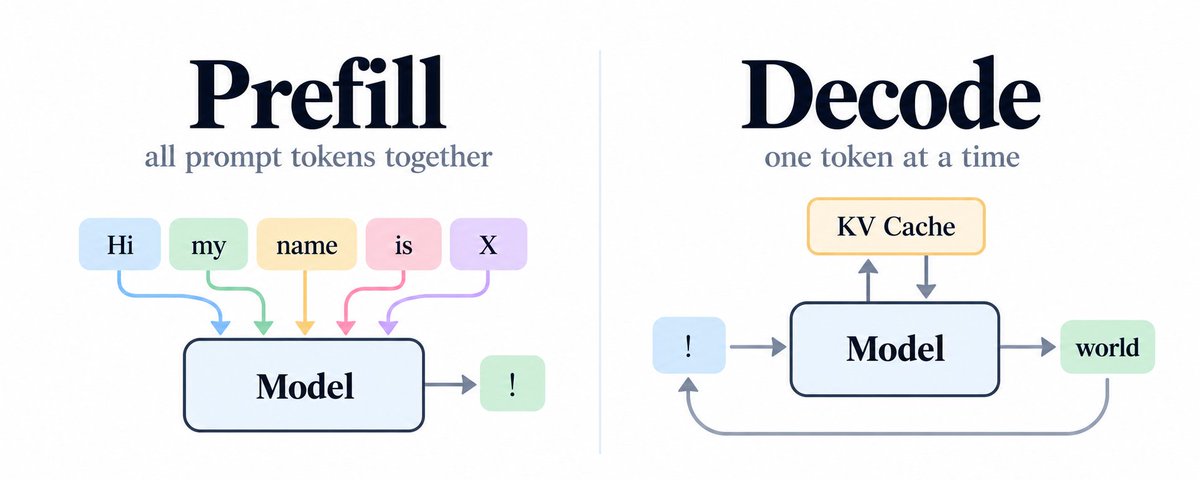
Prefill & Decode made Crystal Clear

本文从第一性原理出发,逐步讲解 LLM 推理过程中 Prefill 和 Decode 两个阶段的真实含义。作者先介绍自回归模型逐 token 预测的基本机制,然后通过 ChatGPT 聊天的例子,展示文本如何经过分词、token ID、embedding 转化为 S×D 矩阵并进入 Transformer 层。重点澄清一个常见误解:处理输入 prompt 时模型并非逐个 token 顺序处理,而是因为所有输入 token 已知,可以并行处理——这一整个输入处理过程就是 Prefill。文章还引出因果掩码等问题,帮助读者建立对推理流程的正确直觉。

技术 › LLM Abhinandan 2026-10-0326.3 KB 9.2K 133 64

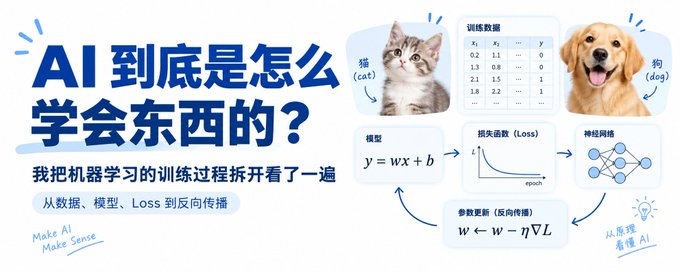
AI 到底是怎么学会东西的?我把机器学习的训练过程拆开看了一遍

文章以通俗易懂的方式拆解机器学习的训练原理。作者从传统编程与机器学习的思维差异切入,说明机器学习是让计算机从数据中自行寻找规律。随后讲解核心概念:X→Y 的映射、特征与标签、向量/矩阵/张量的数据表示、Embedding 的意义;再解释模型本质是带大量可调参数的函数,训练通过损失函数衡量错误,借助导数与梯度判断参数调整方向,梯度下降如蒙眼下山的比喻直观呈现了这一过程。文章还涵盖局部最优与鞍点、泛化能力、Batch/SGD/Mini-batch 的取舍以及 Adam 优化器的改进思路,帮助初学者建立机器学习的整体认知框架。

技术 › 编程语言 joy 2026-09-2228.1 KB 2.2K 25 69

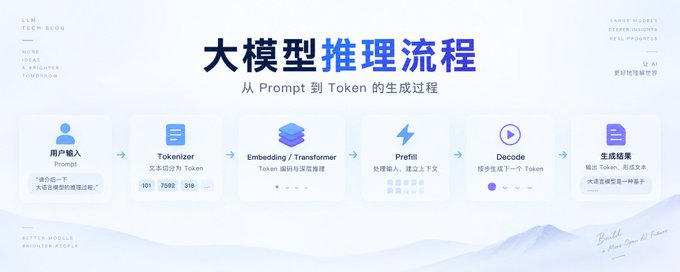
一文了解大模型推理流程

文章系统讲解大模型推理的完整流程:输入文本先经Tokenizer切分为token并转换为token id,再通过Embedding转为带位置信息的语义向量;随后进入Prefill阶段,模型并行处理整个prompt,通过Transformer的Self-Attention计算Q、K、V并生成KV Cache,经Causal Mask确保不偷看未来token;最后经LM Head和softmax输出第一个token。进入Decode阶段后,逐个生成token、不断更新KV Cache,直到满足EOS、max_tokens或stop条件终止,最终反解码为文本输出。

技术 › LLM Jerry Fang 2026-09-184.9 KB 1.4K 8 53

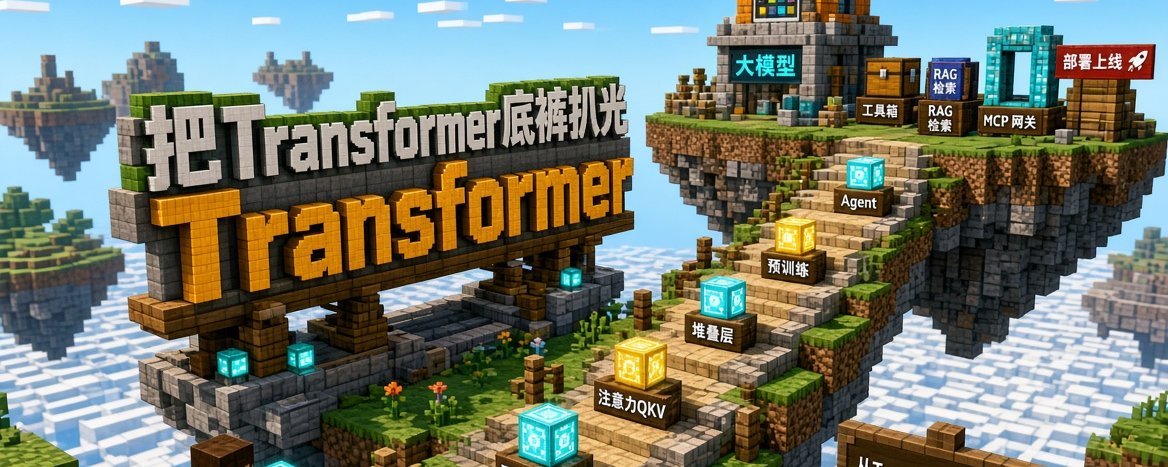
把Transformer底裤扒光,从Transformer到大模型

本文从零开始,深入浅出地讲解了Transformer的原理及其如何演变为大语言模型。文章首先介绍大模型的目标是预测下一个词,然后详细解释了如何将文字转换为数字,包括Token、Token ID、Embedding Matrix等概念。接着,重点剖析了Transformer的核心——注意力机制(Q、K、V)、多头注意力、位置编码、FFN以及残差连接等组件,最后概述了模型的训练过程。全文无需前置知识,适合初学者理解大模型的基础架构。

技术 › LLM 南晚Nanwan 2026-09-0944.4 KB 52.9K 157 70

我给 DeepSeek Harness 做了个 zvec-grep 插件,实现基于语义的高效文本检索工具

作者基于阿里巴巴开源的进程内向量数据库 zvec 及面向代码仓库的语义检索工具 zvec-grep,开发了一个 DeepSeek Harness(DSH)插件 dsh-zvec-grep。文章是开发笔记,先通过真实仓库实验确认语义搜索的价值:在不知道代码命名时提供更好的“第一跳”,与 rg 精确搜索形成互补。插件没有简单包装 CLI,而是直接使用 createZvecGrep() 引擎 API,以 workspace 为运行时边界共享索引与 watcher,实现自动索引、增量更新与每小时校准,并通过状态胶囊向用户暴露索引进度与错误,退出时用 AbortController 清理资源。作者总结插件设计理念:替用户承担复杂度,暴露不确定性,让语义搜索负责模糊发现、精确搜索负责已知匹配。

技术 › Agent VerySmallWoods 2026-09-0713.7 KB 4.6K 24 82

读懂大模型|别怕,大模型的本质就是一个函数

文章以 DeepSeek 开源的 V4-Flash-Vision-Exp 为例,深入浅出地讲解大模型的本质:一个做矩阵运算的超大函数。作者介绍了模型文件结构(权重分片、config.json、tokenizer.json),并详细解析输入输出处理流程,包括文本分词、BPE 算法、Embedding、MoE 混合专家架构、概率性输出与自回归生成机制。此外还逐项解读了核心参数,如词表大小、网络层数、注意力头数、YaRN 长上下文伸缩、视觉模块和 FP8/FP4 低精度量化等,帮助读者建立对大模型原理的整体认知。

技术 › LLM ray 2026-09-0413.7 KB 2.9K 7 74

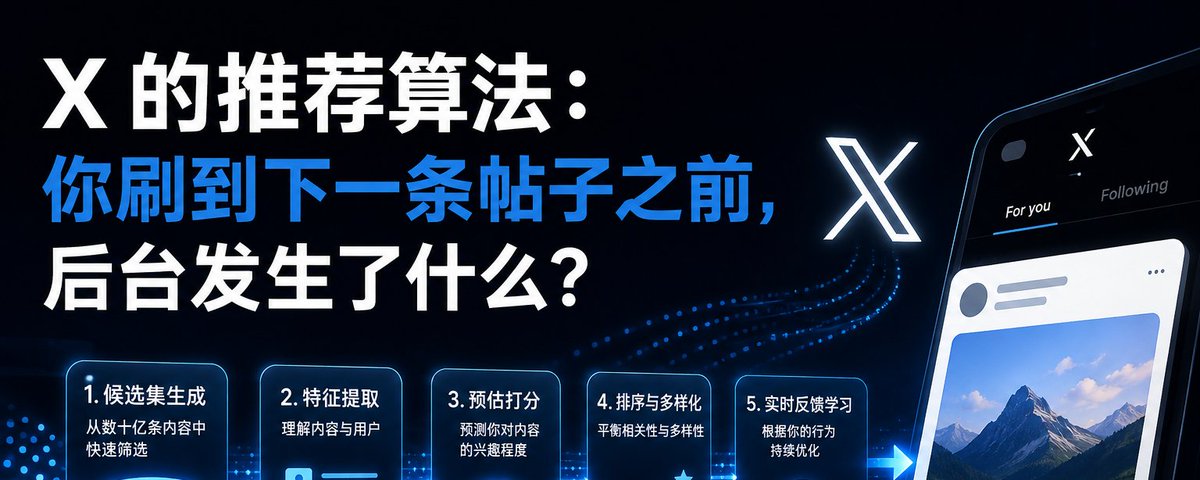
X 的推荐算法:你刷到下一条帖子之前,后台发生了什么?

文章解析 X 平台最新开源的推荐算法代码,详细拆解一条帖子从召回、用户行为建模、Phoenix 多任务行为预测、RankingScorer 综合排序,到可见性过滤、多样性控制的完整链路。文章还分析了新增的 recon 重建式 embedding、StableHLO 模型导出与推理优化等技术细节,指出 X 推荐系统本质上是多目标监督学习加规则过滤加综合排序,而非完整强化学习。作者评价了系统的亮点(多动作预测、排序与安全分工、生产化程度高)与公开代码尚未回答的疑问(权重确定、性能提升数据等),强调推荐质量取决于整条链路的配合。

技术 › 推荐系统 Bright | 李小明 | 明说开源 2026-09-0219.7 KB 1.6K 3 76

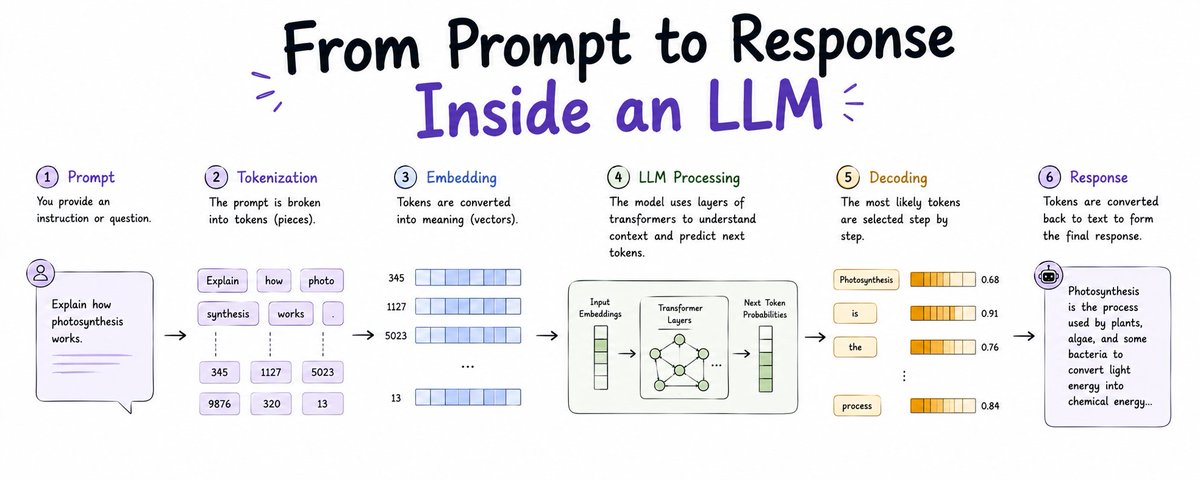
From Prompt to Response Inside an LLM: A Visual Step-by-Step Journey With Code

本文通过代码示例和可视化图表,深入剖析了大型语言模型(LLM)从接收提示到生成响应的完整内部流程。内容涵盖分词(Tokenization)、嵌入与位置编码(Embeddings and Positional Encoding)、自注意力机制(Self-Attention)等核心环节,并提供了使用tiktoken和HuggingFace库的实用代码,帮助读者理解模型如何处理文本、构建上下文并生成输出。文章旨在打破“Transformer魔法”的黑箱,为技术爱好者和开发者提供直观、可操作的LLM内部工作原理指南。

技术 › LLM Vikas gupta 2026-08-1519.6 KB 13.6K 14 77

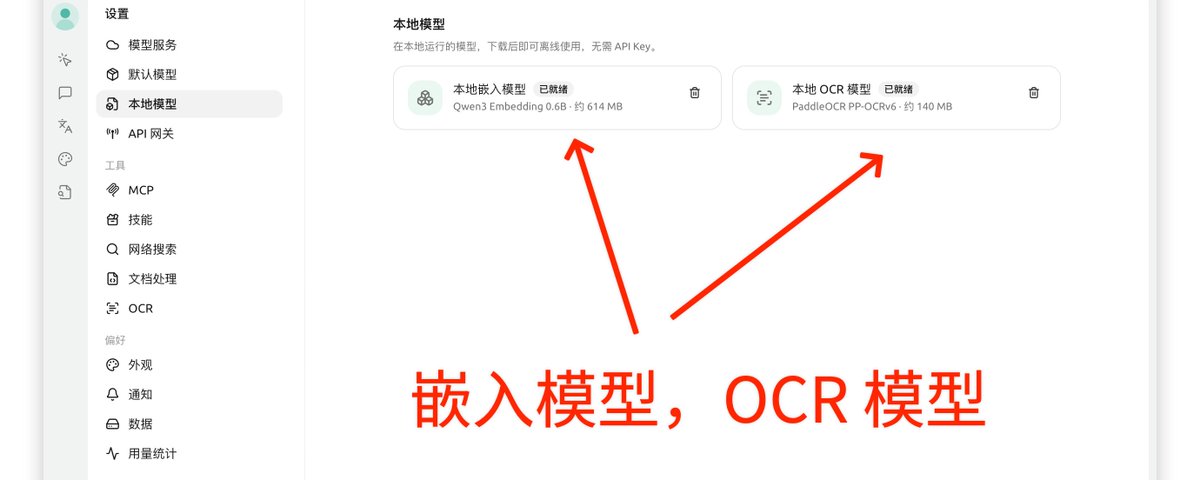
聊聊 Cherry Studio 2.0 对本地模型的支持

文章探讨了 Cherry Studio 2.0 对本地模型的支持策略。作者认为本地模型的主要价值不在于替代云端大语言模型,而是通过 Embedding、OCR、ASR 和数据脱敏等轻量级模型,补齐 AI 产品中的关键基础能力。这种设计旨在降低用户使用门槛,提高隐私保护,并确保功能的稳定性。

技术 › 工具与效率 Yinsen 2026-08-067.8 KB 7.3K 29

《指挥 AI,做出一个企业级 Agent》08:企业 RAG 不是上传几个 PDF

文章指出企业 RAG 不仅仅是上传 PDF 回答问题,更需关注文档版本、权限、来源追溯及停用管理。作者通过模拟企业真实文档环境,构建了包含版本控制和过滤机制的评测体系,强调了可靠检索与诚实无答案的重要性,并分享了针对小规模知识库的技术选型经验。

技术 › Agent jager 2026-07-227.8 KB 21.2K 186

How we built our knowledge base

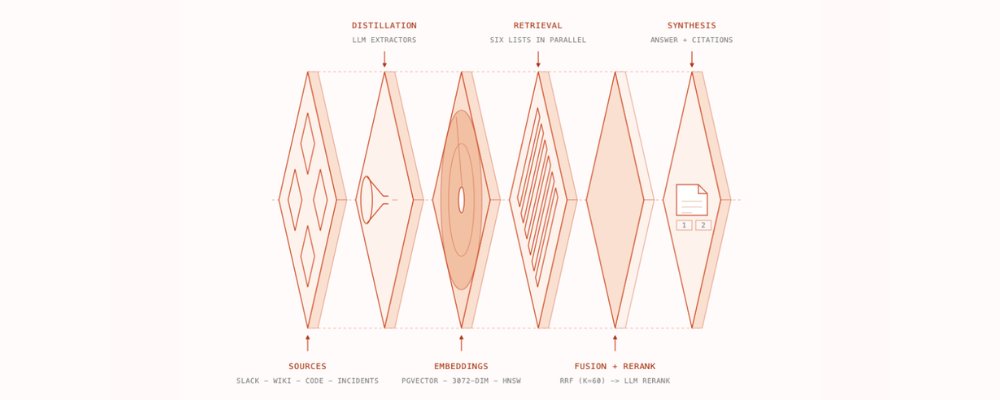
Cerebras 分享了如何构建内部知识库,该系统每天处理超过 15,000 个查询。文章介绍了其数据采集架构,特别是如何通过混合搜索技术(全文搜索、Embedding 搜索、IDF 和时间衰减)来处理非结构化的 Slack 对话,以提高信息检索的准确性和实时性。

技术 › 后端 Cerebras 2026-07-17261.6 KB

RAG 像素级拆解实战:索引、混合检索与评测体系

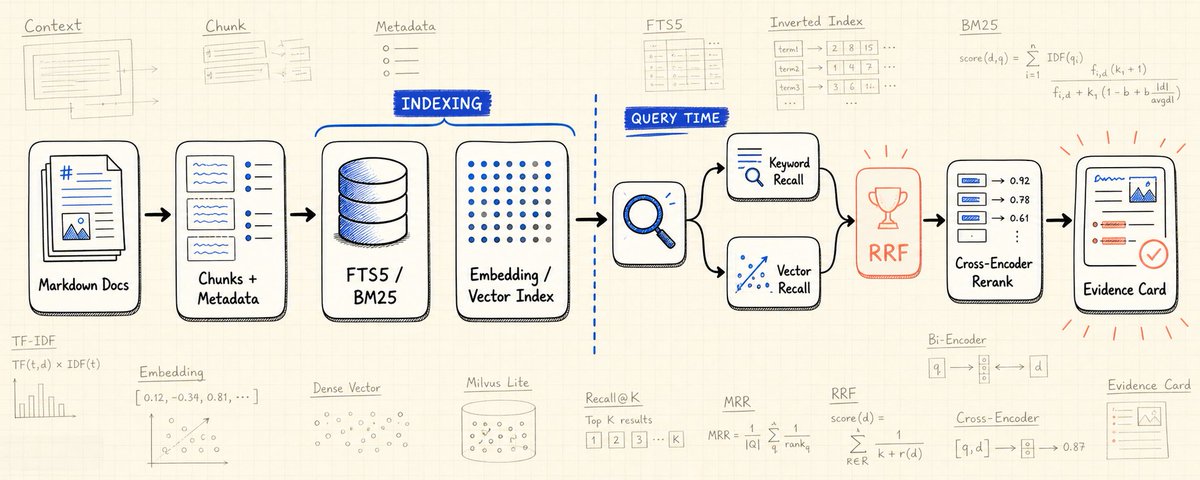
本文通过 Notebook 实战项目,对 RAG 系统的索引与检索过程进行了深度解析。内容涵盖文档切分(Chunking)、SQLite FTS5 倒排索引、BM25 关键词检索、向量 Embedding 语义检索,以及基于 RRF 的混合检索召回策略。此外,文章还介绍了如何构建评测集来验证检索效果,提供了完整的代码与数据结构示例,旨在帮助开发者理解 RAG 底层运作原理与工程实践细节。

技术 › LLM MateMatt 2026-07-1218.3 KB 43.4K 40

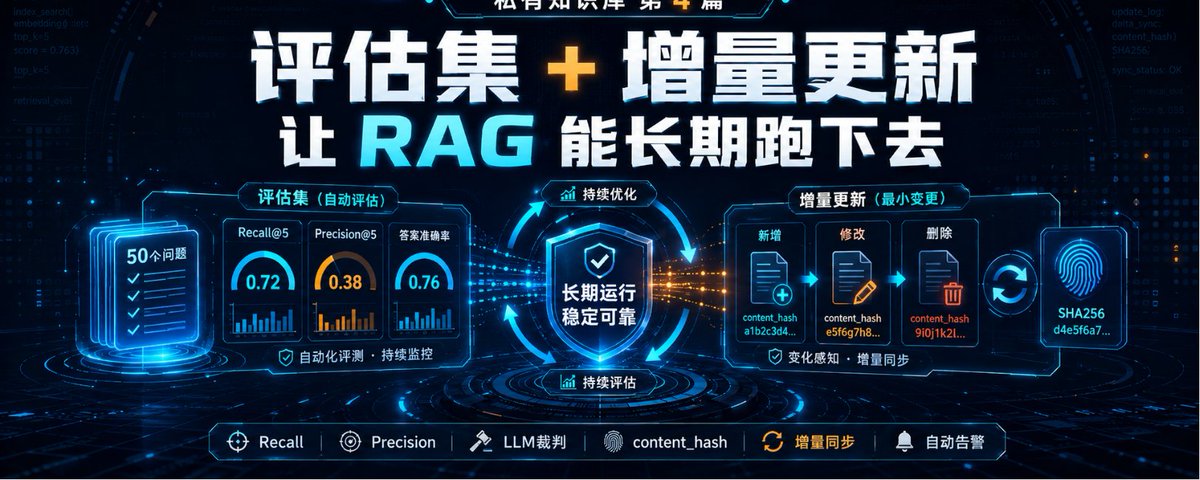
私有知识库第4篇:评估集 + 增量更新,让 RAG 能长期跑下去

文章探讨了 RAG(检索增强生成)系统长期运行的两大难题:评估与更新。作者提出建立包含50个问题的“评估集”,通过 Recall、Precision 和 LLM 辅助的答案准确率来量化系统效果,避免盲目调参。同时,针对文档更新导致的全量重建成本问题,介绍了基于内容 Hash 的增量更新策略,仅处理变动文档,大幅降低资源消耗与停机时间。

技术 › LLM A Ando 2026-07-0817.6 KB

如何把聊天记录变成可检索知识库(2026版)

文章探讨了如何将微信、Telegram等平台的聊天记录转化为可用的个人知识库。作者从数据获取、清洗降噪(语义分块、去重、上下文修复)到存储检索(Embedding选型、GraphRAG)提供了全流程的技术指导,并提出了数字分身、知识传承等多种应用场景。

技术 › LLM AI最严厉的父亲 2026-05-1226.8 KB 59K 158 91

不做中转,不卖课,如何用 AI 月入 10万

作者分享了今年通过接企业知识库项目实现月入数万的实战经验。文章详细阐述了如何将基础 RAG 升级为企业级 RAG 系统,重点涵盖数据处理层面的文档切分策略(针对 PDF、Excel、代码等)、向量化模型选择及数据库选型;同时深入讲解了检索策略优化,包括长问题处理、混合检索、Rerank 精排及多因素加权排序等技术细节。

技术 › LLM M Miles. 2026-05-1226.8 KB 91

如何精通 RAG 并构建拥有完美记忆的 AI Agent (全流程教程)

本文是一篇关于检索增强生成(RAG)技术的完整教程。文章指出,大多数 AI Agent 难以落地的原因在于模型无法获取企业私有数据。RAG 通过将外部知识库与大模型结合,解决了这一痛点。作者详细拆解了构建 RAG 系统的五个核心阶段:文档摄取与分块、文本嵌入、向量存储、信息检索以及最终生成,并提供了关于分块策略、嵌入模型选择及混合检索的实战建议。

技术 › LLM Khairallah AL-Awady 2026-05-0113.7 KB 191.9K 662 78

一个 Token 的自我解剖:从分词到输出生成的全流程解析

文章以第一人称视角(Token),生动通俗地讲解了 Token 在大模型中的“一生”。内容涵盖 Token 的定义、分词方式(如 Byte-level BPE)、向量化原理、训练赋予语义的过程,以及在 Transformer 架构中通过 Q、K、V 和注意力机制进行指令处理与输出生成的完整技术链路。

技术 › LLM 程序员Left 2026-04-1614.7 KB 24.1K 47 65