Wiki 知识库

全部文档 / 标签: LLM-as-Judge

6 篇
清除

当 AI 学会行动,我们却还没学会评判:普林斯顿、斯坦福等团队 72 页综述深度解读「智能体评测新学科」诞生

普林斯顿、斯坦福等机构联合发布 72 页综述「Emerging Trends in AI Agent Evaluation」,以 How(怎么做)、What(测什么)、Who(谁来做)三维度梳理智能体评测的 33 个趋势。核心论断:随着 AI 从回答问题走向自主行动,传统跑分范式失效,agent 评测正成为一门以心理测量学为骨架的新学科。文章介绍了效度危机、pass@k 与 pass∧k 区分、因果归因、污染新表面、LLM 裁判等方法论问题,以及模拟用户失真、田野实验负面结果、评测环境成为攻击面等实证发现,并直言评测生态受资金、访问权与议程影响,独立评测面临生存危机。

技术 › Agent meng shao 2026-10-2110.7 KB 5K 30 85

Agent评测入门,我最推荐Anthropic这篇文章

作者结合自身开发问答机器人Agent评测系统的工程实践,推荐并解读Anthropic的文章《Demystifying evals for AI agents》。文章分享了8个核心经验:Agent看到的信息与Judge评分时能获取的证据可能不一致,导致高准确率仍被判失败;LLM Judge的输出需要像外部API一样严格校验;信息不足时应允许Judge返回Unknown而非强行打分;评测环境配置、数据集同步、systemd部署等基础设施问题常导致结果不可信;需区分评分低与评分无效;要区分Capability Eval与Regression Eval,并使用pass@k、pass^k指标评估稳定性;以及务必人工检查Transcript而非只看分数。文章提供了大量真实踩坑案例,对Agent评测落地极具参考价值。

技术 › Agent Jerry Fang 2026-10-1622.1 KB 3K 17 87

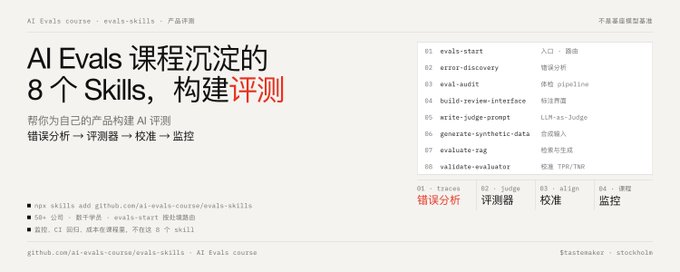
AI Evals 课程沉淀的 8 个 Skills:错误分析 → 评测器 → 校准 → 监控

文章介绍了来自 Hamel Husain 和 Shreya 的 AI Evals 课程沉淀的 8 个 Skills,帮助工程师和产品经理为自己的 AI 产品构建评测体系。核心理念是先看数据再写评测:先手动阅读真实 trace 做错误分析,发现失败模式,再针对每个模式构建评测器,并用约 100 条人工标注校准(TPR/TNR 目标 >90%)。8 个 Skills 覆盖入口路由、错误分析、评测审计、合成数据生成、Judge 提示词编写、评测器校准、RAG 评测和标注界面构建。方法论强调二值评判、单一 judge 测单一失败模式、Rogan-Gladen 偏差修正等最佳实践。

技术 › LLM meng shao 2026-09-238.6 KB 13.9K 66 85

LLM-as-Judge Architectures: Putting Evals Into Your Agent Runtime

文章探讨将 LLM-as-Judge 从离线评估工具迁移到 Agent 运行时架构中的趋势。传统确定性软件可通过类型检查、断言等方式验证结果,而 AI 应用输出往往需要判断性评估,LLM judge 能让应用自我完成这些判断。作者介绍了几种常见模式:使用另一个模型(包括专用小型评估模型以降低成本)、将大而模糊的判断拆解为多个小判断并用 DAG 结构组合、用成对比较代替打分以规避位置偏差、在 Agent 工作过程的关键节点(如检索、方案选择)设置检查点而非仅评估最终答案,以及使用多评委投票、辩论等机制提升可靠性。

技术 › LLM Josh Rosen 2026-09-0913.2 KB 90.3K 681 77

使用 Google Agents CLI 构建智能体评估内循环

本文是 Google 关于智能体质量飞轮的实操续篇,介绍如何用 agents-cli 手动运行评估内循环。作者构建了一个汇率转换智能体 fx-agent,并故意在指令中植入缺陷(未要求在回复末尾列出所使用的工具),通过六个测试用例的评估集验证:内置 AutoRaters 指标会遗漏此类缺陷,因此需要将关键行为提升为自定义指标(LLM 评审与正则代码检查双重视角)来单独度量。随后修复一行指令,并用分数变化证明修复有效。文章强调评估的意义在于检查智能体是否遵守规则,而非答案表面质量。

技术 › Agent Google Cloud Tech 2026-08-2815.9 KB 31.9K 289 85

Autoresearch在Listen的应用:从客观指标到偏好判断

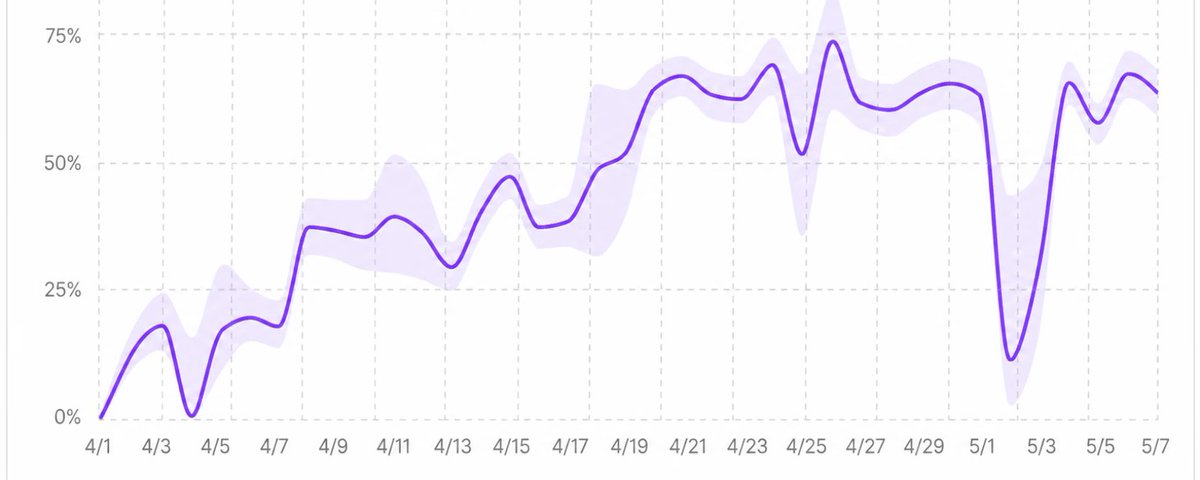
本文介绍了Listen Labs如何将Karpathy的autoresearch模式应用于不同模糊级别的任务,从客观指标优化到基于偏好的判断。作者分享了在查询时间优化、情感提取、研究代理等任务中的实践经验,并讨论了每个级别遇到的挑战,如指标相关性、奖励黑客和评估标准等。文章强调了清晰指标、迭代速度和人工监督的重要性。

技术 › LLM Florian Juengermann 2026-08-1517.2 KB 5.4K 39 74