Wiki 知识库

全部文档 / 作者: Sergio Paniego / 标签: 强化学习

2 篇
清除

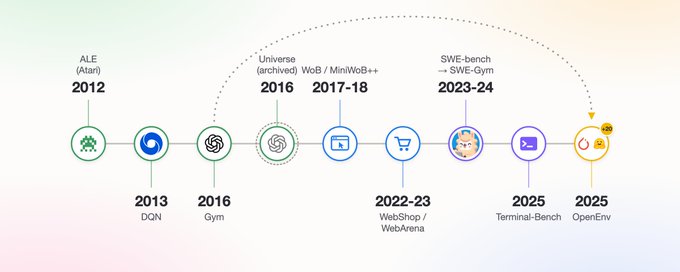
为什么 RL 环境现在可行(而 2016 年不行)

文章回顾了强化学习(RL)环境的发展历程,指出其核心思想早在 2016 年 OpenAI 发布 Universe 时就已出现,但直到十年后的今天才真正成熟。作者梳理了从 Arcade Learning Environment、DQN、OpenAI Gym 到 World of Bits、WebArena、SWE-bench、Terminal-Bench 等关键节点的演化路径,解释了环境的定义(保持状态、执行动作、返回反馈)以及'基准先出现、训练环境随后诞生'的规律。文章还探讨了基准数据污染训练集的张力,并预告了结合 TRL 与 OpenEnv 训练编程 Agent 的直播课程。
技术 › LLM Sergio Paniego 2026-09-0817.6 KB 43.2K 222 71

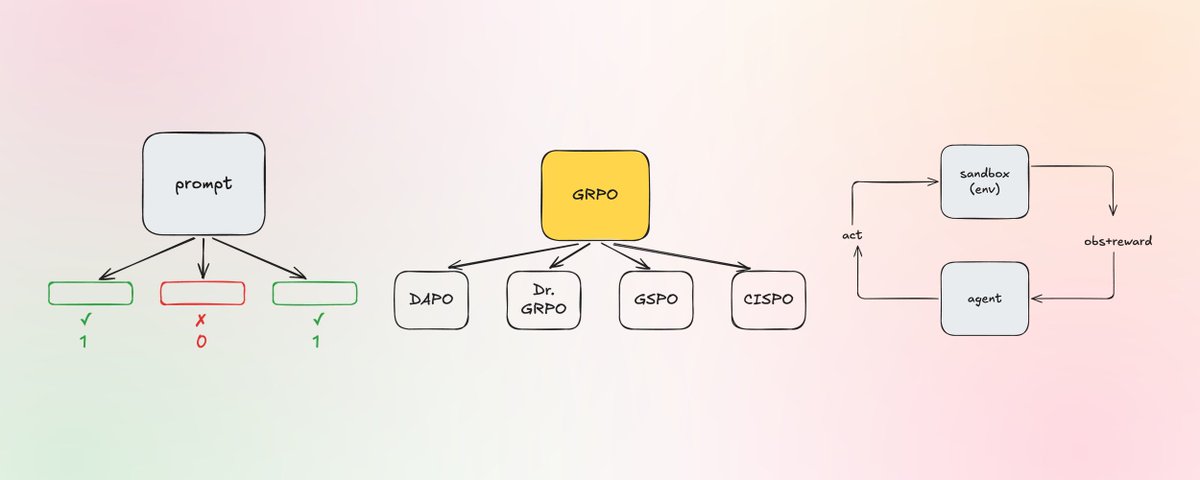
How frontier models train on outcomes in 2026

本文是《训练智能体》系列课程的补充材料,探讨了前沿实验室在2026年如何利用强化学习(RL)训练模型。文章回顾了从RLHF到RLVR的演变,指出可验证奖励已成为主流,GRPO算法衍生出多种变体,并强调了RL从单一答案向环境交互的转变。通过引用OpenAI、DeepSeek、Meta等实验室的报告,展示了这些模式的实际应用。

技术 › LLM Sergio Paniego 2026-08-1119.8 KB 31.1K 181 75