Wiki 知识库

全部文档 / 标签: RL环境

3 篇
清除

为什么 RL 环境现在可行(而 2016 年不行)

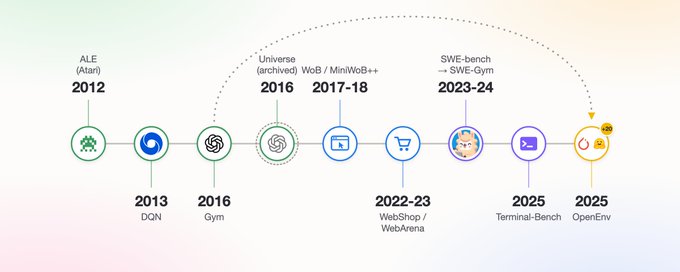
文章回顾了强化学习(RL)环境的发展历程,指出其核心思想早在 2016 年 OpenAI 发布 Universe 时就已出现,但直到十年后的今天才真正成熟。作者梳理了从 Arcade Learning Environment、DQN、OpenAI Gym 到 World of Bits、WebArena、SWE-bench、Terminal-Bench 等关键节点的演化路径,解释了环境的定义(保持状态、执行动作、返回反馈)以及'基准先出现、训练环境随后诞生'的规律。文章还探讨了基准数据污染训练集的张力,并预告了结合 TRL 与 OpenEnv 训练编程 Agent 的直播课程。
技术 › LLM Sergio Paniego 2026-09-0817.6 KB 43.2K 222 71

State of Memory in RL Environments

本文探讨了强化学习环境中记忆系统的设计问题。各实验室通过可验证奖励(如测试通过与否)在沙盒环境中训练编码智能体。单个任务往往涉及数百次工具调用,而模型只能看到上下文窗口内的内容,harness 负责决定哪些历史信息进入窗口——这就是记忆系统。文章介绍了 AgeMem、CompactionRL 等研究如何将记忆管理(压缩、检索、写入)纳入策略本身进行训练,并用任务奖励进行评分。Cursor 认为生产环境的 harness 就是训练环境,在数十万并发沙盒中训练 Composer 模型。核心观点是:沙盒保持完整状态,但策略只看到 harness 构建的观察窗口,记忆即跨越这一边界的信息。

技术 › LLM mem0 2026-08-2838.2 KB 10.4K 93 70

如何基于真实用户流量构建可扩展的长时程浏览器 RL 环境

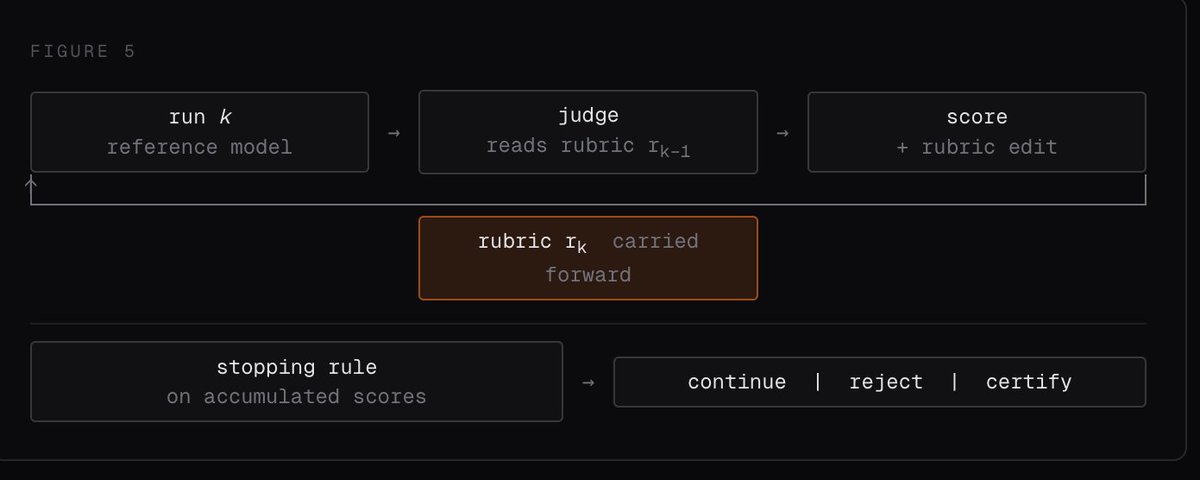
本文介绍如何从数亿条真实生产环境的浏览器代理任务流量中构建可扩展的强化学习环境。方法包括:去重与过滤不当任务、用对齐的标注代理(Gemini 3 Flash)筛选适合的任务、以标准虚拟身份替换个人数据、通过参考模型执行验证任务可行性与难度。文章还探讨了评判问题的核心思路:评分模型无需比代理更聪明,只需看到同一任务的大量尝试分布,从而构建公平稳定的奖励机制。

技术 › Agent Alexander Yue 2026-08-2718.3 KB 24.8K 93 77