Wiki 知识库

全部文档 / 标签: 推理

26 篇
清除

AI 繁荣的三张账单——电、芯片、推理

本文是硅谷101 Alignment 峰会 Day 2 上午的深度笔记,提出 AI 繁荣背后有三张物理账单:电、芯片、推理。 Session 1 指出美国输电网难以建设,行业转向表后发电,从签约到出 token 需 16-17 个月,电力成为算力交付的真正瓶颈;讨论了数据中心融资期限错配、neocloud 风险、云业务利用率本质及算力短缺将持续到 2030 年的预测。 Session 2 探讨半导体,揭示 2nm 只是名义数字、硅在 5nm 以下到物理极限,AI 进晶圆厂第一站是良率检测,价值最终流向制造端。 Session 3 讲述在买不到新卡的情况下,通过推理优化软件从现有 GPU 榨取更多性能。核心结论:三张账单的解法都是效率。

技术 › LLM Cloris 2026-10-1426.8 KB 5K 10 78

从零开始学 AI:小白也能看懂的常见 AI 术语讲解(二)

本文是 AI 术语扫盲系列第二篇,面向小白读者讲解日常使用 AI 工具时常见的功能名词。文章系统介绍了提示词工程、系统提示词、自定义指令、推理、思维链、深度思考与推理强度、问答/执行模式、计划模式、目标模式、权限与审批、上下文压缩、知识截止日期、联网搜索、深度研究和引用来源等 15 个概念。作者结合实际使用场景,用通俗语言解释每个术语的含义与作用,并分享了实用技巧,如按结果判断是否开启深度思考、利用计划模式细化需求、保存原始问答以应对上下文压缩等。

技术 › LLM 金尘马 2026-10-0516.9 KB 8.3K 68 73

Prefill & Decode made Crystal Clear

本文从第一性原理出发,逐步讲解 LLM 推理过程中 Prefill 和 Decode 两个阶段的真实含义。作者先介绍自回归模型逐 token 预测的基本机制,然后通过 ChatGPT 聊天的例子,展示文本如何经过分词、token ID、embedding 转化为 S×D 矩阵并进入 Transformer 层。重点澄清一个常见误解:处理输入 prompt 时模型并非逐个 token 顺序处理,而是因为所有输入 token 已知,可以并行处理——这一整个输入处理过程就是 Prefill。文章还引出因果掩码等问题,帮助读者建立对推理流程的正确直觉。

技术 › LLM Abhinandan 2026-10-0326.3 KB 9.2K 133 64

Disaggregated Inference From The Ground Up

本文由 Cerebras 撰写,从基础原理讲解推理系统中的分离式推理技术。文章先介绍加速器的构成(计算单元与存储),并引入算术强度概念,通过矩阵加法与矩阵乘法的实例说明数据搬运与计算的关系。随后分析 LLM 推理的两个阶段:prefill(处理整个 prompt,计算密集型)与 decode(逐 token 生成,受限于内存带宽),解释二者对硬件需求的不同。Cerebras 提出异构分离式推理,将不同类型芯片分配给不同推理阶段,在相同硬件数量下将吞吐量提升 5 倍且不损失单用户生成速度。

技术 › LLM Cerebras 2026-10-0219.6 KB 400.2K 299 70

从零手写大模型系列完结了

作者宣布「从零手写大模型」系列完结,共20篇,包括推理篇15篇和训练篇5篇。推理篇涵盖分词器、嵌入层、位置编码、自注意力机制、多头注意力、残差连接、层归一化、Transformer模块等内容;训练篇涵盖损失函数、反向传播、梯度下降、Adam优化器和学习率调度。每篇都有可练习的代码示例,帮助读者理解模型如何生成文字以及如何从误差中学习更新参数。作者强调理论公式是精华,代码多被PyTorch封装。系列笔记已发布在个人网站上,欢迎交流指正。

技术 › LLM 纳米AI (@antiAIvo) 2026-09-262.6 KB 65

某二次元 AIGC 团队 Infra 组招聘:地狱周收获与招人启事

作者介绍了其所在的二次元 AIGC 顶尖团队的 Infra Team,职责涵盖 SRE、Data Infra、推理与训练基础设施建设、安全及 AI Infra 等。团队定位为偏 Infra 的 Product Engineer,与业务深度协作,目标是让服务变得更好。作者分享了地狱周成果:完成全服务 Service Mesh 化、迁移至 Istio Gateway、搭建 1:1 测试集群并完成压测和故障演练,零事故完成机房维保。团队注重效率与沟通,反对纯 AI 生成文档,招聘 SRE、推理、研发效能三个方向的校招到 Senior 人才。

一文解密 Jev:一个不聊天的模型,为什么突然火了?

TypeSafe AI 于2026年9月发布的 Jev 是一个不做对话和内容生成的专用判断模型,主打低成本、高速度地解决软件中的小型理解判断任务,如工单分类、优先级评分和概率判断,提供 Choice、Score、Noul 三种能力。其极低价格(每百万输入token 0.042美元)和 Vercel、Netlify 的快速接入引发开发者关注。文章分析了其'零幻觉'宣传的真实含义、评测数字的适用边界,并指出 Jev 的价值在于与生成式模型、程序和人分工协作,让软件能以低成本读懂小问题。

技术 › LLM Ray Wang 2026-09-1913.2 KB 19.4K 96 78

LLM Inference After Training: Prefill, Decode, KV Cache

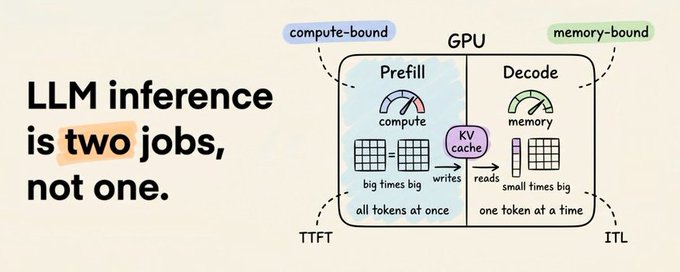
本文系统讲解 LLM 推理阶段的核心原理。作者指出推理与训练不同,分为 prefill 和 decode 两个阶段:prefill 并行处理整个提示词、计算密集型、决定首 token 延迟(TTFT);decode 逐 token 生成、受 HBM 内存带宽限制、决定 token 间延迟(ITL)。文章介绍了 GPU 关键硬件概念(Tensor Core FLOPS、HBM、SRAM),逐步演示一个请求的完整流程(分词、采样、KV cache 机制),并将 FlashAttention、PagedAttention、continuous batching、RadixAttention 等优化技术归位到这两个阶段中,帮助读者理解推理瓶颈与优化方向。

技术 › LLM Karan 2026-09-1713.8 KB 29.4K 187 83

我在 22.7B token 上从零训了一个 348M 模型,它能做 14 位加法

作者 nkthebass 从零训练了一个 348M 参数的 decoder-only 小模型 TinyBrainBot 350M V3 Math,用带纸笔(scratchpad)的竖式算术方式做计算。九项 GPT-3 算术子任务均值达 99.4%,加法干净做到 14 位,三位数乘法 98.0%。文章详细分析了首版三个缺陷的修复过程、加法天花板源于词表位名不足、减法错误集中在大小比较、应用题弱与算术高分不矛盾等发现,并分享了训练中关于联合分布控制和显式对齐步骤两个关键经验,以及 LoRA adapter 合并的意外收益。

技术 › LLM yibie 2026-09-138.4 KB 982 3 86

重新审视 CPU 资源作为语音模型 Serving 过程的一等公民

本文回顾了 SGLang Omni 项目在 CI 运行中发现的 CPU 瓶颈问题。由于语音模型推理具有短请求、高并发的特点,CPU 资源成为性能的关键瓶颈。通过实验发现,CPU 资源争用(而非核数不足)导致每个请求消耗更多 CPU 时间,从而显著降低吞吐量。文章详细分析了争用的微观机制,并提出了通过 cpuset 绑核、优化编译缓存等修复措施,最终显著提升了 CI 的稳定性与性能。

技术 › LLM Chayenne Zhao 2026-08-2028.5 KB 14.5K 67 84

Why model routing must be in the harness

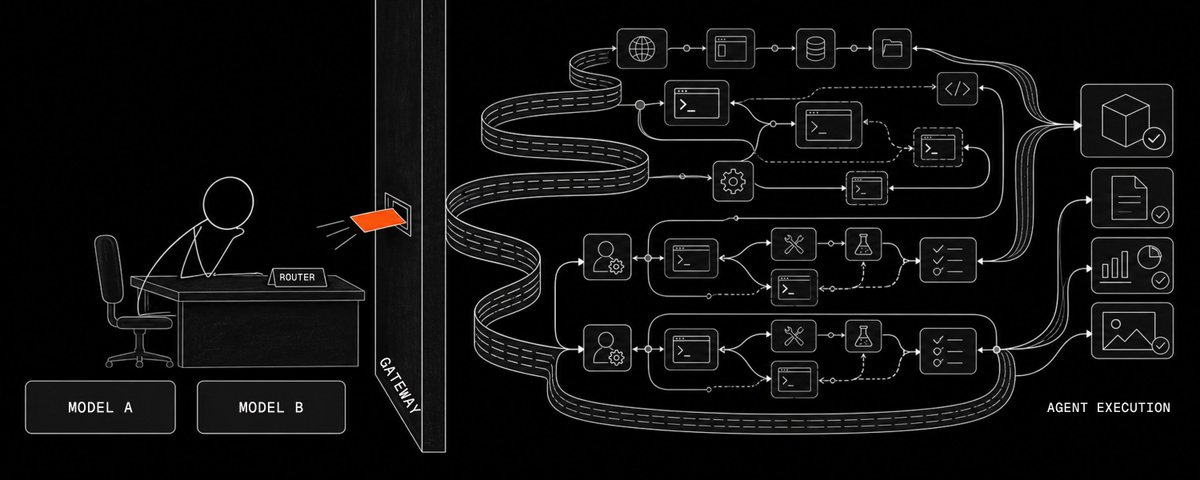
本文探讨了模型路由为何应置于代理的harness中而非网关层。随着代理部署扩大,推理成本上升,模型路由成为控制成本的关键。作者基于生产数据指出,harness层路由可降低58%成本且不损质量,因为harness能结合会话缓存、任务状态和结果来动态选择模型,而网关缺乏这些上下文。文章强调,模型切换需权衡缓存失效成本,只有harness能判断何时切换最经济。

技术 › LLM Abhay Singhal 2026-08-1514.0 KB 173.3K 349 75

How frontier models train on outcomes in 2026

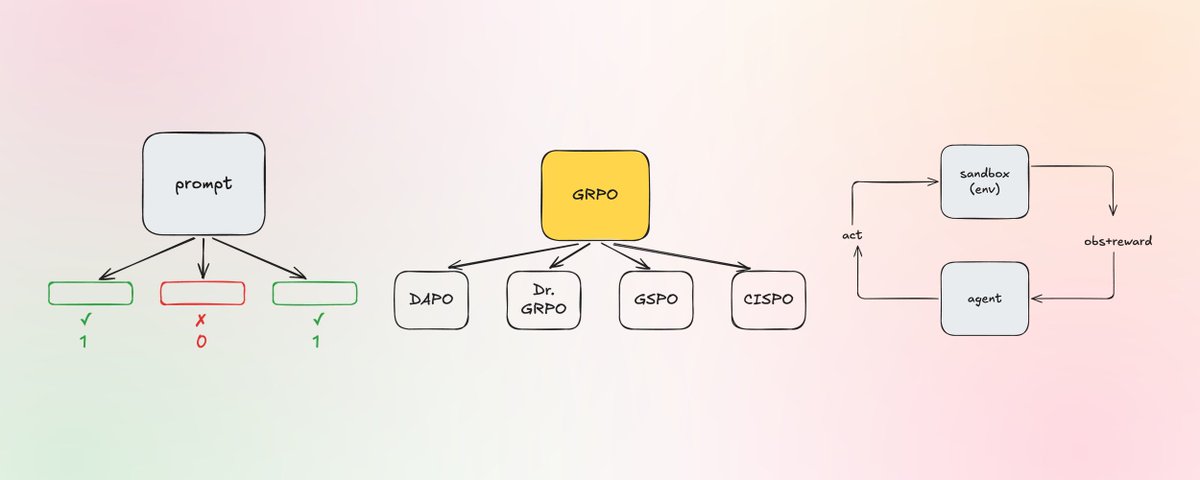
本文是《训练智能体》系列课程的补充材料,探讨了前沿实验室在2026年如何利用强化学习(RL)训练模型。文章回顾了从RLHF到RLVR的演变,指出可验证奖励已成为主流,GRPO算法衍生出多种变体,并强调了RL从单一答案向环境交互的转变。通过引用OpenAI、DeepSeek、Meta等实验室的报告,展示了这些模式的实际应用。

技术 › LLM Sergio Paniego 2026-08-1119.8 KB 31.1K 181 75

OpenAI 官方 GPT-5.6 模型指南

本文是 OpenAI GPT-5.6 模型指南的翻译,介绍了该模型的新特性如程序化工具调用、多智能体、显式提示缓存及 Pro 模式等。文章详细阐述了模型命名方案、API 参数更新、迁移策略及最佳实践,帮助开发者优化生产工作流的质量与效率。
技术 › OpenAI 雪踏乌云 2026-08-0318.1 KB 39.7K 77

LLM 推理原理详解:从 Prefill 到 Decode

本文深入解析了大语言模型(LLM)推理的计算流程。文章指出,LLM 推理主要包含 Prefill(处理提示词,计算密集型)和 Decode(逐词生成,显存带宽密集型)两个阶段。作者详细阐述了分词、Embedding、Transformer 层及 KV Cache 的工作原理,并分析了 KV Cache 带来的内存挑战及 vLLM 的优化方案。最后,探讨了 DeepSeek-V4 等新架构通过重新设计注意力机制来从根本上压缩 KV Cache 的创新思路。
技术 › LLM Avi Chawla 2026-06-2923.7 KB 320.3K 776

LLM 原理与实践指南 (2026 版)

这是一份关于大语言模型(LLM)的实践指南。文章从基础循环机制出发,详细解释了文本如何转化为 Token,以及 Transformer、注意力机制、KV Cache 和 RoPE 等核心概念的工作原理。作者强调理解模型内部的推理机制(如 Prefill 和 Decode 阶段)对于硬件选型、显存估算和本地部署的重要性。文章涵盖了 Token 化、上下文窗口、量化、模型服务及本地 AI 硬件数学计算等关键主题,旨在为深入理解 LLM 提供直观的基础。

技术 › LLM Ahmad 2026-05-23112.1 KB 457.9K 1.1K 83

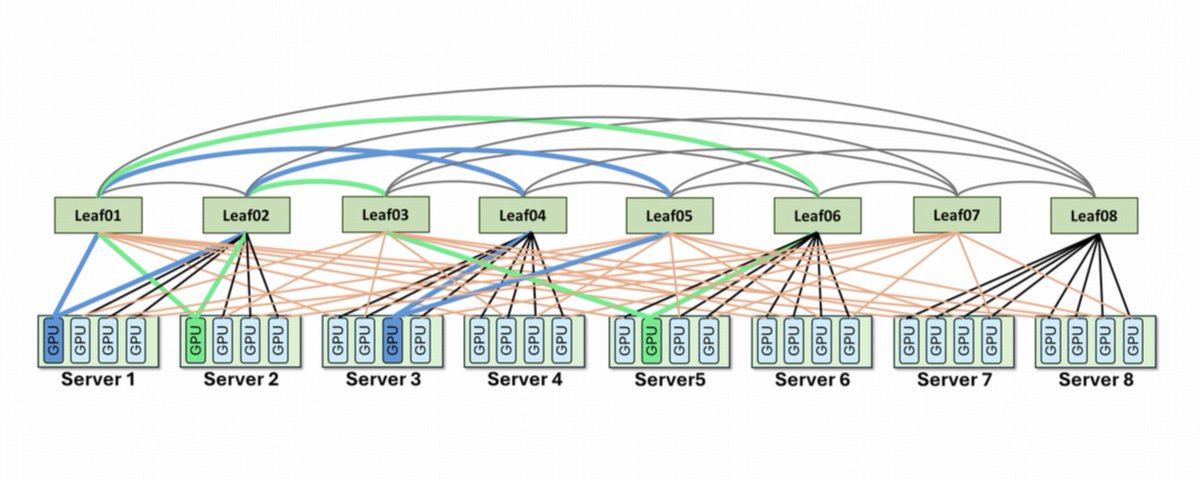
下一代 LLM 推理网络:ZCube 如何缓解网络瓶颈

文章探讨了随着长上下文推理和 Prefill-Decode 解耦成为主流,网络如何成为 LLM 推理集群吞吐量和延迟的关键瓶颈。Z.ai、Harnets.AI 和清华大学联合开发了 ZCube 网络架构,通过扁平化拓扑和混合轨道设计,有效解决了传统 ROFT 架构下的流量负载不均衡问题。生产环境基准测试显示,ZCube 仅通过架构优化便实现了交换机成本降低 33%、吞吐量提升 15% 以及 TTFT 延迟降低 40.6% 的显著收益。

技术 › DevOps Z.ai 2026-05-2134.3 KB 204.1K 926 77

LLM 优化面试笔记:训练与推理核心技术

这是一份针对 AI 实验室面试准备的笔记,涵盖了高效训练和部署大语言模型(LLM)的核心优化策略。内容主要分为三部分:内存优化(如 Flash Attention、MQA/GQA、激活检查点)、计算优化(序列打包、高效变体 Transformer)以及推理优化(KV 缓存、投机解码、量化技术)。文章旨在总结在大规模模型开发中应对算力和内存瓶颈的关键技术。

技术 › LLM Gauri Gupta 2026-05-0654.2 KB 305K 758 65

英伟达推理份额大降,AI革命进入二阶段机会在哪?

文章深入分析了 AI 从训练时代进入推理时代的投资机遇。随着推理成本占比提升至 80%-90%,算力需求呈几何级增长,但英伟达在推理市场的份额已下滑至 60-75%。AMD 凭借大显存优势及 OpenAI 等巨头的订单,正在抢占市场。ASIC 定制芯片也成新势力。文章对比了英伟达与 AMD的投资逻辑:英伟达仍是行业 beta,而 AMD 是份额转移的直接受益者。

投资 › 股票 大宇 2026-05-0457.7 KB 49.1K 170 93

光互联深度:当算力撞上物理边界,人类又一次问光

文章深入探讨了 AI 时代算力发展面临的物理瓶颈,指出光互联是解决 GPU 之间、机柜之间高速通信的关键路径。随着 AI 进入推理时代,大模型长上下文和 Agent 任务对带宽和延迟提出了极高要求,英伟达的 NVLink 协议虽然建立了深厚护城河,但铜缆技术已达极限,产业正加速向光互连(如 CPO、硅光子)转型。文中还详细对比了 Scale-up 与 Scale-out 架构,以及 UALink 开放联盟对英伟达的挑战。

投资 › 宏观产业 大宇 2026-05-0448.0 KB 14.5K 41 85

HBM全景研报:从训练到推理,主角不再是GPU

本文深入分析了AI推理时代HBM(高带宽内存)成为新主角的原因,指出推理过程中数据搬运的耗时往往超过计算。文章详细解释了HBM的3D堆叠技术优势、HBM4采用先进逻辑工艺带来的产业链变化,以及SK海力士、三星、美光三大厂商的市场份额与技术路线竞争,并探讨了内存厂商在AI基础设施中获取超高利润的商业逻辑。

投资 › 宏观经济 大宇 2026-05-0457.8 KB 285.8K 419 92

万物互联:深入理解知识图谱

文章通过形象的人类联想记忆引入,阐述了知识图谱如何解决传统关系型数据库在处理复杂、多跳关系时的局限性。详细介绍了知识图谱的核心构成(节点、边、属性)及本体概念,展示了其在城市关系建模和推理中的强大能力。最后对比了不同数据模型,指出知识图谱在关系复杂度极高的场景下具有独特优势。

技术 › 后端 ramakrushna 2026-04-1223.1 KB 34.6K 343 71