Wiki 知识库

全部文档 / 标签: 训练

6 篇
清除

我对system prompt的理解(nanobot)

文章从训练角度剖析 system prompt 为何能影响模型行为。作者以 nanobot 的 SOUL.md 为切入点,梳理了 OpenAI Instruction Hierarchy(训练模型处理指令冲突,拒绝率提升至92.6%)、Llama 2 的 Ghost Attention(多轮指令保持)、Anthropic 的 character training 与《Teaching Claude Why》(角色与原则内化)、Deliberative Alignment(规则通过训练学习)、The Assistant Axis(角色行为的内部激活证据)等研究,说明 prompt 中一句指令的效果取决于上下文与模型已学到的能力。最后建议:先用少量指令说清目标,根据失败案例迭代,随模型演进精简 prompt,把通用能力交给模型本身。
技术 › LLM chengyongru 2026-09-2818.5 KB 7.9K 59 78

从零手写大模型系列完结了

作者宣布「从零手写大模型」系列完结,共20篇,包括推理篇15篇和训练篇5篇。推理篇涵盖分词器、嵌入层、位置编码、自注意力机制、多头注意力、残差连接、层归一化、Transformer模块等内容;训练篇涵盖损失函数、反向传播、梯度下降、Adam优化器和学习率调度。每篇都有可练习的代码示例,帮助读者理解模型如何生成文字以及如何从误差中学习更新参数。作者强调理论公式是精华,代码多被PyTorch封装。系列笔记已发布在个人网站上,欢迎交流指正。

技术 › LLM 纳米AI (@antiAIvo) 2026-09-262.6 KB 65

大模型微调实操教程:手把手带你训练人物LoRA

本文是一篇面向零基础读者的大模型微调实操教程,作者详细演示了如何在云端租用RTX 4090显卡,使用LoRA技术对SDXL图像生成模型进行人物微调。教程涵盖数据集准备(用IP-Adapter生成24张训练图并配描述)、训练环境搭建、20步冒烟测试、1200步正式训练、不同checkpoint的对照评测及成果保存与重新加载等完整流程。整轮实验仅花费2.71元、约78分钟,最终得到可复用的人物LoRA权重,可稳定生成不同造型、场景下的同一人物写真。

技术 › LLM 静静学AI 2026-09-0717.8 KB 32.6K 61 85

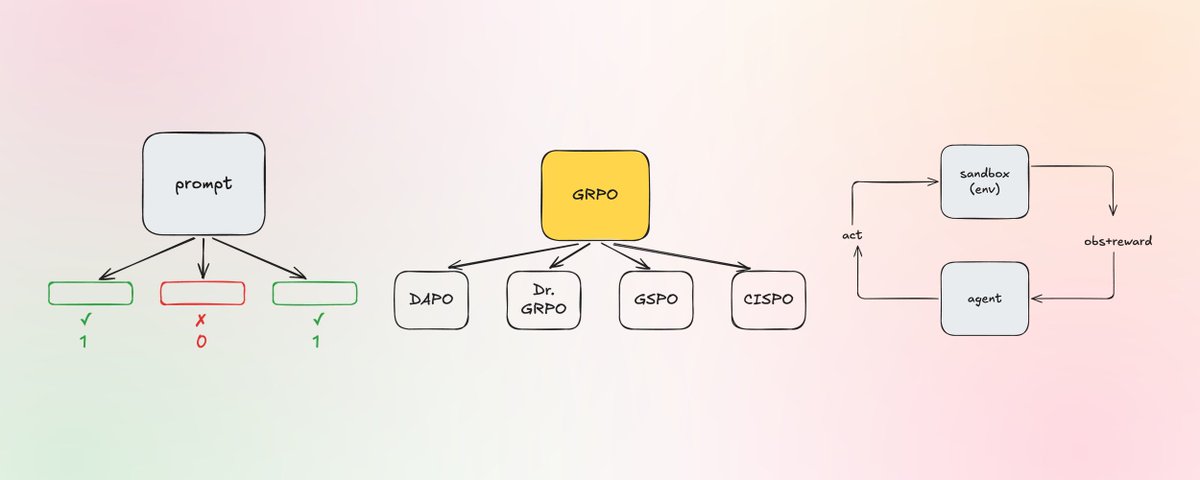
How frontier models train on outcomes in 2026

本文是《训练智能体》系列课程的补充材料,探讨了前沿实验室在2026年如何利用强化学习(RL)训练模型。文章回顾了从RLHF到RLVR的演变,指出可验证奖励已成为主流,GRPO算法衍生出多种变体,并强调了RL从单一答案向环境交互的转变。通过引用OpenAI、DeepSeek、Meta等实验室的报告,展示了这些模式的实际应用。

技术 › LLM Sergio Paniego 2026-08-1119.8 KB 31.1K 181 75

LLM 优化面试笔记:训练与推理核心技术

这是一份针对 AI 实验室面试准备的笔记,涵盖了高效训练和部署大语言模型(LLM)的核心优化策略。内容主要分为三部分:内存优化(如 Flash Attention、MQA/GQA、激活检查点)、计算优化(序列打包、高效变体 Transformer)以及推理优化(KV 缓存、投机解码、量化技术)。文章旨在总结在大规模模型开发中应对算力和内存瓶颈的关键技术。

技术 › LLM Gauri Gupta 2026-05-0654.2 KB 305K 758 65

可视化训练的科学原理:为何过程比结果重要

文章探讨了可视化训练背后的神经科学原理。作者指出,大脑无法完全区分生动的想象与现实经历,单纯的“结果可视化”(如想象成功)会降低大脑的多巴胺需求,从而削弱行动力;而“过程可视化”(如想象具体行动步骤)则能起到免费练习的作用。文章通过哈佛钢琴实验和克利夫兰诊所的力量训练研究证明了心理训练的生理效应,并结合 Michael Phelps 的案例,说明了预演每一个细节甚至突发状况对于顶尖表现的重要性。

生活 › 方法论 Jaynit 2026-04-1816.3 KB 2.2M 1.9K 83