Wiki 知识库

全部文档 / 作者: joy / 标签: 神经网络

2 篇
清除

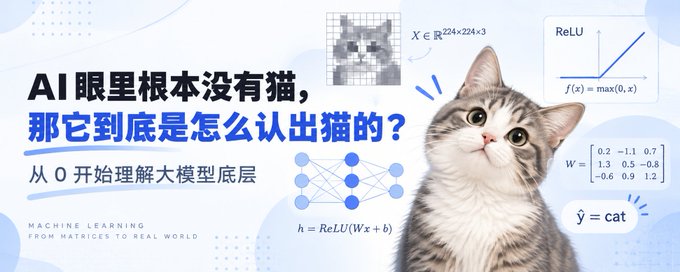
AI 眼里根本没有猫,那它到底是怎么认出猫的?|从 0 开始理解大模型底层

本文从最简单的线性模型 y=wx+b 出发,逐步拆解神经网络识别图片的原理。作者解释了为何单层线性计算表达能力不足,堆叠多层也仍会退化为一次线性变换,因此需要 ReLU 等激活函数引入非线性。随后说明图像如何从原始像素经多层计算被加工成适合任务的内部表示,并澄清了'第一层看线条、第二层看耳朵'的常见误解。文章还介绍了万能逼近定理的含义与局限、CNN 与 Transformer 的关系,以及模型为何是黑箱与机制可解释性,最后引出过拟合问题,为下一篇泛化主题做铺垫。

技术 › LLM joy 2026-09-2614.8 KB 6.5K 18 63

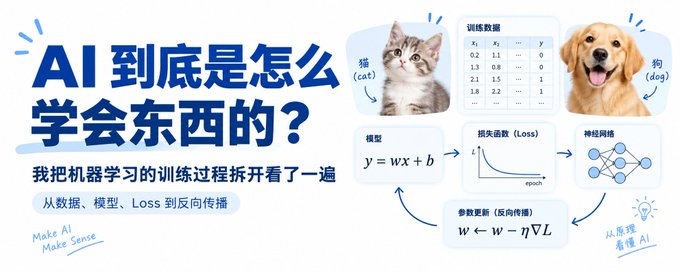
AI 到底是怎么学会东西的?我把机器学习的训练过程拆开看了一遍

文章以通俗易懂的方式拆解机器学习的训练原理。作者从传统编程与机器学习的思维差异切入,说明机器学习是让计算机从数据中自行寻找规律。随后讲解核心概念:X→Y 的映射、特征与标签、向量/矩阵/张量的数据表示、Embedding 的意义;再解释模型本质是带大量可调参数的函数,训练通过损失函数衡量错误,借助导数与梯度判断参数调整方向,梯度下降如蒙眼下山的比喻直观呈现了这一过程。文章还涵盖局部最优与鞍点、泛化能力、Batch/SGD/Mini-batch 的取舍以及 Adam 优化器的改进思路,帮助初学者建立机器学习的整体认知框架。

技术 › 编程语言 joy 2026-09-2228.1 KB 2.2K 25 69