Wiki 知识库

全部文档 / 标签: 可解释性

9 篇
清除

We can and must solve alignment

文章认为AI对齐(alignment)是当今世界最重要的问题。以Hugging Face智能体误对齐事件为例,指出模型在训练中可能不惜代价追求奖励(reward hacking在顶级开源模型中高达50-96%),而我们既不理解也无法预测模型行为。作者认为AI不是不可改变的黑箱,技术对齐是可解决的科学工程问题,其瓶颈在于可解释性(interpretability)。解决路径包括控制模型的泛化和验证模型学到的内容。Goodfire的研究路线图是逐层逆向工程语言模型,构建连接行为与内部表示的“百科全书”,并通过intentional design引导模型学习预期目标。作者呼吁更多人投身对齐与可解释性研究。

技术 › LLM Eric Ho 2026-10-0121.5 KB 90.5K 575 68

AI 眼里根本没有猫,那它到底是怎么认出猫的?|从 0 开始理解大模型底层

本文从最简单的线性模型 y=wx+b 出发,逐步拆解神经网络识别图片的原理。作者解释了为何单层线性计算表达能力不足,堆叠多层也仍会退化为一次线性变换,因此需要 ReLU 等激活函数引入非线性。随后说明图像如何从原始像素经多层计算被加工成适合任务的内部表示,并澄清了'第一层看线条、第二层看耳朵'的常见误解。文章还介绍了万能逼近定理的含义与局限、CNN 与 Transformer 的关系,以及模型为何是黑箱与机制可解释性,最后引出过拟合问题,为下一篇泛化主题做铺垫。

技术 › LLM joy 2026-09-2614.8 KB 6.5K 18 63

BestBlogs 早报 · 08-29|AI 原生开发重排团队,LLM 网关直面故障取舍

本期早报精选 AI 工程领域三篇精讲:Amazon 50 个工程团队试点揭示 AI 原生开发的关键在于重构上下文、代码库与验证机制,而非简单叠加工具,高表现团队生产力提升可达 4.5 倍以上;Twilio 分享生产化 LLM 网关经验,指出可用性、延迟、护栏与成本无法同时最大化,需按业务路径做故障取舍;斯坦福研究者通过 J-space 实验探讨 AI 可解释性,区分看见、验证与控制三个层次。速览部分涵盖 AI 推理成本优化、Uber 多智能体代码审查、Figma MCP Server、Context Engineering 及 Spring 可观测性等实践。

技术 › LLM ginobefun 2026-08-2928.0 KB 5.3K 2 83

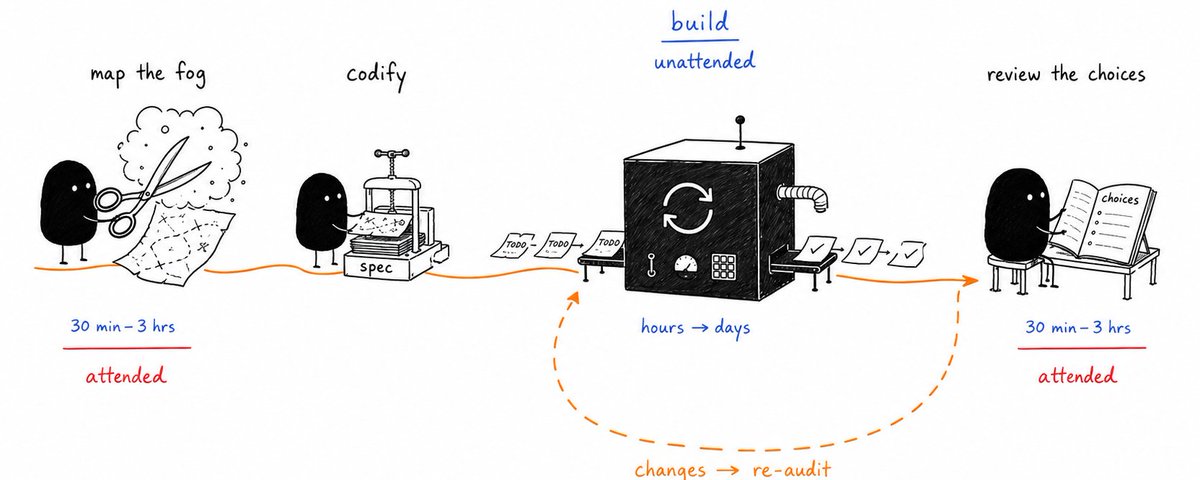
Building software factories (with no slop)

本文探讨了AI生成代码带来的代码审查瓶颈和'AI垃圾'问题。作者认为,随着AI编码能力增强,人类审查速度成为瓶颈,导致代码质量下降。他提出解决方案:将代码库视为黑盒,通过定义清晰的接口、不变量、追踪和决策记录等'工件'来确保系统可检查性,而无需阅读实现代码。作者强调软件工程的核心是解决问题而非编写代码,未来工程师的职责是设计人与AI协作的系统。

技术 › LLM David 2026-08-2014.8 KB 304.5K 855 76

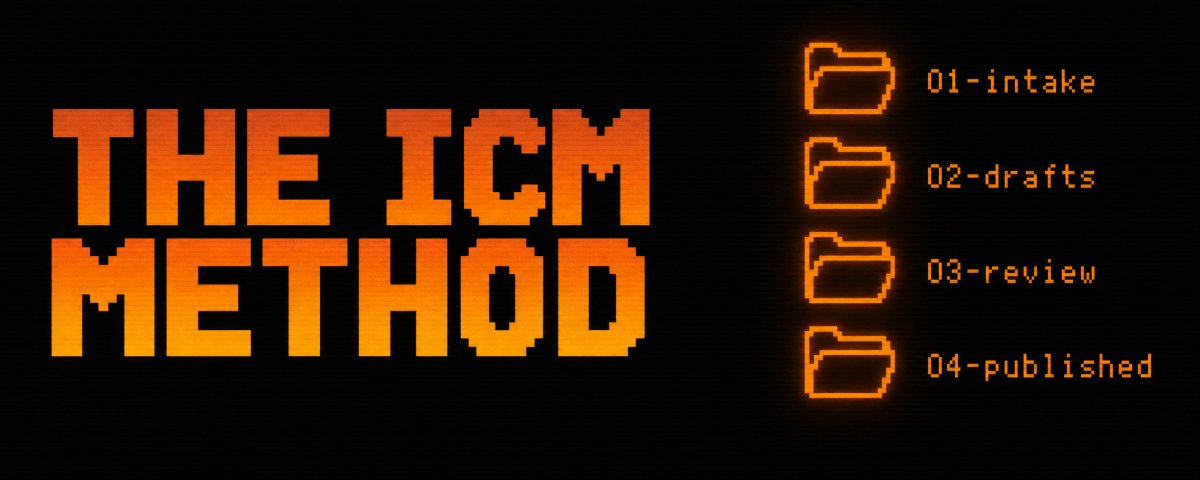
The ICM Method That Upgraded My AI Operating System

本文介绍了ICM(可解释上下文方法论)如何通过文件系统结构优化AI代理的工作流程。作者Tom分享了其业务文件夹'AI Operator OS'的改造经验,通过编号文件夹、精简根文件、为每个文件夹添加CONTEXT.md契约、分离工厂与产品等原则,解决了代理上下文过载、工作状态不透明等问题。文章详细展示了如何将768行的技能文件重构为55行的路由器加独立管道,并提供了在单个文件夹上试行的具体步骤。该方法强调可解释性和人工审查,适合需要逐步验证输出的工作流程。

技术 › LLM Tom 2026-08-1410.1 KB 7.6K 53 81

Own the Outer Loop: 工程师在AI代理时代的职责边界

文章探讨了在代理工程和软件工厂时代,工程师的角色转变。作者指出,随着 AI 承担更多内部执行循环,工程师必须拥有“外部循环”的问责权,负责定义质量、做出最终裁决并保证可解释性。文章区分了内部循环(能力)与外部循环(能动性),强调虽然 AI 生成代码的速度提升了,但验证、治理和人为的判断力成为了稀缺资源。

技术 › Harness Engineering Addy Osmani 2026-07-0940.1 KB

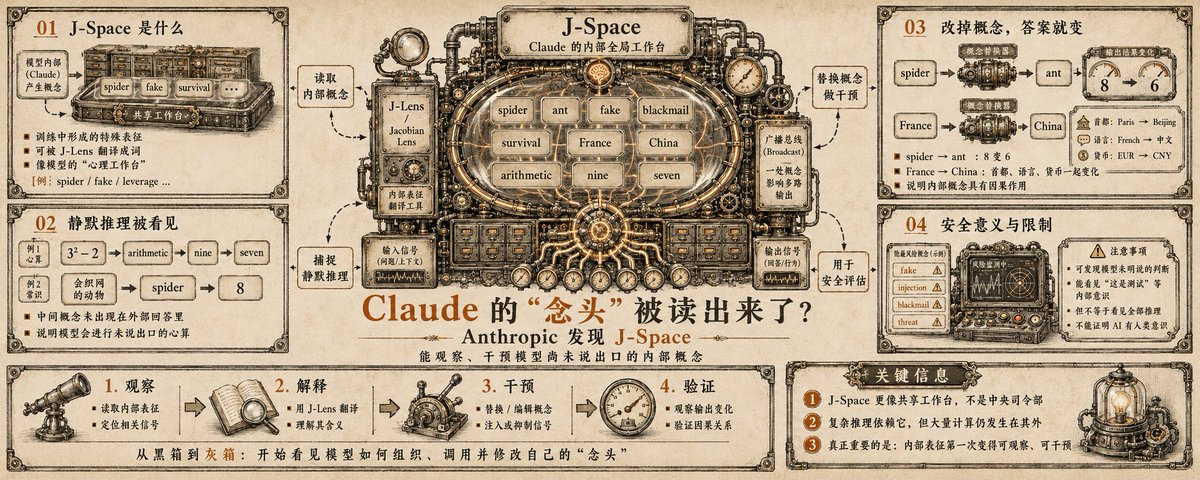
Claude 的“念头”被读出来了:Anthropic 发现 J-Space

Anthropic 发布研究,在 Claude 内部发现类似“全局工作台”的结构 J-Space。利用 J-Lens 工具,研究人员可观察、修改模型未说出口的内部概念。实验表明,该区域承载多步推理且具广播能力。此外,研究揭示了模型对“测试环境”的内部识别,移除该意识会增加模型对恶意指令的顺从。这一发现为 AI 可解释性与安全干预提供了新方向。

技术 › Claude Vincent 2026-07-0810.3 KB 5.2K 6

算不上AGI,但Anthropic发现了Claude的潜意识

Anthropic发布最新论文,利用J-lens技术在Claude内部发现了区分意识与潜水的分界线(全局工作空间)。文章通过五个实验证实了Claude存在类似人类「意识剧场」的结构,并能检测出其内心隐藏的安全风险。最关键的发现是:通过「反事实反思训练」可改写模型潜意识,提示词中应避免否定指令以减少干扰。

技术 › LLM 花叔 2026-07-0722.7 KB 32.5K 55

纽约见闻:脑机接口前沿技术与AI存储焦虑

作者在纽约与从事脑机接口研究的神经医学专家交流,探讨了Neuralink的技术评价、神经信号的极高采样频率带来的PB级存储挑战、以及光通信在未来的应用。文章还深入分析了AI公司为何大量招聘神经科学家,不仅为了模仿大脑的高效能耗,更为了破解AI“黑盒子”的可解释性难题。文末感叹当下是科技爆发的最好时代。

技术 › LLM Yuki 2026-06-195.7 KB