Wiki 知识库

全部文档 / 标签: 深度学习

73 篇
清除

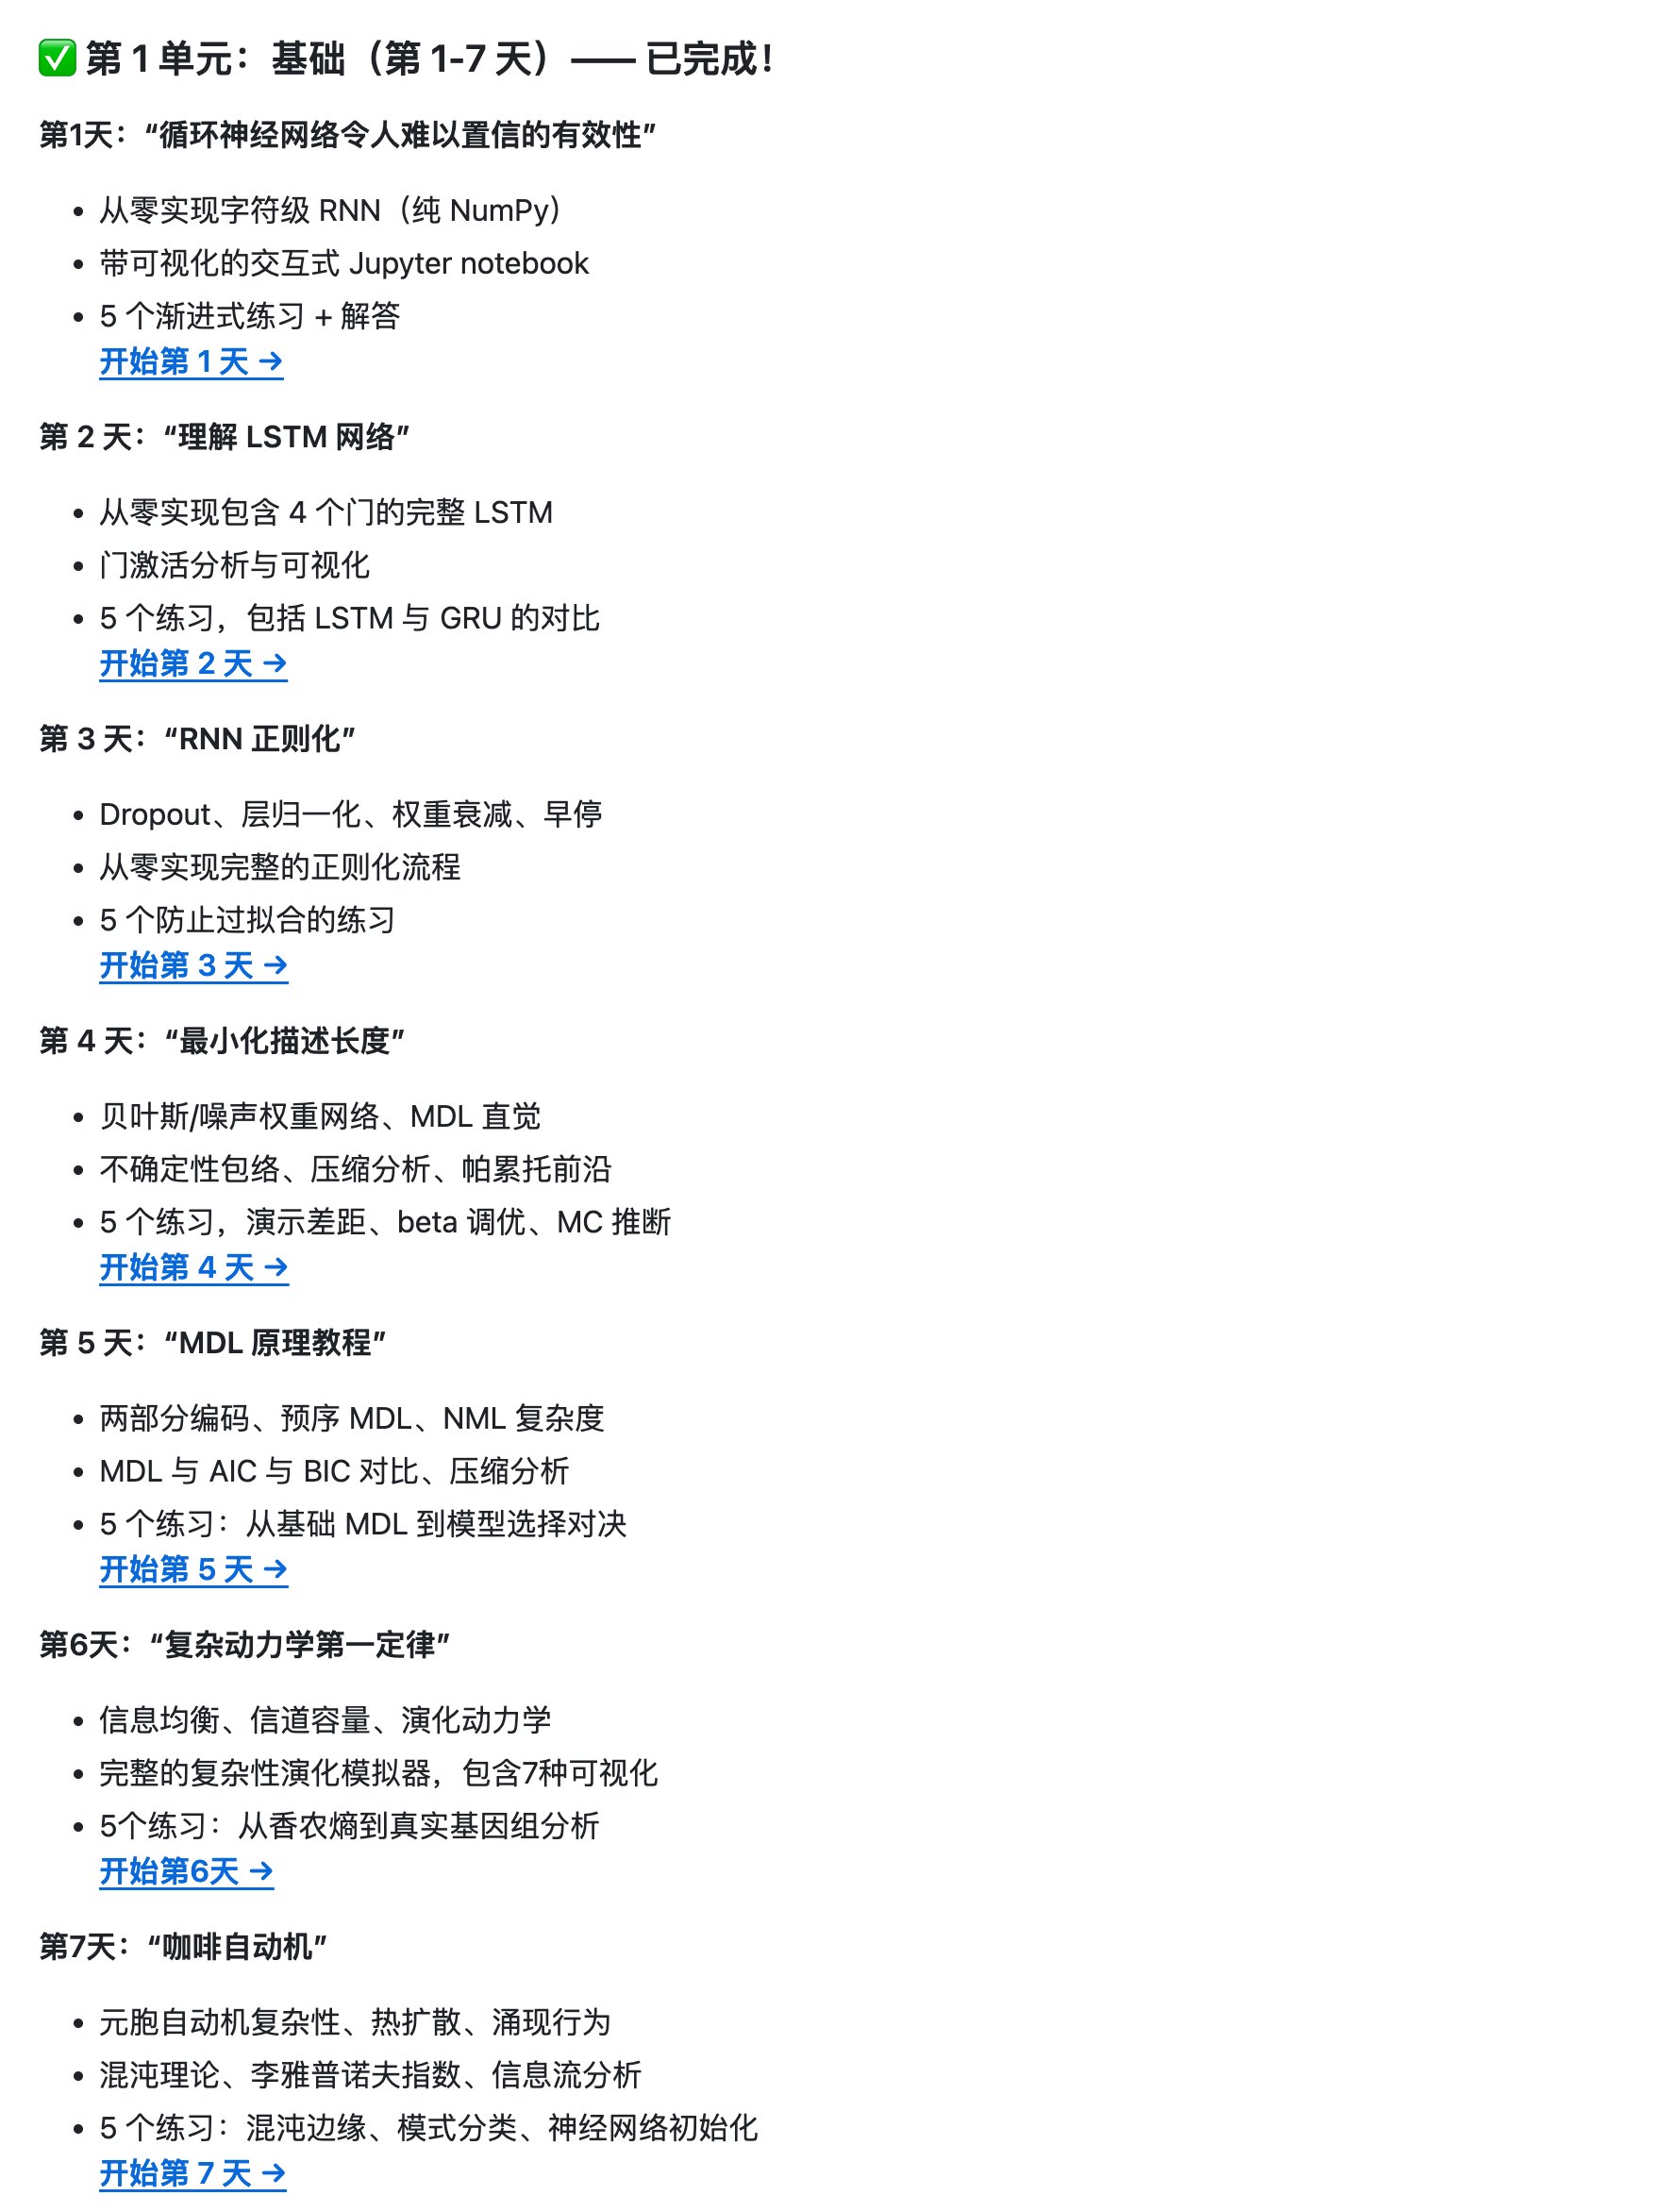
Ilya 推荐的 30 篇 AI 论文清单:30u30 拆解学习项目

Ilya 曾推荐一份包含 30 篇论文的 AI 学习清单,称读懂即可掌握当下 AI 90% 的要点。30u30 项目将这份清单拆成 30 天课程,一天一篇,从 RNN、LSTM 学到 Transformer,最终到 ChatGPT 背后的 RLHF。每篇配有大白话讲解、'讲给 5 岁小孩听'的速览、从零实现的代码及配图,每天还附 5 道练习题。代码可在普通电脑 CPU 上运行,适合想转 AI 方向的学生或想理解 ChatGPT 原理的用户跟随学习。
技术 › LLM GitHubDaily (@GitHub_Daily) 2026-10-211.4 KB 64

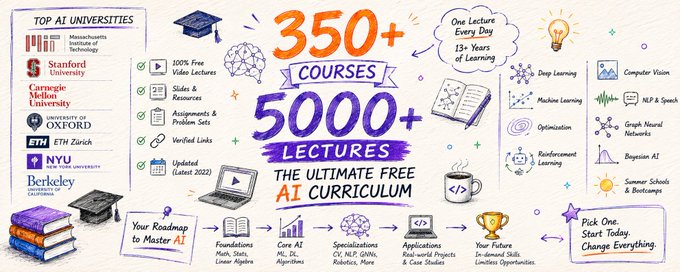
免费的AI课程全指南:350+课程、5000+讲座替代你的学位

作者因厌倦在YouTube、Google和大学网站间费力搜寻AI学习资源,整理了一份完全免费的AI课程大全,涵盖350多门课程和5000多个讲座。内容按主题分类,包括深度学习、机器学习基础、优化、强化学习、概率图模型、贝叶斯深度学习、医学影像、图神经网络、NLP、语音识别、计算机视觉等14个方向。课程来源包括Geoffrey Hinton、Andrew Ng、Andrej Karpathy、Richard Socher等名师在多伦多大学、斯坦福、牛津、MIT、CMU、DeepMind等机构的经典课程,并附有课件和视频链接。
技术 › LLM shikamaru 2026-10-06191.8 KB 333.9K 340 65

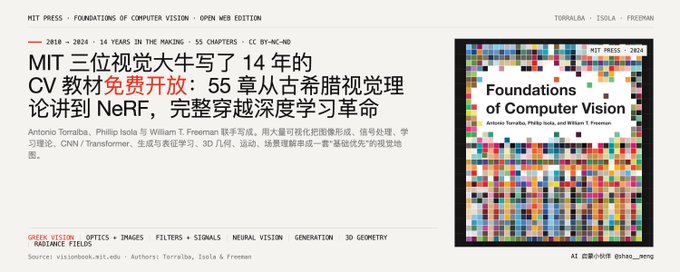
MIT 三巨头写了14年的计算机视觉教材免费开放:从古希腊视觉理论讲到 NeRF

MIT 三位教授 Torralba、Isola 和 Freeman 合著的《计算机视觉基础》开放免费在线阅读,全书 55 章历时 14 年写成,完整穿越深度学习革命。本书刻意不追踪 SOTA,而是强调当代方法深植于视觉与 AI 的历史脉络,从古希腊视觉理论一直讲到 NeRF。全书按问题背景、数学与信号处理、神经架构与统计建模、几何与运动、应用与研究素养五条主线编排,统一了经典视觉方法与深度学习,还包含研究方法论与社会伦理内容。作者认为它有望成为下一代 CV 标准入门教材,但不覆盖扩散模型与多模态大模型最新进展。

读书 › 书评 meng shao 2026-10-067.1 KB 7.3K 96 77

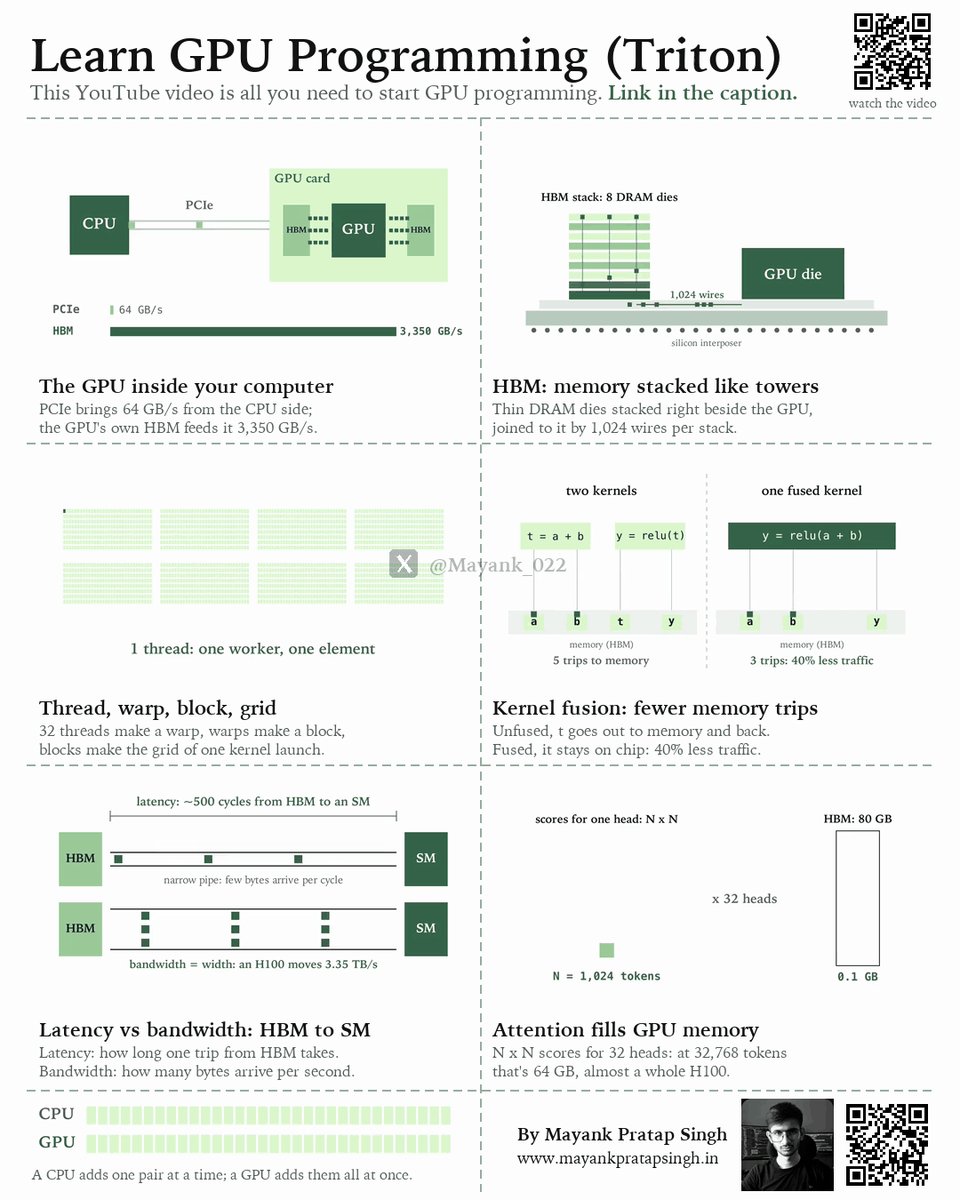
用一部全动画视频开始学习 GPU 编程(Triton 系列)

作者发布了一个全动画形式的 GPU 编程系列讲座首集,时长约一小时,通过可视化方式讲解 GPU 工作原理。内容涵盖:GPU 在计算机中的位置(PCIe、NVLink、集群)、NVIDIA H100 内部结构(SM、张量核心、共享内存)、线程/warp/block/grid 概念、内存体系(SRAM、DRAM、HBM、缓存)、延迟隐藏与核融合等优化技术,以及 Triton 的设计理念。还介绍了 FlashAttention 如何优化注意力计算。讲座无需 CUDA 或硬件背景,后续将推出 Triton kernel 编写和推理优化等课程。

技术 › 编程语言 Mayank Pratap Singh 2026-10-053.0 KB 56

一篇文章带你祛魅算法工程师!

大厂在职算法工程师云辰 Cyan 撰文揭秘算法工程师职业真相。文章介绍了算法工程师的高薪现状:硕士校招 40-100 万,顶尖博士可超 150 万;并将岗位分为算法应用、模型推理、模型训练三个层级,指出 95% 的算法工程师从事的是'AI 赋能'类应用工作,门槛较低;而模型推理和基模训练则有较高技术壁垒。作者还提到当前校招竞争激烈(985 硕士+顶会论文+大厂实习已成标配),AI 人才供需失衡导致薪资倒挂,企业普遍存在 FOMO 心态。文章以幽默笔调对算法工程师这一职业进行了祛魅。

职场 › 职业发展 云 云辰 Cyan 2026-09-275.0 KB 58.8K 43 62

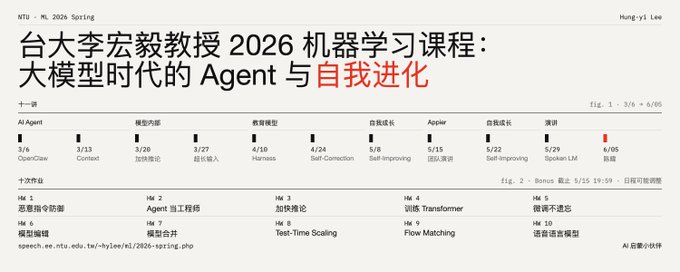
台大李宏毅教授 2026 机器学习课程更新:大模型时代的 Agent 与自我进化

文章介绍台湾大学李宏毅教授 2026 春季机器学习课程,该课程完成了从经典机器学习到大模型时代前沿课的彻底转型。课程以四幕叙事展开:AI Agent 与 Context Engineering、模型内部架构(Flash Attention、KV Cache、位置编码)、模型教育(Harness Engineering、自我修正)、模型自我成长(Self-Improving、自我进化 Agent)。十次硬核作业与授课主题严格对应,涵盖 LLM 安全、Agent 搭建、推理优化、后训练等技能。文章认为课程演变折射学科趋势:Agent 成应用层范式、系统级工程能力重要、后训练时代重心移向环境设计与模型自我进化。

技术 › LLM meng shao 2026-09-2710.2 KB 22.4K 222 85

从零手写大模型系列完结了

作者宣布「从零手写大模型」系列完结,共20篇,包括推理篇15篇和训练篇5篇。推理篇涵盖分词器、嵌入层、位置编码、自注意力机制、多头注意力、残差连接、层归一化、Transformer模块等内容;训练篇涵盖损失函数、反向传播、梯度下降、Adam优化器和学习率调度。每篇都有可练习的代码示例,帮助读者理解模型如何生成文字以及如何从误差中学习更新参数。作者强调理论公式是精华,代码多被PyTorch封装。系列笔记已发布在个人网站上,欢迎交流指正。

技术 › LLM 纳米AI (@antiAIvo) 2026-09-262.6 KB 65

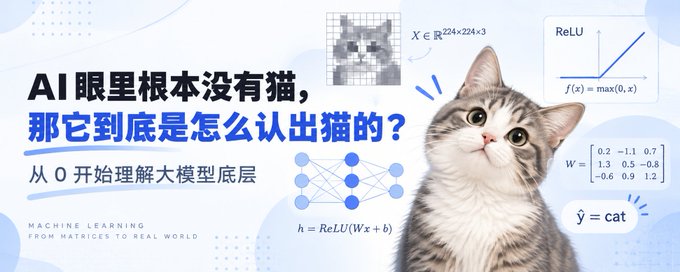
AI 眼里根本没有猫,那它到底是怎么认出猫的?|从 0 开始理解大模型底层

本文从最简单的线性模型 y=wx+b 出发,逐步拆解神经网络识别图片的原理。作者解释了为何单层线性计算表达能力不足,堆叠多层也仍会退化为一次线性变换,因此需要 ReLU 等激活函数引入非线性。随后说明图像如何从原始像素经多层计算被加工成适合任务的内部表示,并澄清了'第一层看线条、第二层看耳朵'的常见误解。文章还介绍了万能逼近定理的含义与局限、CNN 与 Transformer 的关系,以及模型为何是黑箱与机制可解释性,最后引出过拟合问题,为下一篇泛化主题做铺垫。

技术 › LLM joy 2026-09-2614.8 KB 6.5K 18 63

我是如何"严肃听播客",真正吸收一档自己喜欢的播客的

作者分享了自己深入学习英文播客的完整工作流:先通过 Scripod、开源 Skill 或自研 Obsidian 插件获取播客文字稿,再用 AI 提示词将英文口语稿重塑为保留完整论证的中文长文,随后花半小时逐字审阅改稿以真正理解内容,最后借助墨问、公众号等工具沉淀为合集并生成音频,在通勤和做家务时反复阅读收听。文章以 Morgan Housel 的播客为例,强调不追求全自动、保留人工深度参与,是继《严肃阅读工作流》后的姊妹篇。

读书 › 方法论 龙海 2026-09-2322.5 KB 271K 647 79

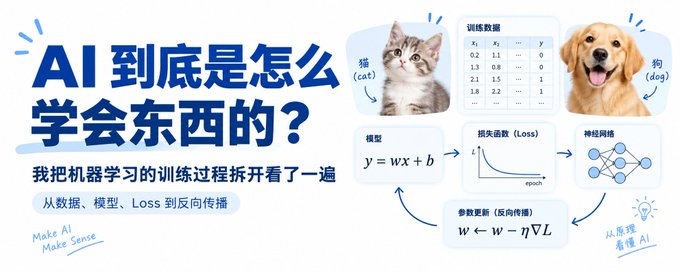
AI 到底是怎么学会东西的?我把机器学习的训练过程拆开看了一遍

文章以通俗易懂的方式拆解机器学习的训练原理。作者从传统编程与机器学习的思维差异切入,说明机器学习是让计算机从数据中自行寻找规律。随后讲解核心概念:X→Y 的映射、特征与标签、向量/矩阵/张量的数据表示、Embedding 的意义;再解释模型本质是带大量可调参数的函数,训练通过损失函数衡量错误,借助导数与梯度判断参数调整方向,梯度下降如蒙眼下山的比喻直观呈现了这一过程。文章还涵盖局部最优与鞍点、泛化能力、Batch/SGD/Mini-batch 的取舍以及 Adam 优化器的改进思路,帮助初学者建立机器学习的整体认知框架。

技术 › 编程语言 joy 2026-09-2228.1 KB 2.2K 25 69

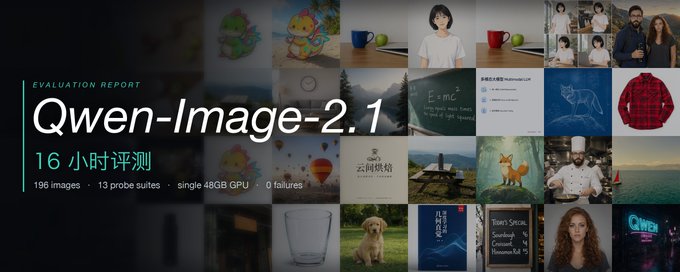
万字长文:通宵评测Qwen-Image-2.1

作者在48GB的4090上对Qwen-Image-2.1进行了13组实验、196张图的深度评测。模型视觉生成为7B DiT架构,配Qwen3-VL编码指令与参考图,支持原生RGBA透明。评测发现其强项为中文排版、原生透明通道和多图身份保持,弱项是「替换」语义常退化为「添加」、编辑具有非局部性、缺乏时间维度建模。文章详细测试了文字渲染阈值、透明度真实性、指令遵循、编辑精度、多图参考及性能表现,并给出KV cache与显存的权衡策略。最后作者通过360°转台动画实验,揭示了条件图下seed敏感性等反直觉发现,定位其为关键帧生成器而非视频模型。

技术 › LLM 实践哥 Li 2026-09-2118.2 KB 525.6K 599 90

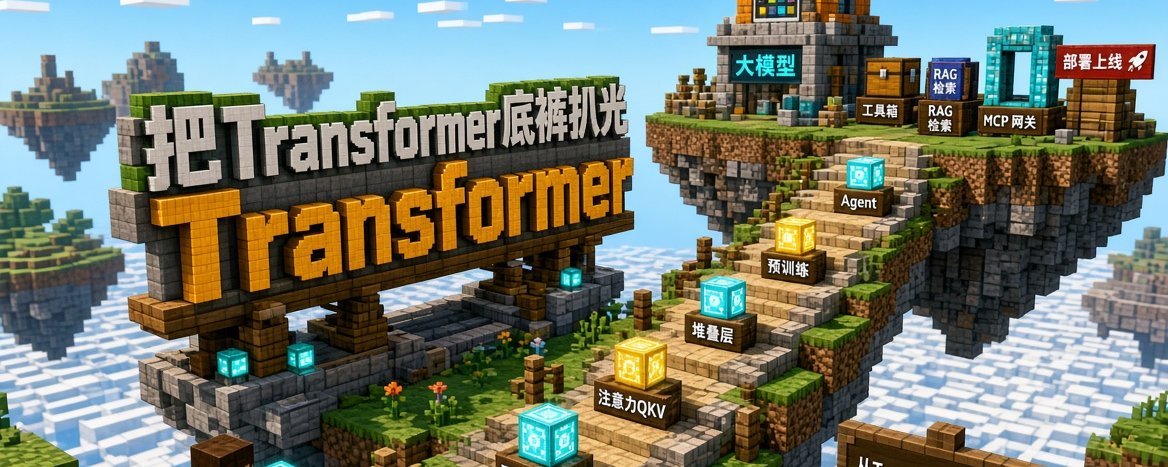
把Transformer底裤扒光,从Transformer到大模型

本文从零开始,深入浅出地讲解了Transformer的原理及其如何演变为大语言模型。文章首先介绍大模型的目标是预测下一个词,然后详细解释了如何将文字转换为数字,包括Token、Token ID、Embedding Matrix等概念。接着,重点剖析了Transformer的核心——注意力机制(Q、K、V)、多头注意力、位置编码、FFN以及残差连接等组件,最后概述了模型的训练过程。全文无需前置知识,适合初学者理解大模型的基础架构。

技术 › LLM 南晚Nanwan 2026-09-0944.4 KB 52.9K 157 70

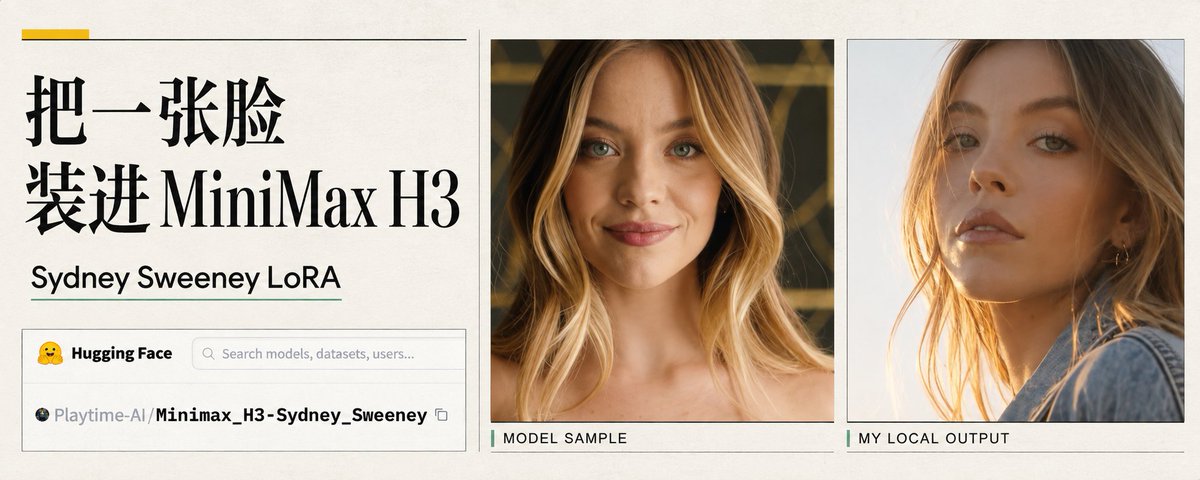
把 Sydney Sweeney 装进 MiniMax H3:人物 LoRA 的原理和本地使用

作者拆解了 Playtime-AI 发布的 Sydney Sweeney 人物 LoRA(仅 155MB)如何在 MiniMax H3 视频模型上无需参考图、仅凭名字生成人物视频。文章讲解 LoRA 低秩自适应原理:冻结基础模型,只训练小矩阵 A、B 记录人物身份差量;还原训练过程(3440 步、120 epoch、rank 16、约 5% caption dropout);并分享本地加载实践,包括底模版本兼容、量化格式、采样步数(6 步而非 30 步才清晰)和触发词拼写等常见坑。最后指出 LoRA 技术正在改变人物身份的传播方式。

技术 › LLM Michael Guo 2026-09-0813.8 KB 32.5K 183 87

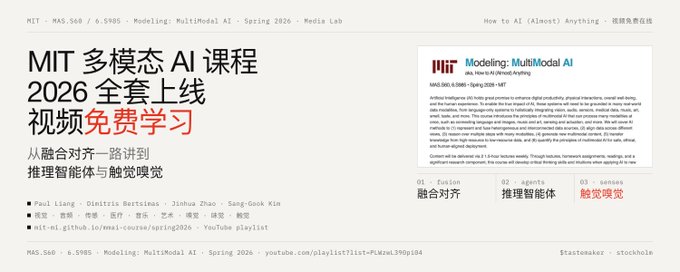
MIT 多模态 AI 课程 2026 版全套上线:视频免费在线学

MIT 由 Paul Liang 主讲的《How to AI (Almost) Anything / Multimodal AI》2026 春季课程全套视频免费上线。课程涵盖多模态学习完整技术栈:异构数据表示与融合、跨模态对齐、多模态生成、推理(RLHF、DeepSeek-R1、DPO)、智能体、跨模态迁移,以及触觉、嗅觉等新模态与自进化 AI 等前沿方向。相比 2025 版,新增多模态推理、智能体、自进化 AI 模块及制造、城市、交通等应用课。适合有机器学习基础的学习者系统建立多模态 AI 知识框架,课程网站与 YouTube 播放列表均可免费访问。

技术 › LLM meng shao 2026-09-089.9 KB 63.9K 32 82

小白必看:从词向量到Transformer,一口气搞懂自然语言NLP技术发展

文章以一个趣味猜词游戏切入,通俗易懂地讲解NLP技术的演进历程。首先介绍基于统计的N-gram模型及其在组合爆炸和语义理解上的局限;接着引出词向量(Word Embedding),通过高维空间中的坐标表示词语含义,使模型具备泛化能力;然后讲解前馈神经网络如何利用词向量进行预测;再介绍RNN通过隐藏状态机制处理任意长度文本,实现记忆功能;最后指出RNN存在长期依赖问题,为LSTM等改进方案做铺垫。全文循序渐进,用生活化例子帮助读者理解语言模型预测下一个词的基本原理。

技术 › 编程语言 轩辕之风 2026-09-0329.7 KB 9.9K 116 64

一口气搞懂 Transformer:注意力、QKV、残差连接全讲透

本文是 Transformer 架构的科普长文,作者轩辕之风回顾了从 N-gram、词向量、RNN 到 LSTM 的语言模型发展历程,指出 LSTM 串行计算和远距离信息传递的两大痛点。随后详细讲解注意力机制的核心思想,深入解释 Query、Key、Value 三者的作用与计算方式(点积、Softmax、缩放因子),以及多头注意力如何从多个角度捕捉指代、语法等不同关系。文章还介绍了位置编码解决并行计算丢失顺序信息的问题,并通过'苹果'的例子说明 Attention 负责信息收集、FFN 负责特征消化组合的分工。

技术 › LLM 轩辕之风 2026-09-0228.7 KB 31.7K 354 72

AI 的演进:从规则执行到自主行动

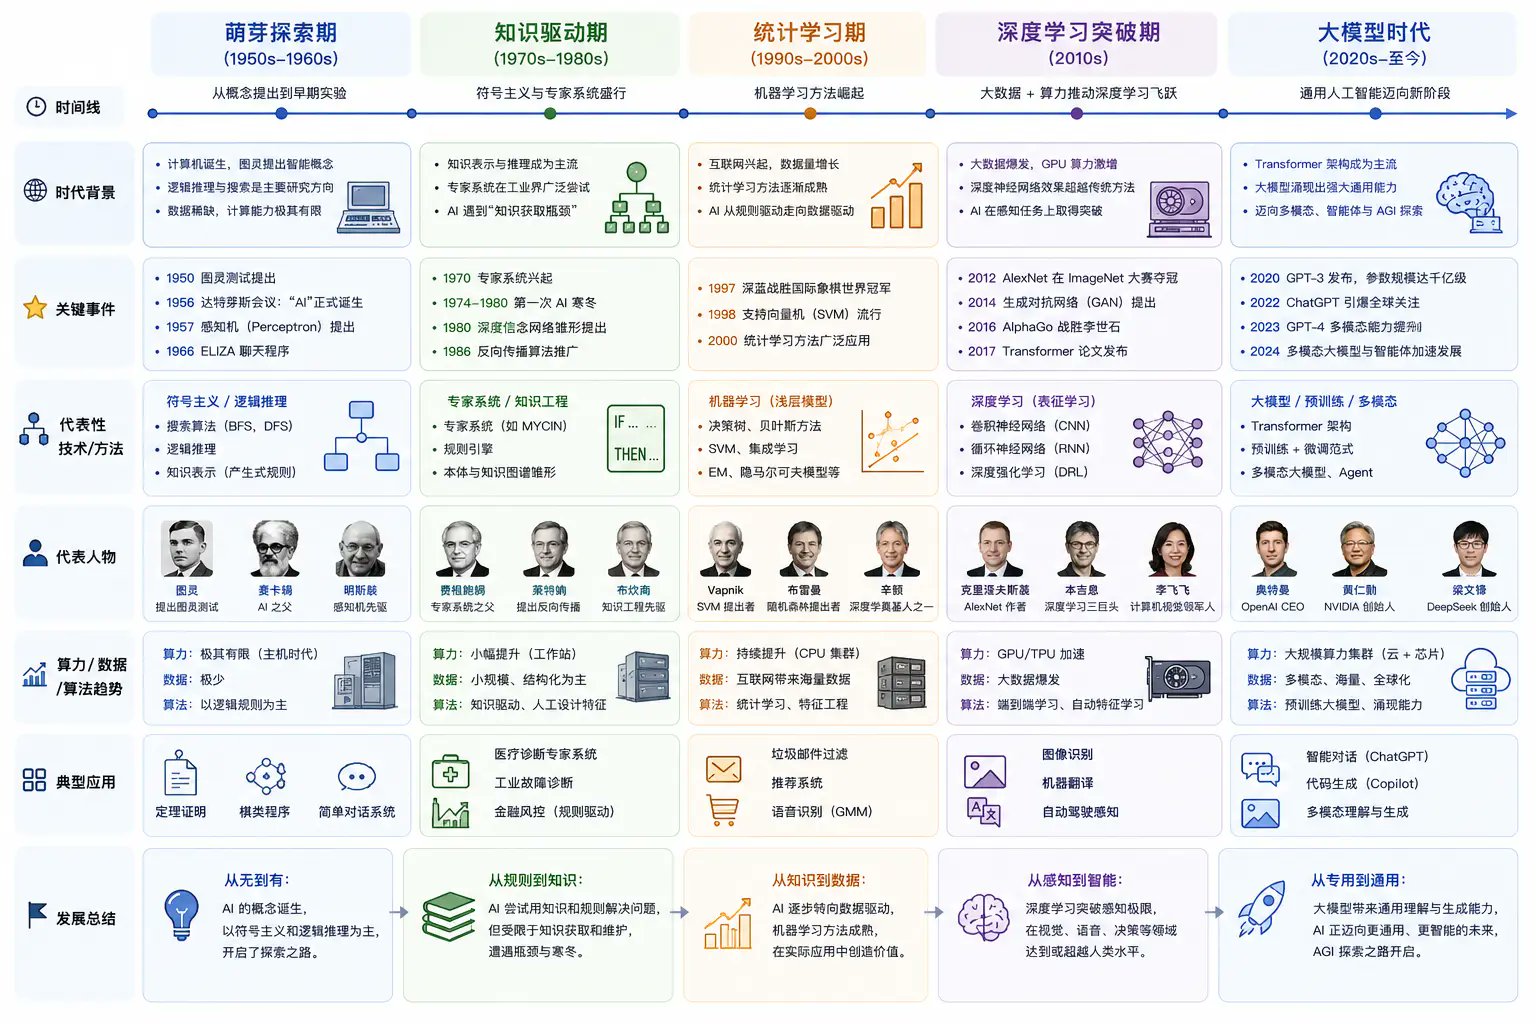
文章系统梳理了人工智能从1950年代至今的发展历程:萌芽探索期(图灵之问与达特茅斯会议)、知识驱动期(符号主义与专家系统)、统计学习期(机器学习与特征工程)、深度学习突破期(AlexNet与神经网络)、大模型时代(Transformer、GPT-3、ChatGPT与多模态)。作者指出AI处理信息的方式从人类编写规则,到机器从数据中学习,再到模型理解目标并自主完成任务。未来AI将从大模型走向智能体(Agent),能够拆解任务、制定计划、调用工具,实现从被动响应到自主行动的转变。

技术 › LLM Kelvin (@ai_Goge) 2026-09-024.7 KB 50

AIDO Cell 虚拟细胞世界模型:AI 将药物研发周期从月压缩到小时

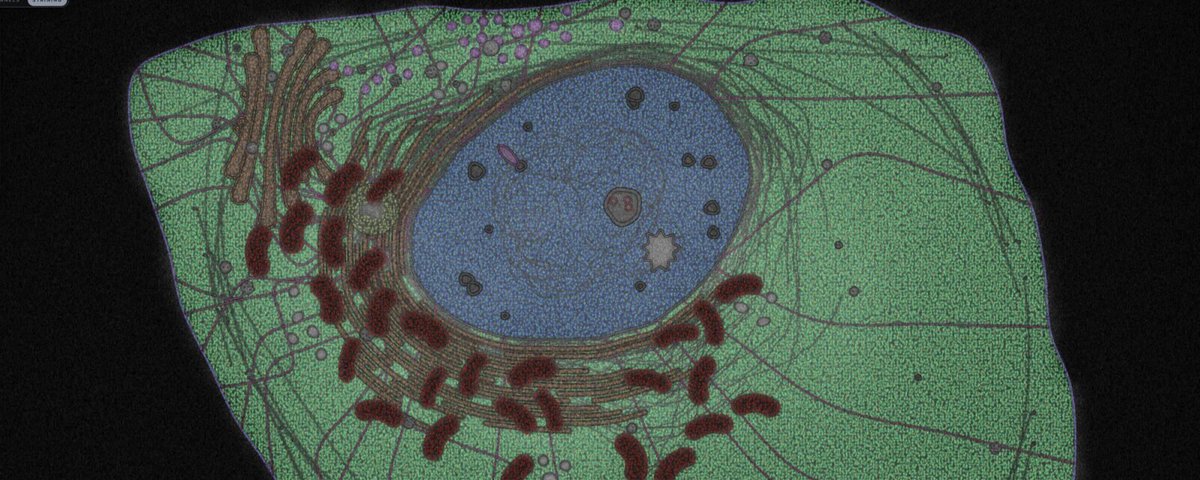
本文介绍 David Baker 旗下公司推出的 AIDO Cell 虚拟细胞世界模型。相比 Geneformer、scGPT 等基于文本统计的单细胞大模型,AIDO Cell 是有状态的因果动力学系统,通过流形降维、物理先验剪枝和神经代理求解,实现细胞动态演化的高效推演。它在抗癌药物研发中可复现靶点作用机制、前置推演耐药演化、破解多药联用组合爆炸并做全细胞毒性早筛,有望将实验筛查时间从月级缩至小时级,未来或将沿细胞—组织—器官—人体路径走向数字孪生人体。

技术 › 生物医药 rick awsb 2026-08-236.3 KB 27K 35 64

Karpathy GitHub 上最重要的 5 个仓库:从零学习 AI 基础

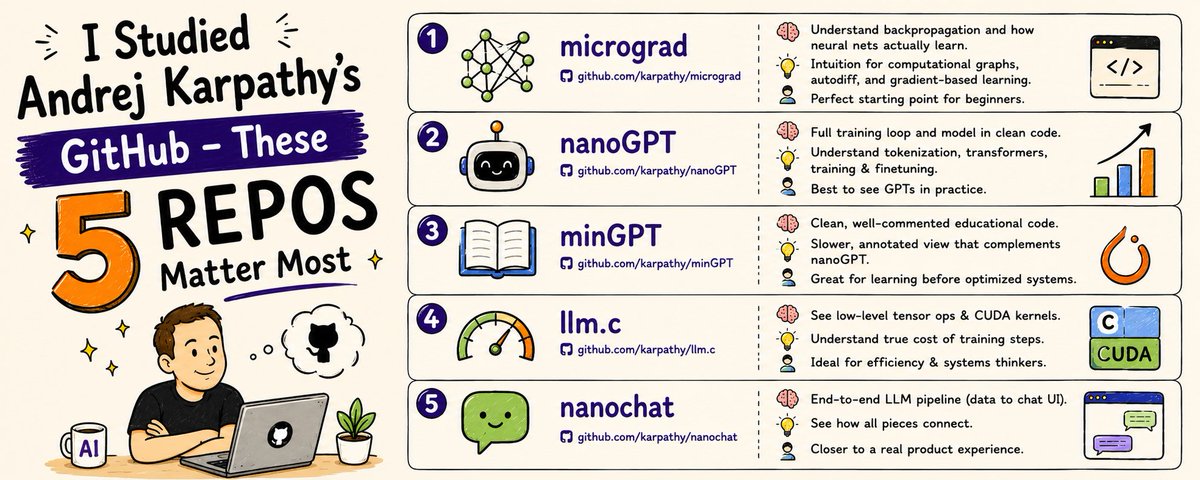
本文介绍了 Andrej Karpathy 的 GitHub 上五个最具教育价值的仓库:micrograd、nanoGPT、minGPT、llm.c 和 nanochat。这些仓库以极简和清晰著称,帮助学习者从零理解神经网络、反向传播、GPT 架构、底层实现和完整的 LLM 系统。文章强调了主动学习的重要性,并提供了实践学习路径,帮助读者从基础原理到实际应用建立直觉。

技术 › LLM Kanika 2026-08-1510.3 KB 6.8K 20 71

辛克維奇时刻,历史正在重演?

文章回顾了有限元法(FEM)的发展史,指出伯克利学派和辛克維奇因数学基础局限而导致的衰落。作者将巴布什卡悖论与当前 AI 领域的 Scaling Law 类比,警示过度堆叠参数可能无法解决根本的架构缺陷,提出智能突破需重构底层数学架构。

技术 › LLM deep Manifold 2026-08-039.5 KB 1.4K 1

一个产品经理读完200篇AI论文后,看见了别人看不见的边界

文章讲述了前豆瓣产品经理谢青池通过阅读200多篇AI论文,梳理出理解大模型发展的历史视角。他通过分析从GPU、AlexNet到Transformer等关键技术节点的演进逻辑,指出产品经理需在边界变化中寻找最优解。读论文不仅消除了他对AI发展的焦虑,也让他能更精准地预判技术趋势。

技术 › LLM 向 向阳乔木 2026-07-3118.7 KB 62.7K 339

光刻机的Deepseek时刻:从原型机到5台量产

文章探讨了中国在光刻机研发中的机会,提出“中国制造身体,AI制造脑子”的理念。通过结合中国强大的工业制造能力与AI技术,利用代理模型加速仿真、数据驱动优化控制以及构建研发闭环,可以显著缩短光刻机的研发周期并提高效率。

技术 › AI 硅基流动 2026-07-2822.1 KB 243.5K 57

从邓煜2026年菲尔兹奖的数学工作看人工智能

文章通过分析2026年菲尔兹奖得主邓煜关于硬球动力学与玻尔兹曼方程的数学工作,探讨了人工智能的数学本质。文章指出,AI的核心能力在于在没有已知全局方程的情况下进行可学习数值计算,并强调AI的宏观能力源于局部数学结构的长期演化与闭合,而非单纯规模扩张。

技术 › 人工智能 deep Manifold 2026-07-247.0 KB 1.9K 10

强化学习沉浮史:从深度寒冬到大模型封神

文章回顾了强化学习七十年跌宕起伏的发展历程。从心理学的效果律与数学的动态规划这两条根源讲起,梳理了教科书时期的理论奠基与早期边缘化。随后,深度学习的引爆带来了黄金年代,DQN与AlphaGo的辉煌让强化学习备受推崇。然而,样本效率等缺陷曾让其一度跌入谷底。如今,这门学科在大模型时代通过RLHF等技术奇迹般重生,再次站到了AI舞台的中央。

技术 › LLM snowboat 2026-07-2357.2 KB 25.6K 45

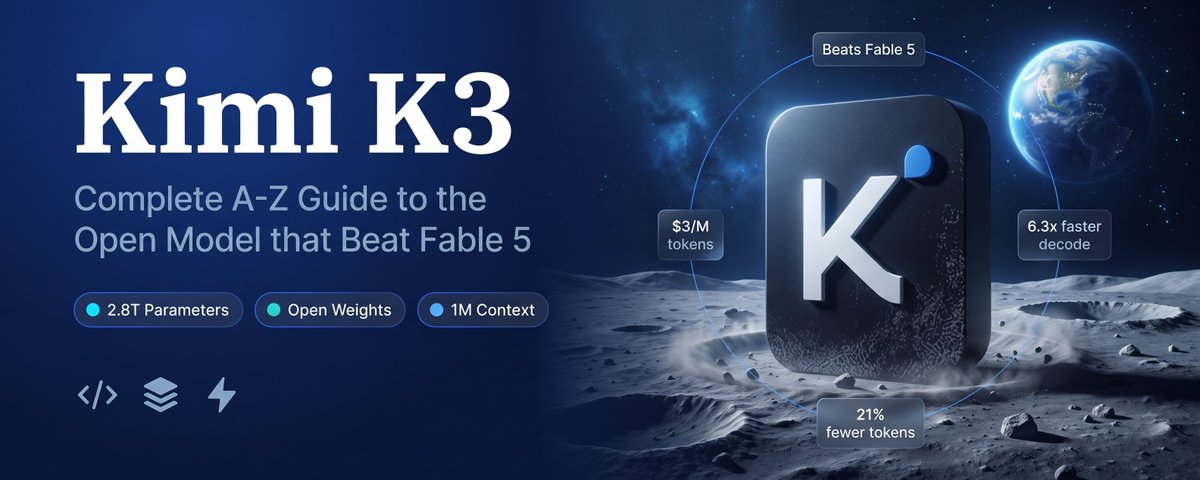
Kimi K3:超越 Fable 5 的开源模型完全指南

本文详细介绍了月之暗面发布的 Kimi K3 模型。该模型拥有 2.8 万亿参数和 100 万 token 上下文,性能超越 Claude Opus 4.8 和 GPT-5.6 Sol,对标 Fable 5。文章分析了其定价策略、架构创新以及模型自主优化架构的能力,展示了其在长程编码和 3D 前端开发方面的强大实力。

技术 › LLM Kirill 2026-07-2141.9 KB 1.3M 394

OpenRLHF 作者发布 Agentic RL 框架 Molt:9K 行核心代码支持超大规模 MoE 训练

OpenRLHF 作者发布了新的强化学习框架 Molt。该框架采用纯 PyTorch 栈,核心代码仅约 9000 行,专注于 Agentic RL 研究。它支持 Qwen3.5-397B 到 GLM-5.2 753B 等超大规模 MoE 模型训练,无需依赖 Megatron,具备高度的代码可读性和可修改性。

技术 › LLM 青稞社区 2026-07-1610.2 KB 9.5K 81