Wiki 知识库

全部文档 / 标签: 科学发现

7 篇
清除

Agentic Economies:多智能体科学经济的瓶颈与制度设计

Google DeepMind 9 月发布的论文《Agentic Economies for Autonomous Scientific Discovery》主张,AI 科研的真正瓶颈不在想法生成而在资源有限的验证,需设计市场与制度解决协作、信用分配、问责与安全问题。AI 裁判 Pith 批评其核心论点与自引证据相悖且缺乏实证。产业侧 Molecule 的 Onchain Lab 已按论文要求施工。实验证据双向:Economy of Minds 的拍卖机制大幅提升 agent 任务表现,而另一实验显示仅有经济角色不会产生交易,需可验证的工作与权利。结论:经济制度的威力来自可验证性,而非价格标签。

技术 › Agent yibie 2026-10-146.3 KB 72

BestBlogs 早报 · 09-13|Dario 安全调速,AI 创投幂律重估,Impeccable 设计语言

本期早报围绕三条主线展开:一是 Anthropic CEO Dario Amodei 提出前沿模型能力提升需放慢节奏、为安全核验留出时间,并建议引入嵌入式独立评估者;二是 a16z 讨论如何改写风险投资幂律,认为 AI 让资本更直接转化为规模优势,但只有嵌入客户工作流才形成护城河;三是 Paul Bakaus 谈 Impeccable 设计技能,强调团队需为智能体建立共享设计语言。速览部分还涵盖 AI 科学发现、数学与 AI 宣言、OpenAI Agents API、Claude 安全对齐缺陷、空间智能及 AI 搜索抗菌分子等内容。

技术 › LLM ginobefun 2026-09-1323.1 KB 5.4K 3 75

AI下一个类Coding的大场景在哪?聊聊AI发展中的四个时间差

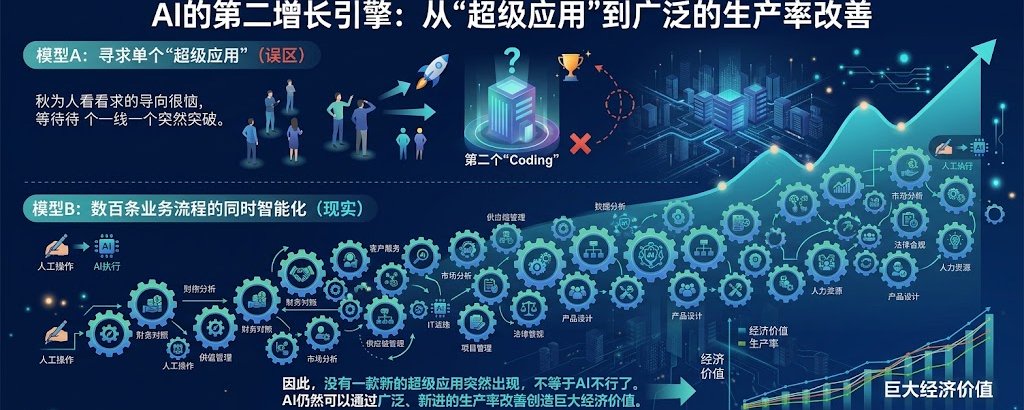
文章分析了为什么Coding成为AI第一个杀手级应用,指出其成功源于数据数字化、结果可验证、流程可拆解等条件。作者认为下一个大场景不会是单一的“第二个Coding”,而是客服、财务、IT运维、医疗、法律、供应链等数百条业务流程同时Agent化的总和。通过微软Foundry、M365 Copilot和Agent 365三组数据,文章判断企业AI正处于从第二阶段向第三阶段扩散的过程中,呈现“广而不深”的特点。最后展望了个人行动Agent和AI科学发现两大长期机会。

投资 › 宏观经济 qinbafrank 2026-08-2338.3 KB 104.8K 127 88

面向发现式智能的基准:TRACES

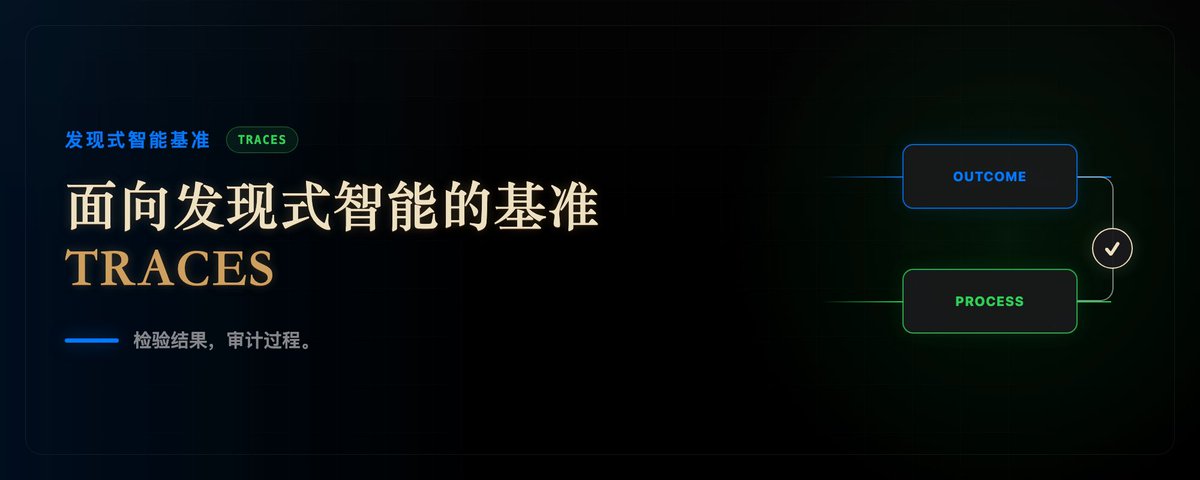
本文介绍 Apodex Discovery 提出的 TRACES 基准,用于评估 AI 系统能否通过证据充分、可审计、可修复的调查得到正确结果。与传统基准只衡量最终答案不同,TRACES 将评估单位扩展为完整调查过程,通过结果验证器与盲评的过程验证器(HDS6:工具、修复、备选解释、连贯性、证据、适用边界)双通道评价。基准提供 AAV 衣壳设计、药物再利用、临床试验、大模型工程四个可执行环境,实验显示过程诊断反馈可使结果得分平均提升 0.155。文章还比较了 TRACES 与 MMLU、SWE-bench 等基准的差异。

技术 › Agent Dongxi 东锡 NLP 2026-08-2311.9 KB 10.3K 19 74

Advancing Scientific Discovery with DeepEarth: 用突破机器实现25倍能力提升

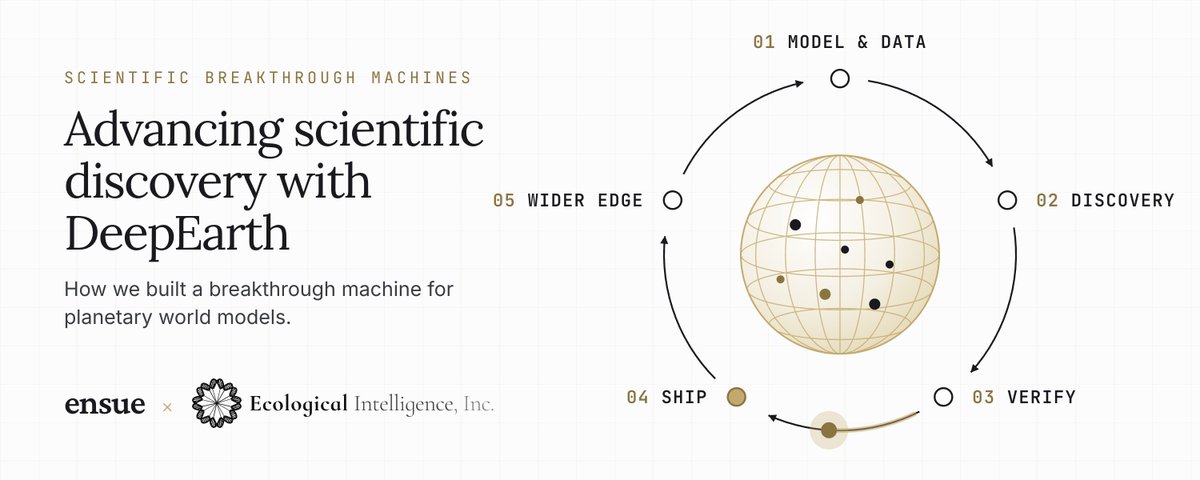
文章提出'科学突破机器'概念:无需先实现AGI,通过范围受限的自我改进循环(sub-RSI loop)即可在特定问题上模拟ASI效果。作者团队将其应用于DeepEarth——一个多模态时空世界模型,用于全球环境智能。系统通过共享记忆、快速筛选实验预算、基于不变量的验证与计分卡机制,让智能体集群自主进行假设、实验与迭代。最终将模型调和均值从0.016提升至0.407,实现约25倍的能力提升,并发现单一编码器的改进未必带来融合能力的提升,环境信号(如AlphaEarth卫星嵌入)是最大杠杆。

技术 › Agent Sai Vegasena 2026-08-1911.3 KB 279.3K 42 72

MLS-Bench:AI自进化假象的硬核测试

本文介绍了MLS-Bench基准测试,该测试旨在评估AI系统在机器学习研究中的方法发现能力,而非仅仅是工程执行能力。MLS-Bench包含12个领域、140个真实研究任务,通过控制可修改范围、复现强人类基线、跨条件验证等设计,将算法贡献与调参、容量等因素分离。实验表明,当前AI模型即使经过多轮迭代,也主要是在优化和组合现有组件,未能发现新机制,且在实验规划和论证判断方面表现不足。文章指出,真正的科学发现需要方法提出、实验设计、预算分配、证据判断等综合能力,而当前模型尚未具备。MLS-Bench已被Kimi K3、Qwen3.8-Max等模型官方评测采用,成为衡量AI研究能力的新前沿。

技术 › LLM 青稞社区 2026-08-1417.6 KB 3.5K 9 74