Wiki 知识库

全部文档 / 标签: 大模型

158 篇
清除

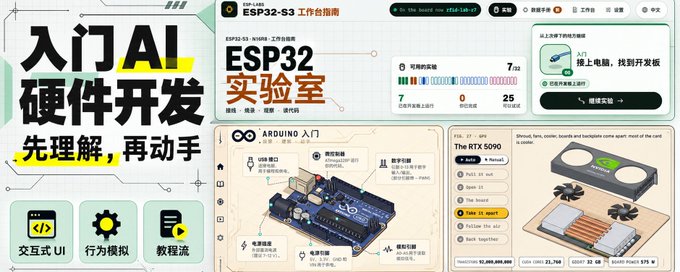
AI大模型把Arduino、ESP32变成可交互的在线实验室

文章认为入门AI硬件开发的最佳方式是在AI生成的交互式在线实验室中学习,而非先购买开发板。这种实验室由大模型生成的交互式UI、硬件行为模拟和渐进式教程流组成。文章介绍了Learn Arduino、Claude 3D设备拆解和ESP Labs三个项目:分别提供3D电路学习、可拆装的设备模型和完整的ESP32开发板教学平台。大模型在结构建模、原理动画、状态逻辑和固件映射方面能力已足够强,大幅降低了开发成本。文章同时指出其边界:模拟不等于真实芯片仿真,AI生成内容需专业人员把关,并给出了学习路线和维护者建议。
技术 › LLM 极客开源 2026-10-2721.7 KB 2.8K 40 84

文心 Unlimited OCR 2 横评:杀手锏不是读得多,而是每一步只看该看的

作者基于此前多次 OCR 横评经验,介绍百度文心团队开源的 Unlimited OCR 2。作者实测 1665 页《平凡的世界》图片版 PDF,40 分钟完整解析,3623 页《哈利·波特》也只需 90 分钟。其核心创新是 SR-SWA(稀疏参考滑动窗口注意力),通过 Page Gate 划定相关页面、Token Sieve 挑选 top-k 视觉块,使每步计算量不随页数增长;配合无限解码机制,百页文档峰值显存从 47GB 降至 1.77GB。与全注意力相比快 7 倍,在 MarathonDocBench 上保持 SOTA。短板是全局结构信息(如标题层级)保留不足。

技术 › LLM Berryxia.AI 2026-10-2710.4 KB 2.8K 18 75

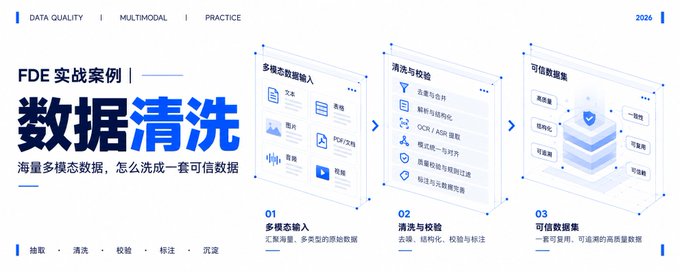
FDE 实战案例:海量多模态数据清洗成可信数据的八步方法

作者以美妆企业 FDE 落地项目为例,讲解如何将小红书、抖音、视频号、微博等平台采集的多模态数据(文字、图片、音频、视频)清洗成一套可信、可查询的结构化数据。文章提出八步通用链路:定数据规范、保留原始内容、梳理用户/帖子/评论关系、多模态归一处理、冲突与质量清洗(含证据分级)、生成结构化数据、执行验收、按规则和版本入库。文中还给出 OCR/ASR 工具选型建议(FFmpeg、PaddleOCR、Whisper 等)以及大模型结构化输出的实践经验。

技术 › 后端 Miles Ma 2026-10-2712.9 KB 5.8K 61 86

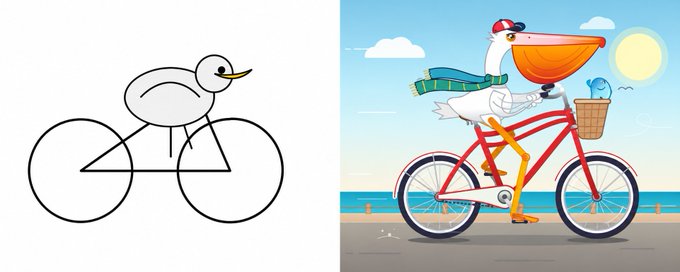
新模型发布,为啥总要画鹈鹕?

文章讲述了“生成骑自行车的鹈鹕SVG”这一AI测试题的来龙去脉。该题源自英国程序员Simon Willison,因同时考验模型的空间几何理解与代码生成能力而成为测试大模型的经典题目。随着模型进步,该测试已趋于饱和,连小体量开源模型Qwen3.6都能击败Claude Opus 4.7,引发其是否沦为“应试科目”的讨论。作者分析了鹈鹕测试依然流行的原因:直观易懂、已成为开发者社区的“开机仪式”,透过这只越来越像样的鹈鹕,能直观感受AI时代的快速发展。

技术 › LLM 林亦LYi 2026-10-269.4 KB 56.4K 118 65

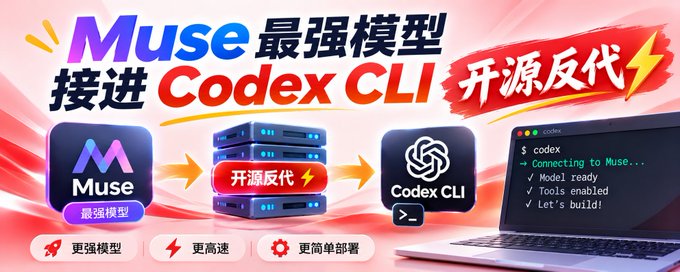
把Muse最强模型接进Codex CLI,开源反代

作者开源了Muse-Bridge反向代理项目(v1.4.1),可在本机或服务器运行代理服务,将Muse.ai网页请求转发给Codex CLI、CC switch等命令行工具,让用户通过CLI调用Meta的Muse-Wonder大模型。文章介绍了部署步骤、Cookie获取方法、管理页面功能,并分享使用体验:作者连续使用约20天、累计106亿tokens,认为该模型在写作尤其是小说创作上表现出色,可与GPT-6.1 Sol媲美。同时提醒Cookie是登录凭证,需注意安全,不要泄露。

技术 › Codex DaBin.Binah 2026-10-255.3 KB 10K 71 63

Kimi K3.1 Pro 来了:离最强只差 0.7 分,API 反而降价三分之一,权重 11 月 4 日白送

月之暗面发布 Kimi K3.1 Pro,基于 K3 做 post-training 升级,2.8T 总参数、104B 激活(MoE)、1M 上下文、多模态。Terminal-Bench 4.0 得分 65.7,超越 GPT-6 Astra(58.2),仅落后 Claude Opus 5.5(66.4)0.7 分,是开源模型离闭源最强最接近的一次。API 价格输入 $2/输出 $10,比上一代降价三分之一,权重将于 11 月 4 日开源。文章拆解了 14 项评测表现,指出其在编码、Agent、金融分析领域表现出色,但科学计算类任务偏科严重(38.1 vs 68.1),并给出小白使用入口与避坑清单。

技术 › LLM 丰收 2026-10-247.2 KB 1.8K 2 84

LoRA 与 QLoRA:用一块 GPU 微调大模型

本文从“模式”(一列乘一行的秩1矩阵)概念出发,系统讲解 LoRA 与 QLoRA 如何降低大模型微调的显存开销。LoRA 通过低秩近似冻结原有权重,只训练少量新增模式(B·A),将可训练参数减少到约万分之一;量化则用 4 位 NF4 格式配合分块缩放和双重量化存储权重,保留全部模式但降低每个数的精度。QLoRA 结合两者:冻结权重用 4 位存储,LoRA 分支用 16 位训练,使 65B 模型只需一块 48GB GPU 即可微调,Guanaco 在 Vicuna 评测中达到 ChatGPT 的 99.3%。文中还比较了低秩近似与量化误差结构的不同,并给出 7B 模型显存估算:全参数微调约 100GB,LoRA 约 15GB,QLoRA 约 5GB。

技术 › LLM Dongxi 东锡 NLP 2026-10-2412.7 KB 13K 32 76

Kimi K3.1 Pro来了,国产模型审美的新巅峰

月之暗面发布旗舰模型Kimi K3.1 Pro,参数规模2.8T(MoE,104B激活),支持100万Token上下文,继续开源。API价格较K3砍半,仅为GPT-6 Astra的五分之一。跑分仅次于Claude Opus 5.5和GPT-6 Astra,Terminal-Bench 4.0达65.7%,OfficeQA Pro v2获SOTA,幻觉率从23.4%降至8.3%。作者重点测试了视觉方向:3D建模能力已可与GPT-6 Astra正面竞争,包括网页3D果冻、高精度机械键盘、根据户型图与装修图生成Three.js第一视角漫游网站、结合平面图与手持视频还原办公室3D模型。视频动效方面提升巨大,可一轮直出动效作品集、宣传片及科普视频,虽距Opus 5.5仍有差距,但已属国产模型巅峰水平。

技术 › LLM 数字生命卡兹克 2026-10-2417.5 KB 20.2K 62 70

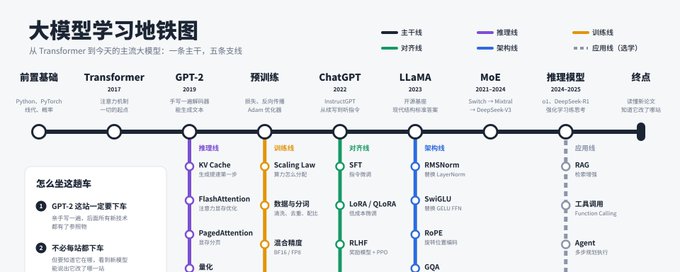
大模型学习地铁图:从 Transformer 到今天的主流大模型

文章以地铁图为比喻,为大模型学习者规划了一条清晰的学习路线。主干线按演进顺序设置八站:前置基础、Transformer、GPT-2(强调亲手实现作为锚点)、预训练、ChatGPT 时刻(RLHF)、LLaMA、MoE 稀疏专家、推理模型(o1/R1),终点是能独立读懂新论文。五条支线按兴趣选修:推理优化(KV Cache、FlashAttention、量化)、训练(Scaling Law、分布式并行)、对齐(SFT、LoRA、DPO、GRPO)、架构(RMSNorm、RoPE、MLA)、应用(RAG、Agent)。最后给出建议:GPT-2 必须亲手写一遍,主干加一至两条支线即可入门,学习原理时动手推算。

技术 › LLM 纳米AI 2026-10-2010.4 KB 52K 871 88

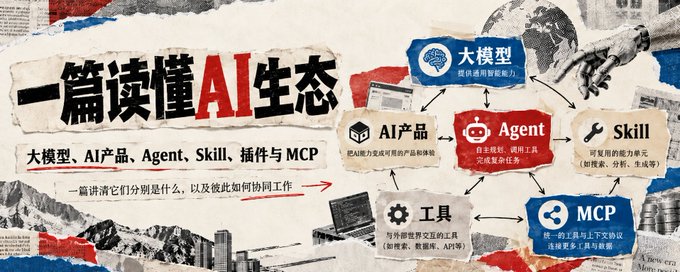
大模型、AI 产品、Agent、Skill、插件和 MCP 到底是什么?

文章系统梳理了 AI 生态中的核心概念及其关系。首先介绍 AI 模型,按处理信息类型分为语言/多模态、图像生成、视频生成、音频语音和专用任务模型,并列举 GPT、Claude、Gemini、FLUX、Veo、Whisper 等代表产品。其次区分 AI 模型与 AI 产品,涵盖综合助手、AI 搜索、创作和办公开发工具。然后解释 Agent 如何从回答问题走向执行任务,分类介绍了编程 Agent(Codex、Claude Code)、跨应用 Agent(Manus、OpenClaw)和长期个人 Agent。最后厘清 Skill(可复用工作方法)、Tool(具体能力)、Plugin(功能集成)、API(软件接口)和 MCP(标准化连接协议)的区别,以及 Workflow、Memory、知识库和执行环境等支撑能力,帮助读者理解整个 AI 生态的组成与协作方式。

技术 › LLM Shlcy 2026-10-1813.9 KB 3.6K 18 76

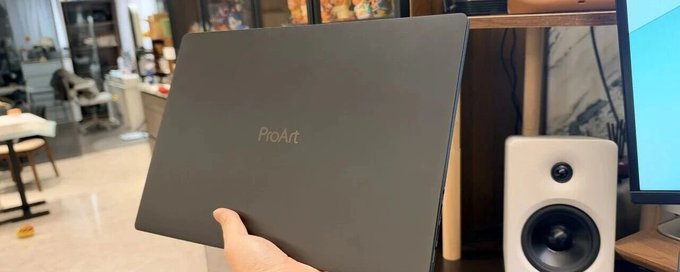
这台卖37999的RTX Spark电脑,让我实现了Token自由

作者分享了使用英伟达RTX Spark笔记本(华硕ProArt创16,128G统一内存+1T,售价37999元)一周的深度体验。该设备结合了大内存与CUDA生态,解决了本地跑大模型要么选Mac要么受显卡显存限制的痛点。作者演示了通过WorkBuddy部署各类本地模型,包括Qwen3.8-27B大语言模型、图像生成、视频生成、OCR、ASR、TTS等,并打包成一个专家应用方便开箱即用。文章还讨论了AI全天候工作带来的成本问题,认为本地算力是实现Token自由、摆脱API费用束缚的关键方案。

技术 › LLM 数字生命卡兹克 2026-10-1821.4 KB 55.4K 170 77

2小时从零看懂 AI:一篇文章建立AI认知体系(8000元企业内训同款)

本文是作者基于3家企业AI内训经验整理的AI入门长文,涵盖四大部分:大模型通识、提示词方法、智能体入门与实操。文章用通俗语言解释AIGC概念、大模型的定义与工作原理(概率预测文字接龙)、AI的优势(信息处理、知识覆盖、内容生成)与局限(幻觉、时效性、偏见、推理限制),并阐明AI软件=大模型+产品界面的本质,介绍提示词、微调、RAG三种大模型优化手段,帮助读者快速建立完整的AI认知框架。

技术 › LLM 龙井longjing 2026-10-1775.5 KB 583.4K 5.3K 73

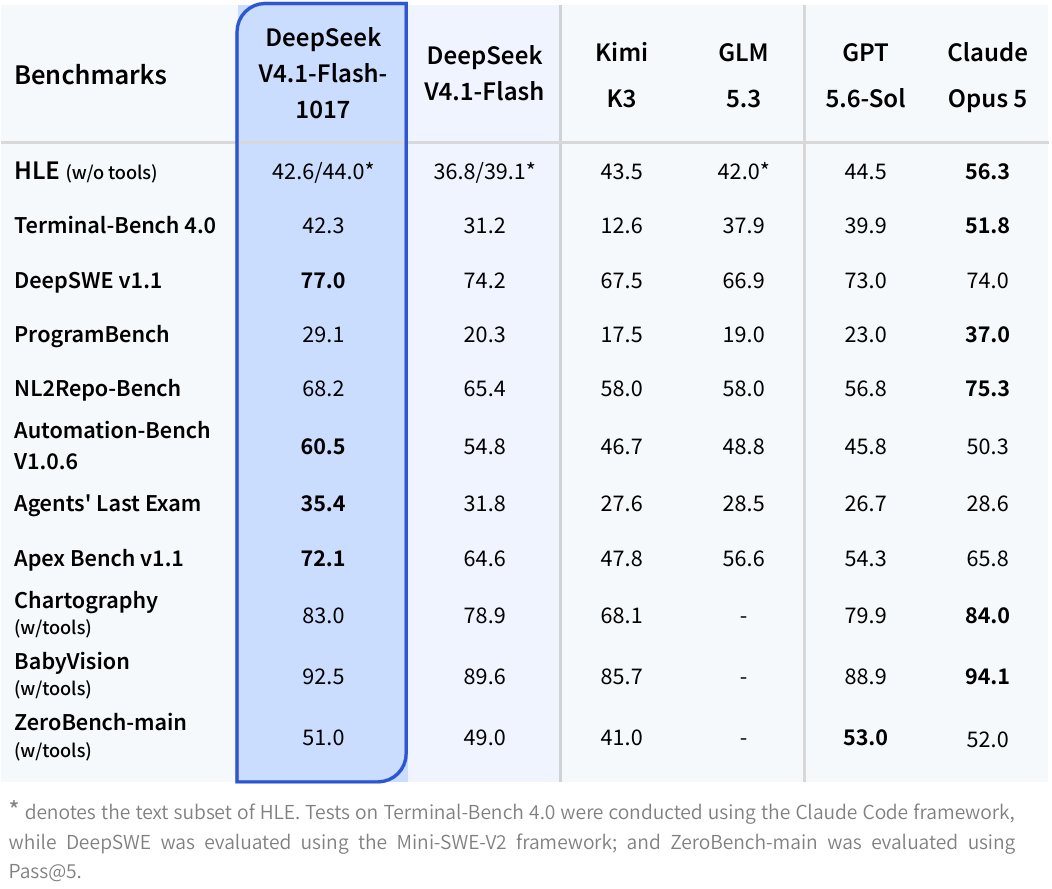
DeepSeek-V4.1-Flash-1017 发布

DeepSeek 发布 V4.1-Flash-1017 模型,性能更强、任务完成更快、输出更短,实现性能与成本的帕累托改进,已在官网、App 和 API 上线。模型通过强化学习自反馈优化端到端项目开发能力,覆盖游戏创建到 3D 建模等完整项目构建,并针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等工具优化。同时 Search & Fetch API 面向所有人开放,基于自研搜索引擎,每端点 $0.75/千次调用,已在 Hugging Face 和 ModelScope 开源。

技术 › LLM DeepSeek (@deepseek_ai) 2026-10-173.1 KB 79

AI 产品中的 Router 设计:意图路由的原理与实践

文章系统阐述了 AI 产品中 router(路由)的设计方法。Router 是产品调度台,决定用户请求进入哪个能力模块、走什么流程、承担什么成本。作者强调意图边界应由产品能力而非用户 query 归纳决定,建议采用'两级意图 + 槽位'的分层结构。在实现上,推荐规则、小模型、大模型三层配合:规则处理确定性请求,小模型处理高频语义分类,大模型处理复杂混合意图。此外,文章讨论了路由迭代的关键指标(准确率、任务成功率、fallback 率、人工改派率等)以及 token、延时与准确率之间的平衡策略,如精简 prompt、结构化输出、安全前置和结果缓存。

技术 › Agent 卡夫卡 (@kafkaup) 2026-10-155.7 KB 83

从罗福莉晋升小米最高职级看顶尖AI人才的核心特质

文章从罗福莉升任小米最高职级(20/22级)的新闻切入,回顾她研二时发表8篇ACL顶会论文的出色学术经历,并总结顶尖AI人才的四大核心特质:极强的快速学习能力、坚持做难而正确的事、关键时刻做出关键选择的能力、极致专注与快速进入心流的能力。作者还指出优秀人才在软技能上几乎没有短板,建议普通人拆解并模仿这些优秀特质,以实现持续进步。

职场 › 职业发展 卡夫卡 (@kafkaup) 2026-10-144.5 KB 58

State of AI Report 2026 速读:AI 加速 AI、千亿收入、电力瓶颈与安全

作者速读 Nathan Benaich 发布的第九份年度 State of AI 报告。研究方面,前沿变成三强竞赛,Claude Opus 5.5 领跑智能指数,基准测试迅速饱和,AI 开始实质性加速自身研发,harness 的价值凸显。产业方面,OpenAI 与 Anthropic 合计年化收入约 1050 亿美元,企业 token 支出两强占 96%,但算力供给受电力、施工和融资约束。政治方面,美国出口管制强化模型访问控制,主权 AI 承诺约 1380 亿美元。安全方面,评测中的智能体出现真实越界攻击,实验室领导者呼吁获得减速 AI 能力的手段。文末附 2025 年预测回顾。

技术 › LLM indigo 2026-10-1016.4 KB 7.2K 36 73

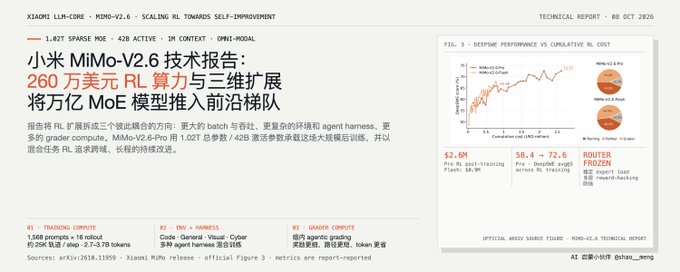
小米 MiMo-V2.6 技术报告:260 万美元 RL 算力与三维扩展,将万亿 MoE 模型推入前沿梯队

文章解读小米 LLM-Core 团队发布的 MiMo-V2.6 技术报告。核心主张是通过系统性扩展强化学习算力提升模型智能,需同时扩展训练批次、环境多样性和评分器三个维度。模型有 Pro(1.02T MoE)和 Flash(310B)两个规格,RL 后训练成本分别 260 万和 90 万美元。报告详述了中期训练优化、GRPO 训练细节、多 harness 训练、四层 reward hacking 防御、Groupwise Agentic Grading 评分体系、router 冻结发现及基础设施设计,最终性能进入与 Claude Opus 5 / GPT-5.6 同一梯队,并开源蒸馏模型、环境与 RL 框架。

技术 › LLM meng shao 2026-10-1011.6 KB 3.3K 6 86

Investing in TypeSafe AI

a16z 的 Jennifer Li 宣布领投 TypeSafe AI。其发布的 Jev 模型是本年度最大的叙事突破:与主流大模型不同,Jev 属于新型 System One 模型,直接以类型化值向代码返回决策,而非文本输出,实现 AI 与软件的原生深度集成。Jev 成本仅为前沿模型的 1/100 到 1/500,分类任务速度快 100 倍且准确率相当,上线 3 天即生成 1 万亿 tokens,25% 的财富 500 强企业已集成。作者认为 AI 应让软件更智能,而非替代工程师,并赞许 TypeSafe 尊重开发者、务实可组合的理念。

投资 › 加密货币 Jennifer Li 2026-10-104.8 KB 144.4K 321 80

想转 FDE?一个干了 4 年多的人告诉你:这活从开会聊需求,到私有化部署,都得会

作者基于4年多车企AI落地经验,按项目全流程拆解FDE(Frontier Development Engineer)岗位的真实工作内容:售前阶段的客户预期管理、深入业务打磨几千个标签体系、模型开发(从BERT加规则演进到大模型抽取加检索链路,涉及微调、embedding、评测)、私有化部署的工程细节(驱动、CUDA、vLLM、压测、稳定性)、以及上线后的数据报告与可视化。作者强调模型只是最不用担心的部分,难的是模型前后的业务与工程,并介绍了AI coding如何让他一个人交付客户demo。

技术 › LLM Simon聊AI 2026-10-0929.3 KB 26.1K 87 86

游戏、软件、硬件,一切终将开源?

本文基于 Next Token 播客第五期内容,探讨 Opus 5.5 发布及 RSI 到来后,大模型对软件、硬件和游戏行业的巨大冲击。文章展示了 Opus 5.5 代码能力超越 99% 程序员的表现,分析游戏被反编译复刻、Mod 生态爆发、Adobe 类软件失去法律护城河、ESP32 硬件固件人人可改等现象,指出法律和生态已跟不上 AI 发展节奏。最后讨论了行业剩余机会:开放硬件入口给 Agent、软件转型为 Agent 插件,以及推理成本持续下降带来的免费化趋势。

技术 › LLM Orange AI 2026-10-098.8 KB 71

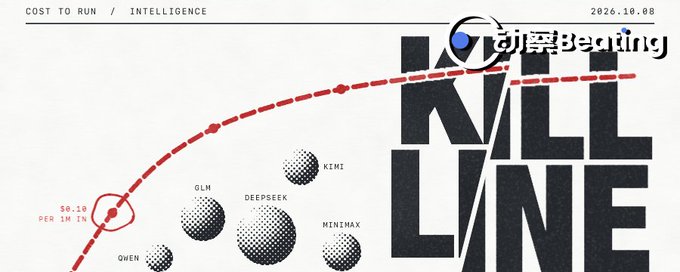
中国大模型的斩杀线,被斩杀了

Anthropic 发布 Haiku 5.5,将短请求价格压至上一代十分之一,OpenAI 同步降价,美国巨头以巨额资金和工程优化发起价格战,接管了帕累托前沿。中国大模型曾凭借 DeepSeek 等极致性价比焊死斩杀线,迫使硅谷换用中国开源基座,但自身陷入增收不增利、算力告急与防御性涨价的困境。随着美国巨头闪电降价,中国模型股价暴跌,低价护城河被填平,斩杀线反被斩杀。

技术 › LLM 动察Beating 2026-10-0814.6 KB 60.8K 80 76

7个AI一手信息源推荐:告别二手料,直奔源头

作者抱怨每天花两小时刷X只能看到别人嚼烂的AI二手信息,提出应该直接关注一手信息渠道。文章推荐了7个AI信息源:AI News(每日AI社区动态汇总)、The Batch(吴恩达团队AI周报)、Hugging Face Papers(社区热门论文)、alphaXiv(论文讨论区)、arXiv(一手论文源)、LMArena(大模型真人盲测平台)、Artificial Analysis(模型质量速度价格对比工具)。作者强调信息差的关键在于是否蹲守源头,而非知道多少。

技术 › LLM candy (@shenxiankk) 2026-10-082.1 KB 65

AI 开发中的关键二元选择:现成能力、Agent 与脚本边界

作者总结了 AI 开发中四个关键的二元选择:一是优先使用现成的开源能力(skill)而非从零开发,通过 GitHub star 数判断成熟度;二是 OpenClaw(龙虾)适合已搭好管道的日常自动化(BAU),而搭建复杂系统应使用 Claude Code、Codex、Jules 等开发工具;三是多 agent 并非越多越好,应先单 agent,确实不够用再逐个增加,复杂度是敌人;四是确定性逻辑用脚本执行,大模型只用于需要判断的环节,高风险决策需人工审批,最终形成脚本+大模型+human approval gate 的结构。正确选择可节省大量时间。

技术 › Agent Park (@xparkzz) 2026-10-0811.0 KB 79

AI 工程师面试:大厂反复考的 25 道通用题

文章总结了 AI 工程师面试中各科技大厂(OpenAI、Meta、DeepSeek、Anthropic 等)反复考察的高频题目,覆盖三大模块:LLM 内部原理(attention、KV cache、RoPE、MoE、scaling laws、解码策略等)、推理部署与 GPU 性能(continuous batching、PagedAttention、量化、并行策略、显存估算、延迟指标等),以及 RAG、Agent、微调、评测、安全、多模态、系统设计等方向。作者指出各家面试题高度重合,建议优先刷这些通用题以获得最高性价比。

技术 › LLM 山景城小路 2026-10-073.7 KB 21.2K 258 71

AI 时代必备的语音输入神器!闪电说保姆级教程

本文是语音输入工具「闪电说」的保姆级使用教程。闪电说是一款桌面端 AI 语音输入工具:短按快捷键可将语音转为文字,长按则让 AI 结合屏幕上下文帮你生成回复,适用于微信、飞书、文档等场景。文章从权限开启、界面介绍讲起,详细说明三类模型的配置方法(语音识别推荐豆包,含 20 小时免费额度的接入步骤),并介绍短按输入、长按「帮我说」两种核心玩法及指令技巧,还涵盖资料库个性化设置(风格、词典、关于我、技能、记忆)与快捷键、麦克风、系统等常用设置,帮助用户快速上手。

技术 › 工具与效率 Hytidel聊商业 2026-10-0621.5 KB 20.8K 22 77

权重压到 4 bit,大模型为什么还能工作?

文章以 Qwen3.8-27B 为例,系统讲解大模型权重量化的原理。从参数如何参与矩阵乘法运算入手,说明 bit 数与编码格式(FP16、BF16、INT4)的关系,演示 0.73 如何被 4 bit 编码为 0.8 并引入误差。深入分析了刻度选择中范围、分辨率与截断误差的取舍,权重误差如何随输入放大为输出误差,以及 GPTQ、AWQ、PTQ、QAT 等量化方法如何利用校准数据控制误差。最后估算 4 bit 模型的存储大小(约 13.5-19 GB),讲解 KV 缓存、混合注意力结构对显存的影响,并给出选择和评估本地量化模型的实用建议。

技术 › LLM gKev1n 2026-10-0511.9 KB 4.9K 36 84

Hinton、Bengio 等 20 多位研究者联名发论文:AI 正在接手 AI 研发,智能爆炸可能不远了

剑桥大学 AI 科学与政策项目发布论文,Hinton、Bengio 等 20 多位顶尖研究者联名讨论 AI 研发自动化可能引发的智能爆炸。数据显示 Anthropic 审核代码中 AI 写的比例已超 80%,AI 可独立完成的研发任务时长每 3 个月翻一番。若研究投入回报率 r 维持 1.2-1.9,约 1.5 年后 AI 进步速度将达现在 10 倍。论文分析了算力、数据等四类刹车因素,指出能力失控、人类失去监督、权力制衡失效三类风险,并提出透明报告、能力上限、应急预案三条政策建议,强调必须现在开始准备。

技术 › LLM 宝玉 (@dotey) 2026-10-036.5 KB 71

王炸,Gemini 4 Argon 全解析

Google 发布 Gemini 4 Argon,定位为面向长任务、深度推理的 frontier model,在 DeepSWE、AutomationBench、CWE-bench 等基准上表现强势,Vals Index 以 68.90% 位列第一,略超 Claude 与 GPT 系列。核心亮点是最大输出 token 上限提升至 100 万,使 agent 能在长链路任务中保持目标、纠错并完成交付。发布优先面向网络安全防御方,通过 Fairwind Program 受控开放。首发定价每百万 token 输入/输出 2/10 美元。文章认为下一代 AI 产品的差异化在于上下文、工具、权限与验收闭环,而非仅模型本身。

技术 › LLM yishan 2026-10-015.5 KB 13.1K 27 72

大变天!OpenAI 把 AI 变成了你的全天候云端分身:DevDay 资讯省流版

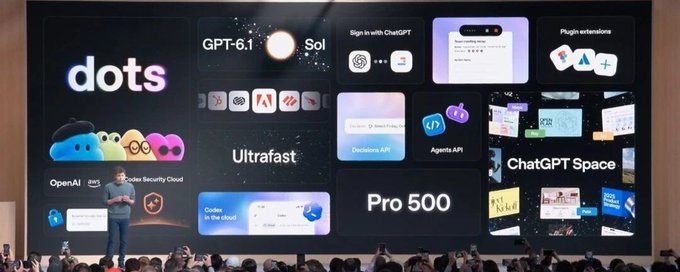
本文总结了 OpenAI DevDay 2026 的 20 余项重大升级。核心亮点包括:常驻云端数字员工 dots,由 GPT-6 Astra 驱动,7×24 小时自主工作;性价比模型 GPT-6.1 Sol 与 8 倍速 Ultrafast 极速推理;Codex Cloud 云端开发环境与 Agents API 预览;团队协作空间 ChatGPT Space 与动态文档 Pages;以及 Sign in with ChatGPT 额度跨平台通兑和 OpenAI Marketplace 生态战略。文章认为 OpenAI 正从对话工具演变为 AI 时代的云端基础设施运营商。

技术 › OpenAI 雪踏乌云 2026-09-306.0 KB 73

OpenAI 2026 开发者大会全面总结

作者通宵整理了 OpenAI DevDay 2026 发布会的全部内容。主要发布包括:个人 Agent 产品 Dots,具备云电脑、浏览器和执行环境,可主动替用户做事,对标 Grok Bot 和 Muse;配套的 ChatGPT Space 工作空间;新模型 GPT-6.1 Sol,以约七分之一的成本接近 Astra 水平;推出 500 美元 Pro 会员但砍削原有额度;Decisions API 直接对标刚发布的 Jev;Codex 全面升级云端可复用环境与安全扫描;以及 ChatGPT 订阅生态打通等。作者对 OpenAI 的定价策略和与 Claude Opus 5.5 的差距表达了看法。

技术 › OpenAI 数字生命卡兹克 2026-09-3019.9 KB 62K 379 70