Wiki 知识库

全部文档 / 标签: 论文解读

18 篇
清除

FDE-Gym 论文解读:AI 能否胜任 Forward Deployed Engineer 工作

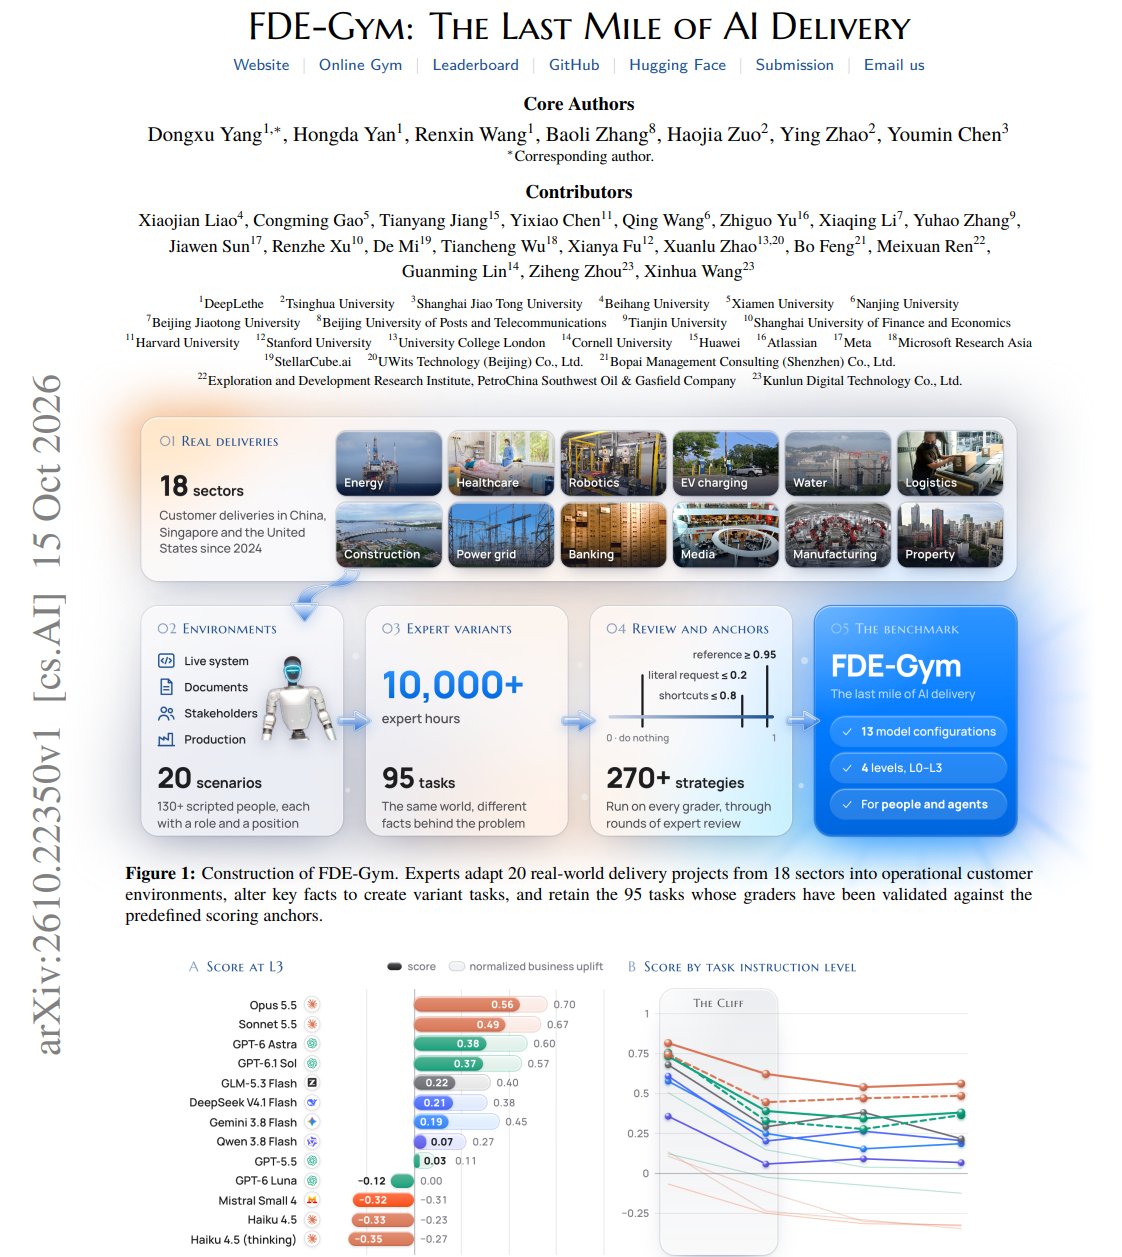
文章解读了一篇关于 FDE(Forward Deployed Engineer)的论文《FDE-Gym》。该论文将真实企业项目改造成覆盖金融、医疗、制造、能源等 18 个行业的 95 个任务,评测 AI Agent 承担真实企业交付工作的能力。Agent 仅获得客户最初的一句话需求,需自行读文档、查系统、确认信息并判断客户真正的问题。评分不仅要求完成需求,还要求交付系统真正改善业务指标,乱找人、反复试错都会产生成本。结果显示最强模型平均得分仅 0.56,95 个任务中仅真正解决 14 个,最大瓶颈在于未写入需求的业务规则、隐性约束以及客户未表达清楚的问题。文章指出 FDE 的难点在于在信息不完整、需求模糊的环境里判断该解决什么并真正交付。
技术 › Agent Xudong Han (@Xudong07452910) 2026-10-181.6 KB 65

APEX: Better generation from fewer tokens

APEX(Asynchronous Prefix denoising for EXtreme compression)由 Lightricks 与耶路撒冷希伯来大学联合研发,是一种面向扩散模型的极端潜空间压缩方法。它通过“结构到细节”的累积前缀表示,让少量潜token同时满足计算效率、重建质量和生成质量三个目标。该方法为潜通道分组排序,早期通道表达整体结构,后续通道逐步补充细节,并用异步去噪调度在不同时间窗内分别处理各组。在 ImageNet 512×512 实验中,APEX 在 64× 与 128× 空间压缩下显著提升生成效果,64-token 模型在推理预算相当的情况下全面优于 256-token 基线,为世界模型开发提供了高效表示设计原则。

技术 › LLM LTX.io 2026-10-1714.8 KB 1.4M 91 67

Agentic Economies:多智能体科学经济的瓶颈与制度设计

Google DeepMind 9 月发布的论文《Agentic Economies for Autonomous Scientific Discovery》主张,AI 科研的真正瓶颈不在想法生成而在资源有限的验证,需设计市场与制度解决协作、信用分配、问责与安全问题。AI 裁判 Pith 批评其核心论点与自引证据相悖且缺乏实证。产业侧 Molecule 的 Onchain Lab 已按论文要求施工。实验证据双向:Economy of Minds 的拍卖机制大幅提升 agent 任务表现,而另一实验显示仅有经济角色不会产生交易,需可验证的工作与权利。结论:经济制度的威力来自可验证性,而非价格标签。

技术 › Agent yibie 2026-10-146.3 KB 72

Jev-Mem: 无需 LLM 的记忆决策

文章介绍了 UT Dallas 的新论文 Jev-Mem,提出用 TypeSafe AI 的 Jev 模型替代通用 LLM 来处理 Agent 记忆系统中的小决策(如判断消息类型、记忆关联、检索终止等)。Jev 只返回结构化数值或标签,无需解析文本,通过 System One 轻量控制器与 System Two 生成式 LLM 的分工,显著提升效率。在 LoCoMo 基准上,答案质量相对最强基线提升 11%,构建速度快 6.6 倍,查询延迟降低 36.7%。文章也指出其局限:阈值依赖单一模型与基准、缺乏校准概率、消融实验不足,阈值在不同模型和数据分布下的泛化能力是最大隐患。

技术 › Agent mem0 2026-10-0811.6 KB 48K 516 77

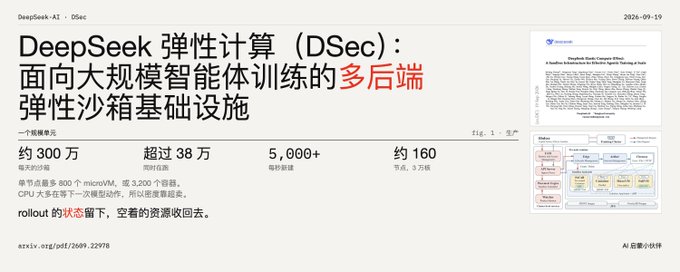
DeepSeek 弹性计算(DSec):面向大规模智能体训练的多后端弹性沙箱基础设施

本文解读 DeepSeek-AI 与清华大学合著的 DSec 论文,这是支撑 DeepSeek V3.2 到 V4.1 智能体 RL 训练的生产级沙箱基础设施。文章分析了智能体训练负载的七大特性(突发创建、CPU 稀疏、有状态长寿命、高度异构等),介绍了其无状态控制面、分层代理数据面架构,以及可组合环境分层、高密度内存管理、QoS 感知 CPU 调度、按需镜像加载四大核心机制。还深入阐述了 agent loop 与训练解耦、暂停恢复协同、防 reward hacking 的安全对抗实践。作者认为这标志着智能体能力竞赛正在演变为基础设施竞赛。

技术 › Agent meng shao 2026-09-2812.9 KB 4.8K 11 83

交税,还是被造反?经济学家的第三个选项

文章解读 Acemoglu 等人的论文《Automation and Reproduction》,该论文首次用经济学模型量化了面对自动化引发的社会动荡时,资本方的三种选择:管制、再分配与镇压。核心结论是:自动化与镇压是互补品——再分配是变动成本,随自动化程度上升而变贵;镇压是固定成本,相对越来越便宜。因此随着资本积累,代表资本利益的国家会从再分配转向镇压。模型还显示市场会过度自动化(因外部性),民主政体也面临政变临界税率。作者提出第四条出路:分散资本所有权,让工人持有资本,但这条路必须在再分配的窗口期内建立。

其他 › 杂谈 Chunyang (Simon) 2026-09-1615.7 KB 2.8K 5 78

Google提出EnvHarness:环境自进化,倒逼Agent持续进化

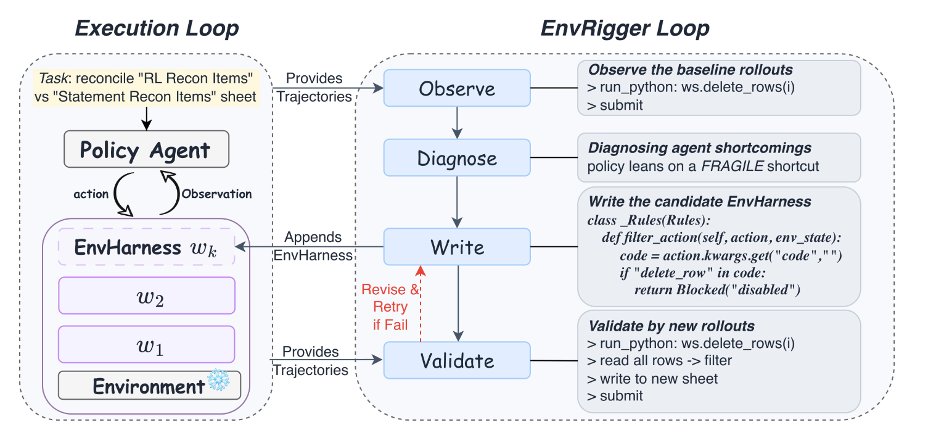
Google提出EnvHarness(环境脚手架)框架,通过Stage、Contract、Chain三类组件在不改动环境底层的情况下动态操控环境,并引入环境搭建师EnvRigger,通过观察Agent轨迹、诊断缺陷、编写组件、实战验证的四步闭环自动搭建环境。在SWE-bench Verified基准上,Agent与环境实现螺旋式协同进化,成功率从47.67%提升至54.79%,且300个环境时性能仍持续上升。未来方向包括扩展组件库、拓展至非文本环境及探索语义化组合。

技术 › Agent 青稞社区 2026-08-228.6 KB 4.8K 37 74

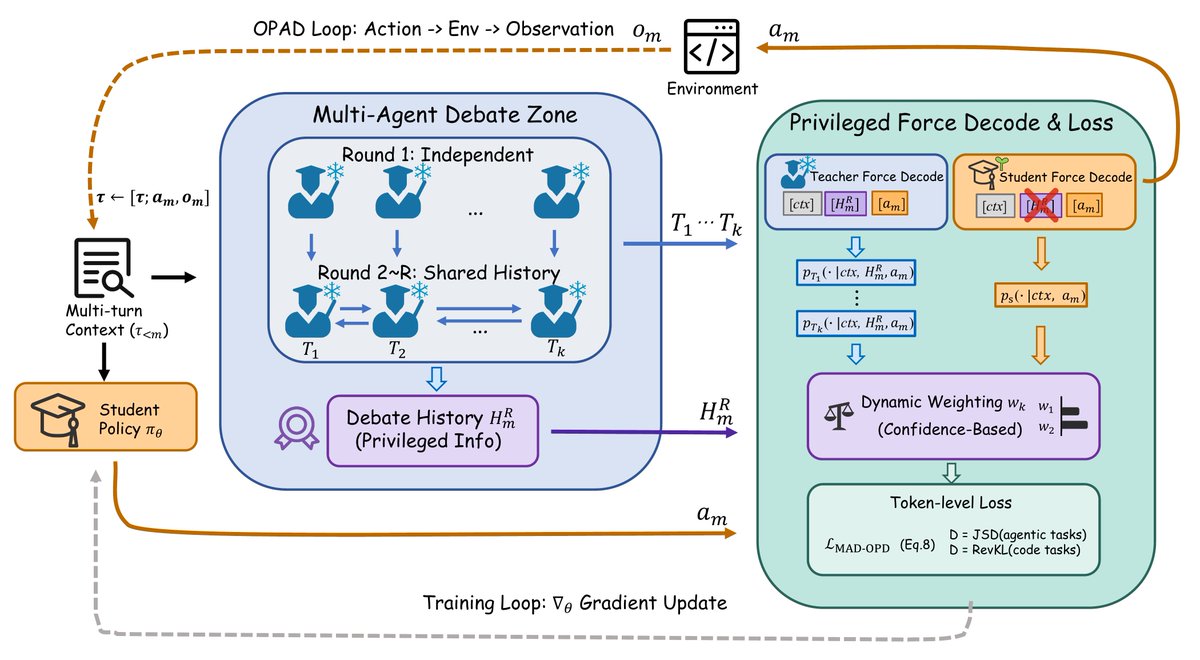
突破OPD天花板:MAD-OPD让小模型通过多教师辩论反超大模型

文章介绍了一种名为 MAD-OPD 的新算法,旨在解决 OPD(On-Policy Distillation)中单教师模型存在盲点导致学生模型学习受限的问题。通过引入多智能体辩论机制,让多个教师围绕学生状态互相纠错并达成共识,再进行蒸馏。实验表明,该方法在 14B+8B 到 4B 的蒸馏任务中,不仅提升了代码生成能力,还在 Agentic 任务中实现了小模型反超大教师的突破。

技术 › LLM 青稞社区 2026-07-136.6 KB 3.7K 22

Adam's Law:为何高频表达能解锁 LLM 的最强性能

文章介绍了 FaceMind 团队提出的 Adam's Law(文本频率定律),即在语义不变前提下,使用预训练语料中频率更高的表达方式能显著提升 LLM 表现。该发现通过 100 种语言和四大核心任务得到验证,并指出当前数据工程忽视了“频率”这一关键维度。Anthropic 的 Claude Opus 4.7 更新间接验证了这一理论。

技术 › LLM Berryxia.AI 2026-05-3018.7 KB 21.3K 57 89

何恺明和字节Seed跳到同一条河流:连续扩散语言模型的范式转移

文章深度解读了2026年5月何恺明MIT团队与字节Seed团队前后发布的两篇论文(ELF与Cola DLM)。两者殊途同归,挑战了主流的自回归(AR)生成范式,主张将语言模型的生成过程从“离散Token预测”转变为“连续空间的潜变量扩散”。这种“先思考后落字”的铅笔模式,不仅提升了效率与效果,更可能引发LLM底层架构、评估标准及多模态统一范式的新一轮变革。

技术 › LLM 花叔 2026-05-2522.2 KB 8.9K 25 72

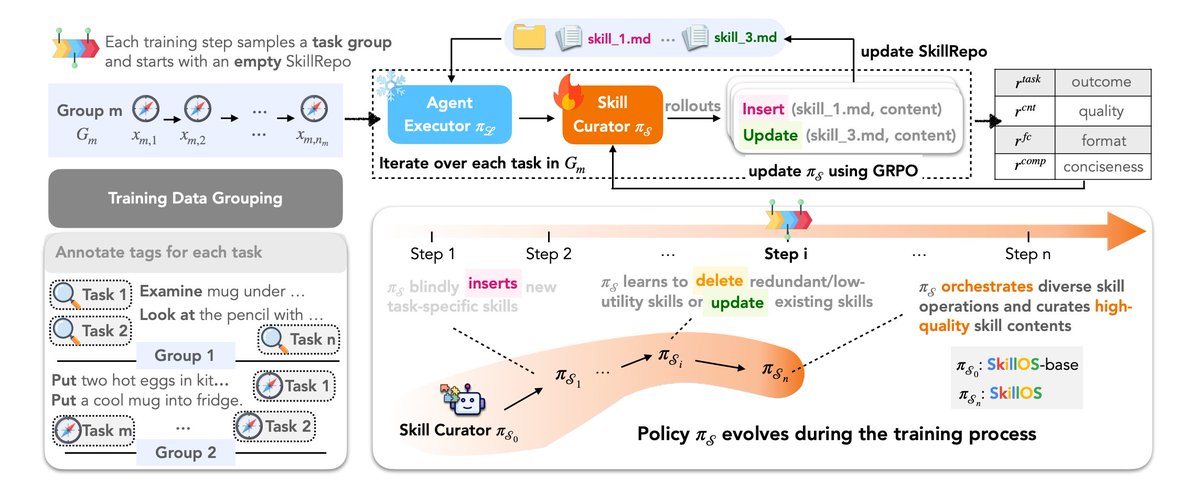
SkillOS 详解:自进化 Agent 的技能策展机制

文章详细解读了 Google 关于 SkillOS 的最新论文。SkillOS 是一个帮助 LLM Agent 通过管理可复用“技能”来实现自我进化的框架。该框架包含一个冻结的 Agent Executor 和一个可训练的 Skill Curator,后者利用强化学习(RL)从执行轨迹中自动提取、更新或删除技能,从而实现从经验到技能的转化。

技术 › Agent AVB 2026-05-1215.3 KB 51.5K 505 79

OpenAI 论文解读:VPT 视频预训练模型

文章介绍了 OpenAI 的 VPT(Video PreTraining)论文,该研究通过训练反向动力学模型(IDM)为海量无标注互联网视频打上伪标签,成功让 AI 智能体在 Minecraft 中学会了制作钻石镐等复杂任务。文章详细阐述了 VPT 的“少量标注撬动海量数据”的技术路线、三阶段训练过程以及其带来的数据杠杆效应,并探讨了该方法从游戏向机器人控制迁移的潜力和局限性。

技术 › OpenAI Mr Panda 2026-05-0613.1 KB 2.2K 7 85

DeepSeek新论文解读:用“手指着图片思考”的多模态推理框架

DeepSeek发布新论文,提出一种名为“视觉原语”的多模态推理框架。不同于业界卷分辨率的趋势,该模型通过在思维链中嵌入边界框和坐标点,模拟人类用手指着图片思考的过程,有效解决了语言在空间指代上的局限。DeepSeek-ViT配合LLM将视觉Token压缩至竞品的十分之一,但在空间推理、计数和迷宫导航等任务上性能超越GPT-5.4等顶尖模型。

技术 › LLM 向 向阳乔木 2026-05-0135.7 KB 53.8K 56 80

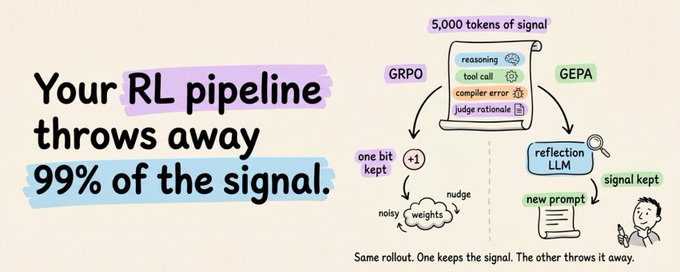
无需更新权重的 GRPO 替代方案:GEPA 算法解析

文章介绍了 Berkeley 团队提出的 GEPA 算法,该算法作为 GRPO 的替代方案,无需更新模型权重或进行 GPU 训练,仅通过优化提示词(Prompt)即可在 HotpotQA 等基准测试中取得更优成绩。GEPA 的核心在于利用 LLM 读取完整的推理轨迹,通过自然语言反思来迭代优化多模块系统中的每个提示词,从而避免了强化学习中将丰富信息压缩为单一标量信号的信息损耗问题。

技术 › LLM Akshay 2026-05-0113.7 KB 272.4K 371 83

Memory Transfer Learning for Coding Agents 技术解析

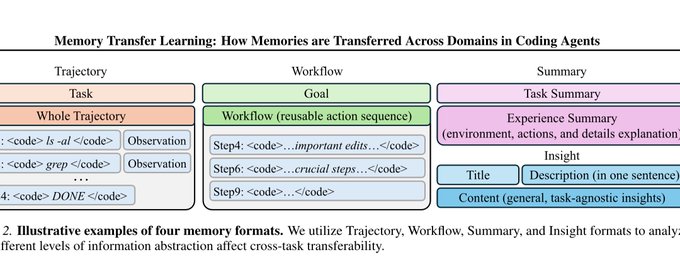
本文深入探讨了一篇关于编码智能体的 Memory Transfer Learning (MTL) 论文。文章解释了如何将过往编码任务的“记忆”复用到新任务中,比较了 Trajectory、Workflow、Summary 和 Insight 四种记忆格式的效果。研究通过在多个基准测试中复用异构记忆池,证明了提取的元知识能有效提升智能体解决新问题的能力。

技术 › Agent AVB 2026-04-2124.5 KB 8.7K 162 80

Google Deepmind论文解读:如何给AI Agent 投毒

文章解读了 Google DeepMind 关于《AI Agent Traps》的论文,系统梳理了针对 AI Agent 的六类攻击陷阱:内容注入、语义操控、认知状态投毒、行为控制、系统性陷阱及人在回路攻击。文章指出,Agent 与人类感知的“鸿沟”使其极易遭受环境篡改攻击,且这些陷阱可组合叠加,造成严重的数据泄露或控制风险。防御需从训练与推理的技术层面同时发力。

技术 › Agent 向 向阳乔木 2026-04-2020.3 KB 65.2K 245 83

LLM 工程师必读的 12 篇研究论文

文章列出了每位 LLM 工程师必须阅读的 12 篇核心论文清单,涵盖了从 Transformer 架构、BERT、GPT-3 等基础模型,到扩展定律、Chinchilla 训练法则、RLHF 对齐技术,以及 LoRA 高效微调和 FlashAttention 等工程优化技术。这些论文构成了现代大模型理解、训练和部署的理论基石。

技术 › LLM Amit Shekhar 2026-04-187.5 KB 236.4K 1.3K 39