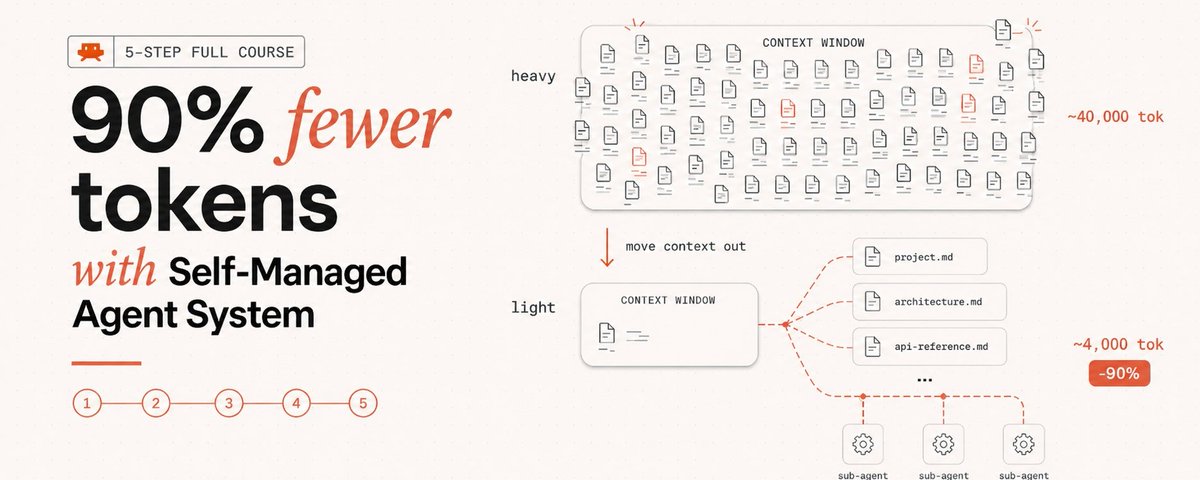
5步构建低Token消耗的自治Agent系统
文章介绍了构建消耗Token减少90%的自管理Agent系统的五个步骤:将上下文移出窗口、使用子代理处理脏活、利用自管理内存、避免破坏缓存以及手动管理上下文。强调了通过优化上下文管理和缓存机制来降低成本和提升效率的重要性。
文章介绍了构建消耗Token减少90%的自管理Agent系统的五个步骤:将上下文移出窗口、使用子代理处理脏活、利用自管理内存、避免破坏缓存以及手动管理上下文。强调了通过优化上下文管理和缓存机制来降低成本和提升效率的重要性。
本文通过本地实验与源码分析,深入解析了大模型的 KV 缓存机制。作者从 Transformer 注意力机制讲起,解释了为何多轮对话会出现 100 倍的加速差异。通过逆向 Claude Code,揭示了 Anthropic 精密的缓存工程策略(前缀匹配、TTL 机制)。最后,给出了具体的 Claude Code 使用姿势(如保护缓存前缀、避免切换模型),帮助用户将 Token 消耗降低 80%,实现同样的套餐多干 3-5 倍的活。
文章通过本地 Gemma4 实验发现大模型对话中存在 100 倍加速的现象,深入剖析了 Transformer 的 KV 缓存原理,并逆向分析了 Claude Code 的精密缓存工程。文章解释了为何连续对话比频繁开启新 Session 更省钱,指出破坏缓存的关键行为(如切换模型、修改 System Prompt),并提供了保护缓存以节省 80% Token 的具体使用姿势。
文章深入分析了 Claude Code CLI 的源码架构,揭示了 Anthropic 实现“无限长对话”背后的技术秘密。核心包括:1. Prompt 两层缓存设计(全局静态+会话动态),大幅降低 Token 成本;2. 四层递进的 Compact 架构,从增量删除(Cache Edits)到全量摘要,确保语义完整;3. Proactive 模式与终端焦点感知,实现 Agent 自主协作;4. 内外版 Prompt 差异(ant 分支)。
文章深入剖析了 Claude Code(CC)的源码设计,总结了其背后的 20 个核心理念,包括“缓存命中率”优化、上下文复用、多层记忆机制及严格的安全校验。作者指出 CC 不仅是聊天工具,而是“智能执行内核”或“模型操作系统”。此外,文章还分享了 Vibe Coding 的 12 个真相,强调 AI 调度的本质在于约束与任务拆分,而非简单的自由生成,指出用户应掌握判断与工程表达能力,将 AI 作为高效的生产力辅助。