Wiki 知识库

全部文档 / 标签: 成本优化

73 篇
清除

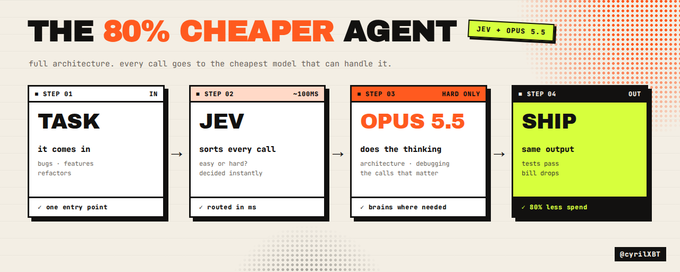
如何构建成本降低 80% 的编码 Agent:Jev + Opus 5.5 完整架构

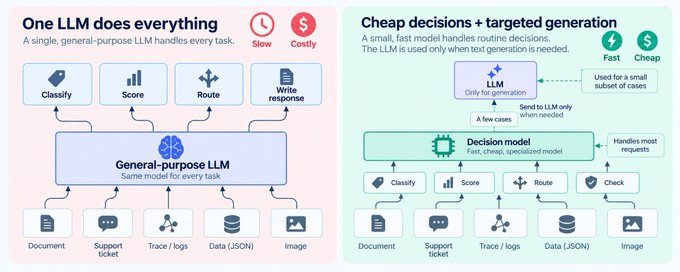
文章指出当前编码 Agent 在简单决策(如选择加载哪些笔记、任务路由、工具失败处理、测试优先级)上滥用昂贵的前沿大模型,造成成本浪费。作者提出三层架构:Opus 5.5 负责规划、写代码、调试等开放性推理;Jev(TypeSafe 出品,毫秒级响应、输入 $0.042/百万 token、输出免费)负责从固定选项中做小决策并返回概率;Harness 层构建选项、校验概率阈值并在低置信度时回退到 Opus。文章给出四个具体决策点及代码实现:按标题分块并用 Jev 并行评分筛选相关笔记(将 30k token 降至 6k)、任务路由、工具失败处理、测试优先级选择。实测一个功能开发会话成本从 $6.42 降至 $2.00,降低 69%,且架构可作为函数调用插入现有 Agent 循环,无需重写。

技术 › Agent CyrilXBT 2026-10-2626.0 KB 515.7K 385 87

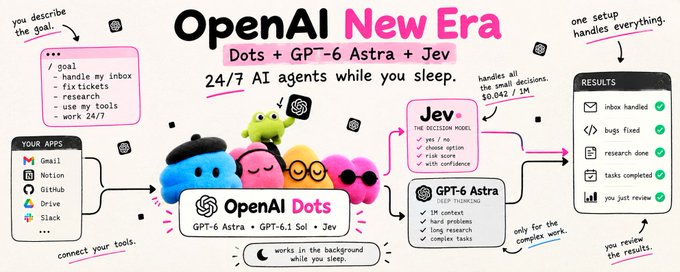
OpenAI Dots: 7x24小时运行GPT-6 Astra,成为只做监督的独立开发者完整指南

文章介绍如何在OpenAI发布Dots常驻Agent和GPT-6 Astra(百万token记忆)后,搭建一个24/7自主运行的AI工作流。核心难题是常驻Agent会高频产生大量简单决策,用前沿模型成本高昂。解决方案是TypeSafe推出的System One模型Jev:它只能输出结构化决策(是/否、选择、评分)并附带置信度,单价仅$0.042/百万token,使百万次决策成本约$42。文章展示了将Jev作为低层决策器、Astra作为高阶思考引擎的组合架构,让独立开发者从写代码转变为定义任务、设限并审核产出的监督者角色。

技术 › Agent Noisy 2026-10-2616.3 KB 554.5K 270 81

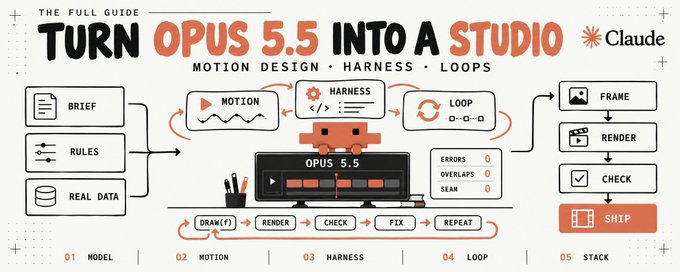
如何把 Opus 5.5 变成工作室:动效设计、Harness 与循环的完整指南

文章介绍了 Anthropic 发布的 Claude Opus 5.5 模型,其性能达到 Fable 5.1 水平但运行成本低 40%,尤其在长时间自主任务中表现突出。作者指出动效设计、Harness 工程和循环工程三者实为一个完整技术栈,并以五部分结构展开讲解:模型本身的基准数据与定价、如何用它做纯代码驱动的动效/动画创作、让输出可靠化的 Harness 工程、让 Agent 持续自主工作的循环机制,以及如何用单个模型串联整个工作流。文章强调缓存读取降价 60% 使长循环成本可控,并列举了大规模代码迁移、翻译 HAProxy 等实际案例。

技术 › LLM NO1ennn 2026-10-2638.3 KB 848.7K 561 84

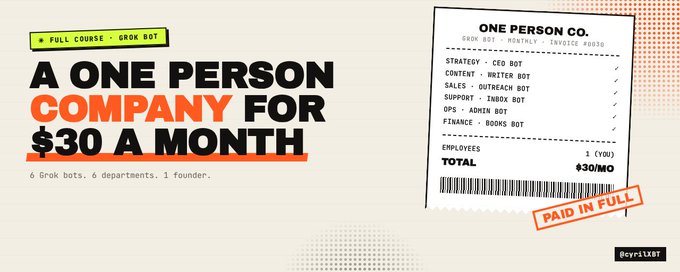
How to Run a One Person Company on Grok Bot for $30 a Month (full Course)

本文详细介绍如何利用Grok Bot(SpaceXAI的代理产品)以每月30美元的成本运营单人公司,替代传统8人团队的大部分重复性工作。作者提供了完整课程,包括创建公司手册、设置Chief of Staff Bot协调多个专业机器人(研究、内容、销售、支持、财务、开发),并建立审批规则确保安全。核心方法是将决策权保留给人类,将重复性任务分配给AI代理,通过每日和每周节奏管理整个公司,同时控制成本在预算内。

技术 › Agent CyrilXBT 2026-10-2624.1 KB 263.2K 226 81

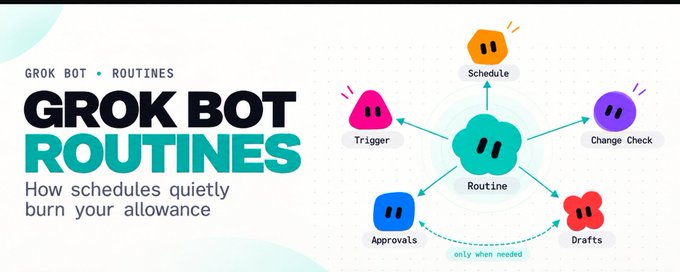
Grok Bot 定时任务每5分钟运行的成本是每小时12倍(完整教程)

文章详细讲解了 Grok Bot 定时任务(routines)的成本优化之道。每5分钟运行一次的任务每月唤醒8640次,按 Grok 4.6 API 费率计算约花费400美元,而每小时运行仅需33美元。作者强调成本取决于调度频率而非模型选择,并提出核心优化策略:优先使用事件触发而非轮询、选择任务可接受的最慢调度频率、在高频任务前加入低成本的"是否有变化"检查(可降低89%成本)、避免夜间任务等待审批导致失败、以及自行维护运行日志(因为应用仅保留20条记录)。文末附有可直接使用的提示词模板。

技术 › Agent Gipp 2026-10-1715.4 KB 1.3M 535 91

AI 产品中的 Router 设计:意图路由的原理与实践

文章系统阐述了 AI 产品中 router(路由)的设计方法。Router 是产品调度台,决定用户请求进入哪个能力模块、走什么流程、承担什么成本。作者强调意图边界应由产品能力而非用户 query 归纳决定,建议采用'两级意图 + 槽位'的分层结构。在实现上,推荐规则、小模型、大模型三层配合:规则处理确定性请求,小模型处理高频语义分类,大模型处理复杂混合意图。此外,文章讨论了路由迭代的关键指标(准确率、任务成功率、fallback 率、人工改派率等)以及 token、延时与准确率之间的平衡策略,如精简 prompt、结构化输出、安全前置和结果缓存。

技术 › Agent 卡夫卡 (@kafkaup) 2026-10-155.7 KB 83

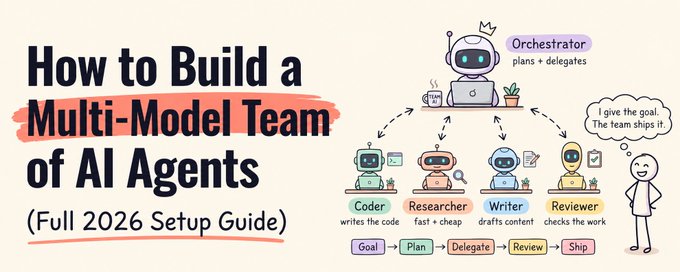
How to Build a Multi-Model Team of AI Agents in 2026

本文介绍 2026 年构建多模型 AI Agent 团队的完整方法。作者指出使用单一模型会导致高成本低效、专业能力受限以及单供应商故障/盲点风险,主张按任务步骤选择合适模型。文章梳理了 2026 年 9 月的主流模型阵容(Claude Opus/Sonnet/Haiku/Fable 5.1、GPT-6 Astra、TypeSafe Jev)及定价,提出五层架构:路由器、编排器、专家模型、评审者(critic)和纯代码层,并讲解如何先对工作负载分类(决策、简单生成、真实工作、难题),再为每层选择最划算的模型。文中附有统一封装多供应商 API 的示例代码,涵盖 effort 参数与 thinking block 处理细节。

技术 › Agent Khairallah AL-Awady 2026-10-1020.4 KB 50.3K 119 86

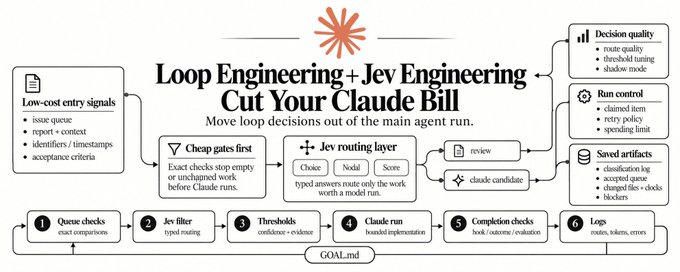
Loop Engineering + Jev Engineering: Cut Your Claude Bill

本文介绍如何通过'循环工程'降低 Claude 自动化的 token 开销:将队列检查、重复判断等高频决策从主对话中剥离,交由专用代码路径和 TypeSafe AI 的决策模型 Jev 处理。Jev 提供 Choice、Noul、Score 三种类型化问题原语,返回带概率的结构化答案,成本低至每百万输入 token $0.042。文章以 issue 分类过滤为例,给出完整的 Python SDK 实战代码,展示如何构建可检查、可扩展的任务路由过滤器,让 Claude 专注于实现工作,应用代码控制任务流转。

技术 › Claude beamnxw 2026-10-0820.6 KB 728.9K 376 82

GPT-6 怎么选:模型与推理级别的实用指南

本文基于 OpenAI 官方文档,讲解如何为 GPT-6 选择模型与推理级别以节省订阅额度。模型决定基础能力、速度和成本:Luna 适合轻量重复任务,Sol 适合日常主力工作,Astra 用于最难的端到端任务。推理级别决定模型思考投入:Light/Low 适合简单明确任务,Medium 适合普通复杂任务,High 和 Extra High/Max 适合复杂调试与研究,Ultra 用于并行处理可拆分任务。作者建议从最低档起步,根据遗漏和返工情况逐步升级或降档,并强调档位不能替代清晰目标和验收标准。

技术 › OpenAI Mr Panda 2026-10-084.1 KB 5.5K 1 77

How to Build a Model Router in the Harness

文章介绍 LangChain 如何为开源编码代理 Open SWE 构建模型路由器。作者首先通过 LangSmith 追踪数据分析任务类型与复杂度分布,发现许多任务无需前沿级模型;随后基于 Artificial Analysis 智能指数挑选快速、均衡、高性能三档模型(GLM-5.3-Flash、GPT-5.6 Sol、GPT-6 Astra);最后在 agent harness 的中间件层实现路由器,由分类模型根据任务标准选择最便宜可胜任的模型。结果显示每线程成本中位数降低 64%,质量无明显变化。文章强调路由决策应置于 harness 中,因其拥有网关所缺乏的任务与领域上下文。

技术 › LLM Sydney Runkle 2026-10-0221.4 KB 112.7K 324 83

GPT-6 Astra、Sol、Luna使用手册:官方资料到实操

文章介绍OpenAI发布的GPT-6 Sol和Luna模型,讲解如何按任务类型选择模型和推理强度:Astra适合高难度重要任务,Sol平衡能力与成本,Luna适合明确、重复的批量任务。文章详细分析了各模型的定价、事实性表现、编程能力评测,并强调真实成本不能只看每百万Token单价,还需考虑返工和沟通轮数。同时介绍了提示词缓存机制的原理和使用技巧,包括前缀稳定性、显式缓存断点设置等,最后给出Codex普通用户和API开发者的具体实操建议与代码示例。

技术 › OpenAI 苏乐 2026-09-2831.5 KB 56.9K 202 85

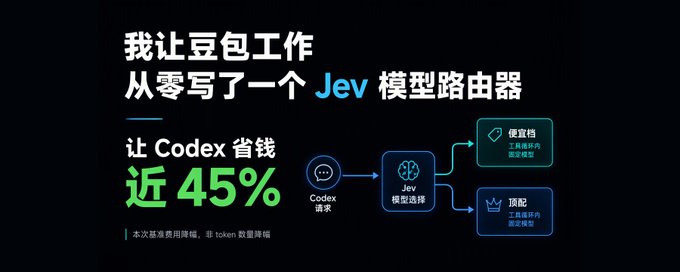
我让豆包工作从零写了一个 Jev 模型路由器,让 Codex 省钱近 45%

作者针对 Codex 账单越来越贵的问题,利用 TypeSafe AI 的 Jev 模型(只做带概率的判断、成本极低)搭建了一个外部模型路由器 HippoRoute-Jev-Codex,仅在线程首请求、新用户轮次、压缩检查点、子 agent 首请求四个缓存重建时机选模型,其余工具循环沿用钉住的模型,避免打掉 prompt 缓存。整个项目由豆包工作通过计划模式和目标模式从零完成,作者全程仅操作四次、未看一行代码,最终 76 个测试全通过并自行揪出 3 个 bug。实测机械任务省 95.4%,子 agent 场景省 79.7%,整体省 44.8%,且任务通过率无差别。

技术 › Codex huangserva 2026-09-2417.9 KB 82K 80 81

How to use Jev for GTM Automation (Step-by-step guide)

本文介绍 TypeSafe AI 推出的 Jev 模型,它专为校准决策设计,输出概率而非文本。Jev 针对传统 LLM 过度自信、成本高、速度慢的问题,通过三种问题类型(Choice、Noul、Score)返回带置信度的概率结果,开发者可基于置信度阈值设置自动化护栏,实现无人值守运行。作者结合 treg 数据服务,展示了 Jev 在 GTM 自动化中的实战应用,包括欺诈检测与注册用户资格审核(每日 236 个注册仅花费约 $1.21)、以及购买信号分类等场景,并分享了编写评分规则(rubrics)而非传统 prompt 的使用技巧,成本远低于通用聊天模型。

技术 › LLM Jason Zhou 2026-09-2210.6 KB 64.8K 231 82

零字废话|Jev 接入Grok Bot 方法及使用场景

文章介绍了如何将 TypeSafe 的轻量分类模型 Jev 接入 Grok Bot:包括申请 API Key、通过安全卡片保存密钥、安装 SDK 并测试调用,最后将流程保存为 Skill 复用。作者强调并非工具越多越好,在自己早期游戏项目中接入 Jev 属于负优化,并给出两个适合的场景:一是 Bot 挂载 Skill 过多时让 Jev 先筛候选(官方测试错误率从16.8%降至7.3%),二是搜索结果排序(正确段落进入前十比例从38%提升到62%)。最后建议判断标准是:多接一个模型到底改变了什么。

技术 › Agent 刘屿之外 2026-09-217.5 KB 27.3K 65 80

全网刷屏的 Jev 到底怎么用?8 个能直接抄的案例

本文介绍了 AI 圈新火的模型 Jev——一个不做文本生成、只返回带概率判断的决策模型。文章讲清了它的三种用法(是非判断、选项选择、打分),提供了四种 30 分钟内可上手的接入方式(官方 Skill、Vercel、OpenRouter、SDK),并整理了 8 个可直接复用的真实案例:7 秒订机票、代码审查、工单分流、简历初筛、语义搜索、AI Agent 路由、RAG 重排、动态 UI 拼装等。还总结了 5 个反直觉要点(不写字、零幻觉指格式而非正确性、不会拒绝等)、官方自曝的雷区(不会算术、不懂日期先后、易被提示词注入),以及不适合使用的场景。

技术 › LLM Leaf Yeah! 2026-09-2016.8 KB 131.8K 279 86

一文解密 Jev:一个不聊天的模型,为什么突然火了?

TypeSafe AI 于2026年9月发布的 Jev 是一个不做对话和内容生成的专用判断模型,主打低成本、高速度地解决软件中的小型理解判断任务,如工单分类、优先级评分和概率判断,提供 Choice、Score、Noul 三种能力。其极低价格(每百万输入token 0.042美元)和 Vercel、Netlify 的快速接入引发开发者关注。文章分析了其'零幻觉'宣传的真实含义、评测数字的适用边界,并指出 Jev 的价值在于与生成式模型、程序和人分工协作,让软件能以低成本读懂小问题。

技术 › LLM Ray Wang 2026-09-1913.2 KB 19.4K 96 78

Will TypeSafe's Jev change how we build AI applications?

文章分析了 TypeSafe 发布的新模型 Jev——一种只能做分类、评分和路由决策、不能生成文本的'System One'模型。Jev 比通用 LLM 快 40-200 倍、便宜 40-400 倍,通过 RLCD 训练方法实现零样本概率判断。早期独立测试显示其准确率接近 GPT-5.6 等大模型,垃圾邮件分类甚至可媲美有标注训练的分类器。代价是失去了解释能力,无法说明判断理由。作者认为这可能改变 AI 应用架构:用 Jev 做大规模廉价监控评估,用 LLM 判官处理少量样本以获取改进方向信号。

技术 › LLM Aparna Dhinakaran 2026-09-1912.8 KB 15.2K 202 78

Jev Engineering: 从零搭建 AI 系统 1 决策模型的 10 步完整路线图

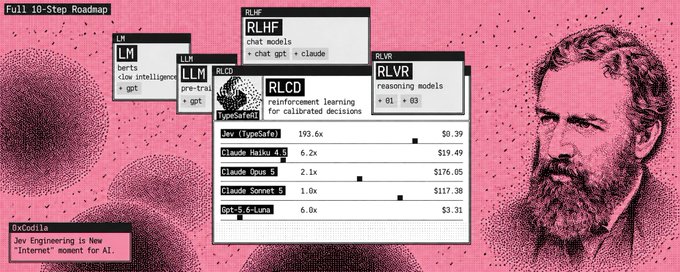
本文介绍 TypeSafe AI 推出的 System One 决策模型 Jev,其理念源自杰文斯悖论——通过分离 Agent 中的小型判断决策,降低成本并提升效率。文章以 10 步路线图讲解如何从零搭建和使用 Jev:识别 Agent 中可交由 Jev 接管的决策点、在 Playground 中测试单一决策、配置 API 与 Python SDK、编写 chief.py 脚本将请求转化为带置信度的任务分发文件(handoff),并存入本地任务队列供后续 Worker 消费。文中还展示了 Browser Use 结合 Jev 后 7 秒、$0.0039 完成机票搜索的案例。

技术 › Agent codila 2026-09-1922.9 KB 2.2M 3.5K 75

Jev 怎么用:三种提问原语与分层阈值

文章系统讲解了 TypeSafe 的 Jev 决策模型的使用方法。Jev 接收非结构化状态和问题,返回类型安全的答案、概率分布和置信度,提供三种提问原语:Noul(是/否判断)、Choice(选项挑选)、Score(档位评分)。文章介绍五条上手路径(Playground、HTTP API、Python SDK、Agent Skill、开源适配器),并总结提问技巧:一个问题只问一个判断、多因素拆开加权、档位写具体情形而非程度、一次问满并行问题以节省成本。置信度使用上推荐按风险分层设置阈值的三段式策略。文末讨论成本速度、边界限制及社区应用场景,并介绍了开源替代 OpenJev。

技术 › LLM yibie 2026-09-1812.9 KB 80.6K 605 88

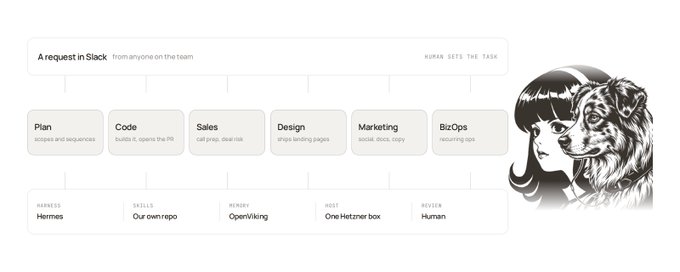
How we built Hermes to support our entire team

Artie 团队(17人)分享了如何将 Hermes——NousResearch 的开源 AI agent harness——部署为全团队共享的 AI 助手。文章讲述了从工程师个人 WhatsApp 使用的起步,到选择 Hermes 而非 OpenClaw 并加入护栏的决策;用每年 60 美元的 Hetzner 物理服务器承载全部运行。团队为每个部门设计了独立 profile:工程(Plan 分派任务、Code 执行开 PR)、销售、设计、BizOps 等,并强调人类始终在环节中审核。Skills 以代码形式版本化进 Git 仓库,严控数量以省 token。受人类 REM 睡眠启发,Hermes 每晚'做梦'复盘当日工作,将有价值内容晋升到长期记忆。

技术 › Hermes Jacqueline Cheong 2026-09-1711.3 KB 208.7K 1K 84

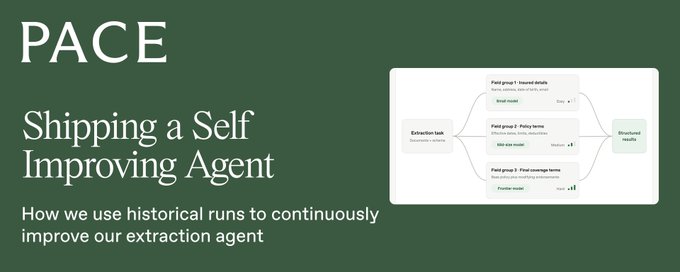
Shipping a Self-Improving Agent

文章介绍 Pace 公司如何在其保险文档提取 Agent 中实现自我改进。系统通过三个核心机制优化:1) 子代理委派——基于历史运行构建字段关系图,优化 fanout 分组,减少重复工作,降低 19% 成本和 16% 延迟;2) 模型路由——利用历史 trace 学习各子代理任务难度,将子任务路由到合适模型,部分场景成本降低 68% 且无精度损失;3) 上下文优化——通过 Review Agent 诊断错误根因、Proposer Agent 提出经验证的上下文或 Harness 修复,使每流程提取错误减少 75%。核心论点是随任务积累,系统可持续逼近最优的委派、模型与上下文组合。

技术 › Agent Arun J Moorthy 2026-09-169.0 KB 11.2K 156 77

如何在一张 GPU 上服务 100 个微调模型

文章介绍如何在单张 GPU 上高效服务大量 LoRA 微调模型。将适配器合并进基座会为每个变体生成 15.2GB 的完整模型副本,而分开保存适配器只需约 40MB,共享基座后 100 个变体仅占 19.3GB。作者对比了四种部署形态(合并独立 endpoint、启动时注册、请求时解析、托管按租户),并在 Runpod 上用 Qwen 1.5B 训练三个 LoRA 适配器做实验。结果显示共享 endpoint 复用 worker 池,显著减少冷启动与显存浪费;同时强调应分开记录等待时间与执行时间,并通过镜像缓存优化冷启动延迟。

技术 › LLM yibie 2026-09-1611.8 KB 5.4K 38 86

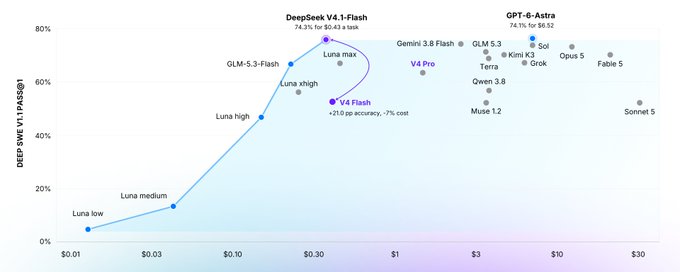
DeepSeek-V4.1-Flash on Fireworks: Astra-level DeepSWE at 1/15th the cost

Fireworks 发布的 DeepSeek-V4.1-Flash 在 DeepSWE 基准测试中以每任务 $0.43 的成本达到 GPT-6 Astra 级别的编码准确率,价格仅为 1/15。该模型采用 552B MoE 编码器-解码器分离激活架构(输入 8B、输出 16B 活跃参数),配合 KV Cache 优化(HBM 占用降至 1/4),在 Terminal-Bench 2.1 上以 12x 更低成本逼近 Astra。但在 HLE 学术推理上落后于 Astra;oracle 路由测试显示两模型组合可超越 Astra 单模型表现,凸显多模型路由系统的价值。

技术 › LLM Fireworks 2026-09-169.1 KB 24.1K 200 75

Put Claude Fable 5.1 and Gemini 3.8 Flash on the same team

本文介绍如何在 Google Cloud 的 Gemini Enterprise Agent Platform 上同时配置 Anthropic Claude Fable 5.1 与 Google Gemini 3.8 Flash 两款模型,并通过任务路由优化 token 成本(tokenomics)。作者指出单一模型路由全部任务是错误的:深度规划模型处理日常事务会浪费成本,而快速模型处理不可逆的复杂任务风险很大。文章详细演示了启用 Claude Fable 5.1 所需的数据共享配置(setPublisherModelConfig API)、Gemini 3.8 Flash 的调用方式,并建议先对常规任务做基准测试,以快速模型作为一线协调者、深度规划模型按需升级处理,从而大幅提升任务 ROI。

技术 › LLM Alan Blount (Google Cloud Tech) 2026-09-1518.4 KB 161.7K 894 82

BestBlogs 早报 · 09-12|开放权重模型降成本,HL-Mem 治理记忆,AI 使用心得重组 B 端需求协作

本期早报围绕 AI 落地的三个层面展开:先测量成本,再管理状态,最后明确责任。精讲一介绍 Uber、Pinterest、AT&T 通过开放权重模型、模型路由和基准测试,将单次请求成本降低 34%、会话成本降低 52% 的实践。精讲二解析大淘宝技术的 HL-Mem 系统,通过 Event 与 Claim 分离、双时间模型和显式遗忘机制,解决 Agent 长期记忆的证据、时间与冲突治理问题。精讲三分享京东技术的 B 端产品实践,把工作组织为 Prompt、Context、Harness 三层,AI 负责整理与生成,人负责业务判断与责任,使 34 人日工作压缩至 15 人日。速览还涵盖多智能体最佳实践、OpenAI 存储架构、AI 评估管道等内容。

技术 › LLM ginobefun 2026-09-1222.2 KB 3.8K 1 80

Why I open-sourced my software factory

作者维护开源软件工厂 OpenInspect,解释为何开源而非商业化销售。他认为软件工厂是将信号(issue、Slack 消息等)转化为成果(PR、修复、答案)的 AI Agent 基础设施。将其作为产品出售困难重重:沙箱和模型推理等核心组件已被商品化,各组织需求差异大。真正的价值在于组织流程——代理路由、知识分发、系统改进、成本优化和 Token 支出的 ROI 归因,这些都需要与公司组织结构深度匹配。作者曾为 10 到 500 人规模的团队部署此类系统,认为软件工厂会成为关键基础设施,应由企业自持,因此选择开源以让团队专注于组织层面的问题。

技术 › Agent cole murray 2026-09-128.1 KB 302.5K 1.2K 67

BestBlogs 早报:架构师 Agent、经济未来与 RLM 长上下文

本期早报精讲三篇文章:架构师 Agent 如何通过领域知识结构解决存量系统中的工程判断问题;Anthropic 经济情景探索器从任务视角分析 AI 对就业和增长的多情景影响;RLM 递归语言模型将长上下文转化为可执行状态,提升复杂任务准确率。速览涵盖 Agent 断点续传、OpenAI 数学争议、Codex 访谈、AI 编程成本、ADK for Kotlin、机器人触觉及 Kimi K3 流式加载等话题。

技术 › Agent ginobefun 2026-09-1022.3 KB 3.7K 3 76

一文带你看懂GPT-6 Astra推理等级怎么选才最省Token

文章介绍了GPT-6 Astra的推理强度等级(Reasoning Effort)机制,澄清了常见误区:推理等级不是不同级别的模型,而是同一个模型被分配的思考预算。Ultra档位也非更聪明,而是会启动多智能体协作,类似成立专项工作组,因此消耗更大。作者建议推理等级应与任务难度匹配:Plus用户日常用"中",稍难任务用"高";Pro用户可"高"常驻,复杂任务先用"最高"+计划模式做规划,再用"高"执行,这是最省Token的方式。"极高"档位定位尴尬,Ultra则适合额度重置前清空余额时使用。

技术 › OpenAI 数字生命卡兹克 2026-09-0910.7 KB 116.2K 498 75

Reducing cost and improving performance with Claude Platform

本文介绍如何通过三项优化在不牺牲性能的前提下降低 Claude 应用的成本:最大化 prompt cache 命中率、清理迁移到前沿模型后的提示词反模式、以及按任务校准 effort 设置。文章详细讲解了 prompt cache 的工作机制(KV 缓存、字节级前缀匹配、TTL 限制),给出监控缓存命中率、延迟加载少用工具、以消息形式更新系统提示、预加热缓存等实践技巧;同时列举了验证仪式、过度强调、过时示例、矛盾规则等反模式及其修复方法,并介绍了 claude-api skill 中的 prompt-audit 命令帮助自动检测问题。

技术 › Claude ClaudeDevs 2026-09-0921.3 KB 571.4K 4K 91

Developers Guide to using fewer Gemini Tokens with your Agents

本文介绍如何通过上下文压缩代理 headroom 减少 Agent 调用 Gemini 模型时的 token 消耗。作者指出 agent 上下文中大部分 token 来自工具输出的冗余 JSON、日志和搜索结果,而非精心设计的提示词。通过在 Gemini 3.8 Flash 前部署 headroom 代理,在四种生产级 agent 工作负载测试中,prompt token 减少 76%,任务准确率保持 100%,首 token 时间有所改善,建模成本下降约 70%。文章同时诚实探讨了压缩的有损性:压缩器保留模式、分布和异常值,但会丢弃普通记录,模型在数据缺失时会拒绝编造。项目开源且可复现。

技术 › Agent Alan Blount 2026-09-0912.1 KB 43.8K 391 87