Wiki 知识库

全部文档 / 标签: 上下文管理

116 篇
清除

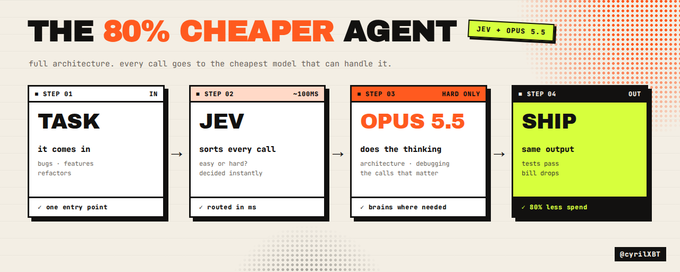
如何构建成本降低 80% 的编码 Agent:Jev + Opus 5.5 完整架构

文章指出当前编码 Agent 在简单决策(如选择加载哪些笔记、任务路由、工具失败处理、测试优先级)上滥用昂贵的前沿大模型,造成成本浪费。作者提出三层架构:Opus 5.5 负责规划、写代码、调试等开放性推理;Jev(TypeSafe 出品,毫秒级响应、输入 $0.042/百万 token、输出免费)负责从固定选项中做小决策并返回概率;Harness 层构建选项、校验概率阈值并在低置信度时回退到 Opus。文章给出四个具体决策点及代码实现:按标题分块并用 Jev 并行评分筛选相关笔记(将 30k token 降至 6k)、任务路由、工具失败处理、测试优先级选择。实测一个功能开发会话成本从 $6.42 降至 $2.00,降低 69%,且架构可作为函数调用插入现有 Agent 循环,无需重写。

技术 › Agent CyrilXBT 2026-10-2626.0 KB 515.7K 385 87

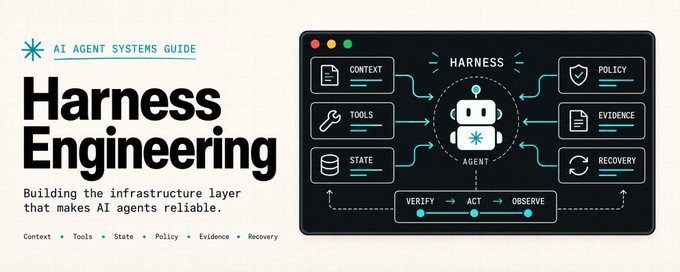
Harness Engineering: How to Build AI Agents That Actually Work

文章指出大多数人在错误的层面修复 AI Agent 问题:模型失败时反复改提示词、换模型、加工具,却忽略了真正的问题是模型周围的环境——Harness。Harness Engineering 是构建围绕模型的系统,决定模型能看到什么、能做什么、记住什么、如何判定成功与失败。作者提出六大实践:将请求转化为带完成条件的任务契约;用渐进式披露提供项目地图而非塞满上下文;在模型与工具之间设置网关校验与策略授权;将记忆(事实、决策、状态、经验)移出对话外部存储;以可观测证据作为任务完成的门槛,优先用确定性检查。好的 Harness 能提升每一次运行的质量。
技术 › Harness Engineering Mori 2026-10-2617.5 KB 853.6K 475 84

3 markdown architecture patterns that boost agentic productivity

本文介绍了三种提升编码代理(Agentic)生产力的 Markdown 架构模式:AGENTS.md、DESIGN.md 和 SKILL.md。AGENTS.md 为代理提供项目全局指导,基准研究显示可减少 26% diff 大小、27% 耗时和 25% token 消耗,建议保持约 12 行简洁内容。DESIGN.md 由 Google 于 2026 年推出,通过描述性文字和 YAML 设计 token 固化设计系统,保证 UI 一致性。SKILL.md 提供可复用的任务流程指令,按需渐进加载以节省 token,且可复用于非编码业务场景。作者建议将规范纳入版本控制,像对待源码一样严格管理 Markdown,并警惕第三方 skill 的安全风险,从而规模化提升团队的智能体工作流效率。

技术 › Agent Google Cloud Tech 2026-10-266.7 KB 59.2K 698 81

Claude Code 内部技巧流出【附 12 个隐藏用法】

本文总结了 Claude Code 的 12 个实用技巧,帮助用户节省额度、提高效率。内容包括:按任务难度分配思考强度(effort)、提前压缩上下文避免撑满、用 /doctor prompt-audit 清理旧指令、通过分析出错会话改进工作环境、使用 claude-mem 实现跨会话记忆、用 Statusline 展示用量信息、用 /run 和 /verify 实际验证功能、写代码与审代码分离、复杂任务先用 Plan Mode、重要限制交给 Hooks 强制执行、用 Git Worktree 并行工作等。所有命令和提示词可直接复制使用。

技术 › Claude Code 路飞 2026-10-2621.1 KB 64.1K 50 84

如何使用新版 Claude:从入门到精通

文章介绍 Claude 的重要变革:Claude Chat 与 Cowork 已统一为单一产品,云端的 Chat 现在能直接编写代码、生成幻灯片等,用户无需再区分不同模式。作者建议删除旧的复杂配置——包括 CLAUDE.md 文件、skills、指令文件等,因为它们会造成'上下文膨胀',反而降低输出质量。这一观点得到 Claude Code 作者 Boris Cherny 的支持。替代方案是:设置中开启统一模式、选择 Auto、保留 Memory、每次只给一个清晰目标,并让 Claude 在开始前复述目标以确认理解。核心理念是'少即是多',让技术变得无形。

技术 › Claude Ruben Hassid 2026-10-2511.8 KB 97K 296 78

构建 agent 时什么时候将子 agent 合并到主 agent 循环中

本文是 Claude 官方文章的译文,探讨在构建 agent 系统时何时应将子 agent 折叠进主 agent 循环。文章指出,配备 skill 的单一 agent 在质量、成本和延迟方面常常优于多 agent 设计。作者分析了大型组织构建 agent 的常见失败模式(上下文管理、子 agent 泛滥、Frankenprompt、延迟等),介绍通过渐进式披露 skill 和 MCP 工具的 agent 循环设计,并给出将子 agent 迁移为单循环的分阶段方法:构建任务完成评估、合并领域 agent、将子 agent 转为工具调用、用 skill 和工具替代子 agent,以及多团队协作的治理模式。

技术 › Agent 南晚Nanwan 2026-10-2420.6 KB 4.3K 17 85

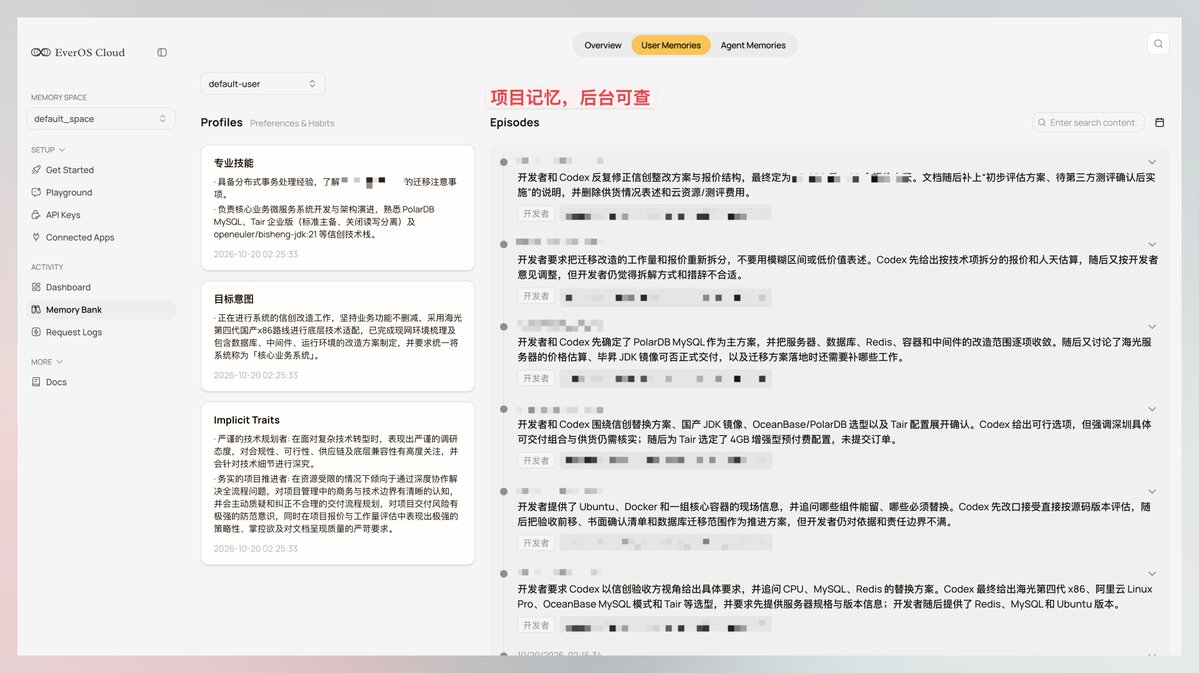
用 EverOS Cloud 解决 AI 项目方案跨电脑跨窗口无缝续接的问题

作者分享了一个长期痛点:与 AI 多轮讨论敲定的项目方案往往锁在某台电脑的聊天窗口里,换设备或同事接手时需重新投喂上下文。作者接入 EverOS Cloud(GitHub 1.3w 星开源 Agent 记忆系统 EverOS 的云端托管版),将公司电脑和家里电脑的 Codex 挂到同一云端记忆空间。AI 讨论过程中的方案与约束自动沉淀为云端记忆,跨设备、跨团队无缝续接工作,无需手动整理 Markdown。网页端 Memory Bank 可查看阶段摘要和事实卡片,支持记忆的增删改。该方案也适合团队协作,共享记忆成为项目知识资产,降低人员交接风险。

技术 › Agent 冰零 (@cryozerolabs) 2026-10-2011.5 KB 65

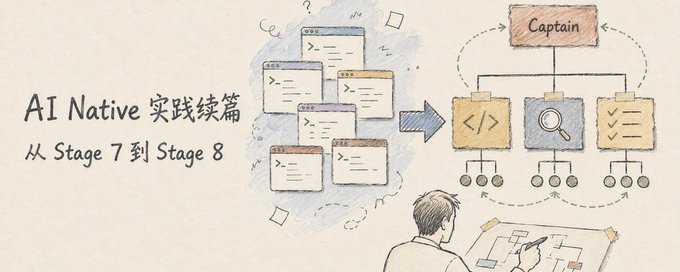
AI Native 实践续篇:迈向 Stage 8

作者继八月 AI Native 实践后,记录从 Stage 7 迈向 Stage 8 的多 Agent 工作方式探索。核心实践包括:用「测试测试」验证测试有效性(借鉴变异测试);要求 Agent 交代判断依据;采用 1+N 组织方式,由 Captain 统筹调度其他 Agent,并保护其上下文不陷入实现细节;用 logbook Kit(lbkit)串起需求到上线的完整交付流程,通过 Preflight 预演减少中途打断;让 Delivery 与 Verify 两种角色形成对抗,发现分歧。作者强调多 Agent 有成本需按任务规模挑选,目标是保护人的完整注意力与决策密度,认为对抗机制比单纯循环更重要。

技术 › Agent Jingchao 2026-10-1925.2 KB 9.4K 78 82

关于 DeepSeek Bot 的开发中的思考和取舍

作者分享了基于 DeepSeek Harness 构建的持久化 Bot 团队 DeepSeek Bot 的开发经验,重点讲解上下文和记忆系统的设计。文章对比了传统压缩派(cc)和 Codex 的实验性上下文管理(ecm),提出智能路由方式(icm):由独立的 context manager 决定压缩还是切会话。为确保智能路由真正有效,作者采用爬山算法优化,通过搭建用例、设置训练测试集、逐步迭代提示词来提升效果,并强调屏蔽噪声和成本控制的重要性。记忆系统采用轻量设计并支持外接插件。文章最后感谢社区认可并预告 Computer use、Browser use 等更新。

技术 › Agent FeiZ 2026-10-177.2 KB 11.4K 87 78

别让 Agent 进同一个群聊:聊聊多智能体协作的底层框架

文章探讨多智能体系统的底层协作架构。作者指出,多个 Agent 被拉进同一群聊会迅速退化为互相吹捧与上下文失控,根源在于系统拓扑结构选错。文章分析两种模式:一是主从派发模式(Master-Worker),适合因果链强、有客观裁判的硬任务如写代码,但存在总管上下文雪崩的风险;二是黑板模式(Blackboard),基于发布-订阅机制,适合多角色、长链路、无单一裁判的开放式协同,但易陷入惊群效应与责任真空。作者提出终极形态是'宏观黑板、微观树'的混合架构:宏观层面用企业级共享事件总线承载粗粒度里程碑事件,微观层面各业务部门内部为紧凑的 Sub-agent 树,在独立沙箱中消化琐碎任务后仅交付确定性成果。

技术 › Agent Erwin 2026-10-159.1 KB 8.9K 49 77

第1011期 小路和你读AI论文

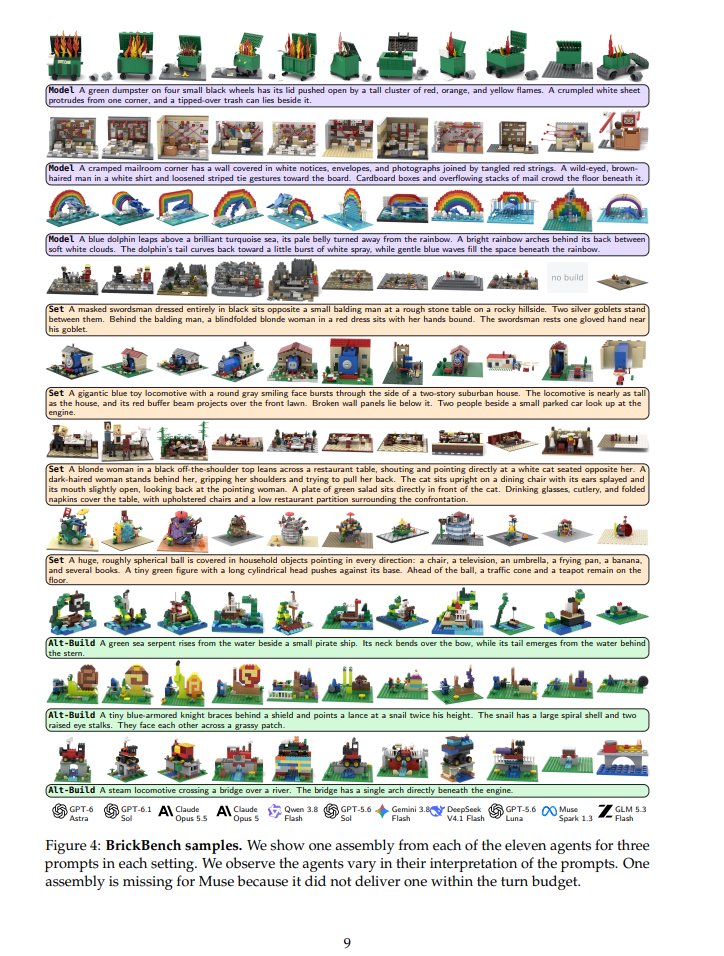
本期精选5篇高质量AI论文:1) AI智能体生态研究揭示协作产生强Allee效应,种群规模存在起飞阈值,对智能体安全有重要意义;2) BrickBench提出文本条件乐高组装的智能体基准,融合物理仿真验证;3) 思考惯性研究显示LLM被告知不思考时仍会输出显式推理,挑战一条指令关闭思维链的假设;4) 从形式化验证角度分析智能体自我改进的理论基础与极限;5) 提出工具型智能体的主动遗忘方法,可逆地整理上下文,累积输入token约减少50%,无需训练即可降低成本。

技术 › LLM 山景城小路 (@Zen_with_AI) 2026-10-125.4 KB 66

The job description is not the AI architecture

文章探讨了为什么AI系统设计不应照搬人类职位描述。职位之所以是任务的捆绑体,是因为人类自带整体性且上下文迁移成本高昂,而AI改变了这两个前提。作者指出AI能力可以以更小的增量提供,需求可以早于职位存在。但拆分任务过细会让协调问题重新出现——每个Agent各自胜任不代表系统整体高效,设计接口和共享上下文变得至关重要。职位头衔仍有价值,让系统所有权清晰可读,但应从职责出发而非职位描述来设计边界。最后警告:被AI取代的重复性初级工作同时也是培养判断力的途径,学徒制将成为设计问题。

技术 › Agent Hiten Shah 2026-10-078.4 KB 14K 13 76

从零开始理解提示缓存(Prompt Caching In Agents)【译】

本文翻译自 Earendil Engineering 的《Prompt Caching In Agents》,系统讲解编程 Agent 中提示缓存的原理与实践。文章介绍了 KV 缓存的工作机制(prefill 与 decode 阶段)、缓存的两种存放方式(会话亲和性与分布式缓存)、前缀匹配对缓存命中的决定性作用,以及显式缓存与自动缓存的区别。还解释了为何修改工具定义会破坏缓存、TTL 过期导致短请求昂贵、缓存未命中的计费代价,以及 Pi 为何保持旧记录稳定而不激进剪枝,帮助读者在上下文、缓存复用、延迟与成本之间取得平衡。

技术 › LLM 小墨同学 2026-10-0726.1 KB 34.7K 89 83

The Complete Guide to AI PM OS

文章介绍了 AI PM OS——一套面向产品经理的 Agent Skill 体系。作者强调:与其信任模型凭提示词自由发挥,不如为 Agent 配备结构化技能,确保输出质量稳定。核心方法论是'监督比你更聪明的人':通过间接提示让 Agent 自己复述问题、避免被先入为主的假设带偏,并用 /first-principles、/mckinsey-issue-tree、/causal-tree、/jtbd-forces 等技能栈按'定义问题、选择赌注、理解用户、定义成功、塑造构建、写作、推动组织'分阶段组织工作。同时利用记忆和历史会话,让 Agent 继承过往决策背景,提升产品判断力。

技术 › Skill George (prodmgmt.world) 2026-10-0313.9 KB 5.9K 46 75

关于 Goal 的 What、Why、How

文章从第一性原理探讨 AI Agent 的 /goal 模式:为什么需要 Goal(解决模型长程任务中的偷懒、中途停止和目标漂移问题),以及 Codex 和 Claude Code 的底层实现差异。Codex 由执行任务的 Agent 自己判断完成状态,Claude Code 则采用独立上下文的对抗性审查,由验收模型判定目标是否达成。作者认为 Goal 本质上是 Harness 层为模型能力缺陷打的补丁,未来必然会被模型内化,并给出设定清晰可验证目标的实践建议。

技术 › Agent 川处安 2026-09-2916.1 KB 5.5K 55 81

你对 AGENTS.md 的理解几乎为零

文章探讨了开发者对 AGENTS.md 和 CLAUDE.md 等 AI 编程工具说明文件的普遍误解。作者指出,很多团队把所有希望 AI 做到的事都写进一个不断膨胀的文件,导致维护规则本身成了负担,本末倒置。正确的做法是让 AGENTS.md 保持精简(作者根文件不到 50 行),只写每次开工都需要知道的少数核心事项,再指向不同任务对应的规则文件,让 Agent 按需读取。作者引用西蒙'存储信息'与'需要时获取信息'的区分,并提醒只有在流程确实需要反复执行时才值得做成 Skill,不必急于按需调用。

技术 › Agent Roland.W (@rwayne) 2026-09-244.3 KB 75

DeepSeek Harness vs ZCode:Token 消耗能差 10 倍的设计题

本文通过阅读 DeepSeek Harness (DSH) 0.1.7-alpha.1 源码,对比其与 ZCode 执行框架的设计差异。DSH 采用只追加的流水账机制保证可审计性,对缓存前缀极致优化以降低成本,通过三层递进方式管理上下文防止信息丢失,并内置防重复调用守卫、程序化工具调用(PTC)和超时转后台等机制。作者指出这些优势主要体现在长会话、大输出和批量工具调用场景,Token 消耗可差一个数量级;但普通短任务成败仍主要由模型智力决定,两者差距接近于零。

技术 › Harness Engineering 周尔复 2026-09-226.2 KB 7.2K 5 80

Claude 是如何记住你的项目的?浅析 Claude Code 项目级记忆功能

本文结合作者维护开源项目 CC Switch 的实际经验,深入分析 Claude Code 的项目级自动记忆(auto memory)机制。文章对比了 CLAUDE.md、自动记忆与会话历史三者的分工,解析了记忆的存储结构(索引 MEMORY.md 加主题文件)、按需加载原理、索引容量上限(200 行或 25K UTF-16 码元)及精简策略。作者通过 JSONL 台账写入纠正、方案决策背景保留、PR 审查接续三个场景说明记忆的实际价值,并指出索引超限截断、信息过时、精简后索引与正文不一致等缺陷,最后给出使用建议:明确表达纠正及原因、定期检查记忆文件、区分当前结论与历史证据。

技术 › Claude Code Jason Young 2026-09-1921.9 KB 35K 176 86

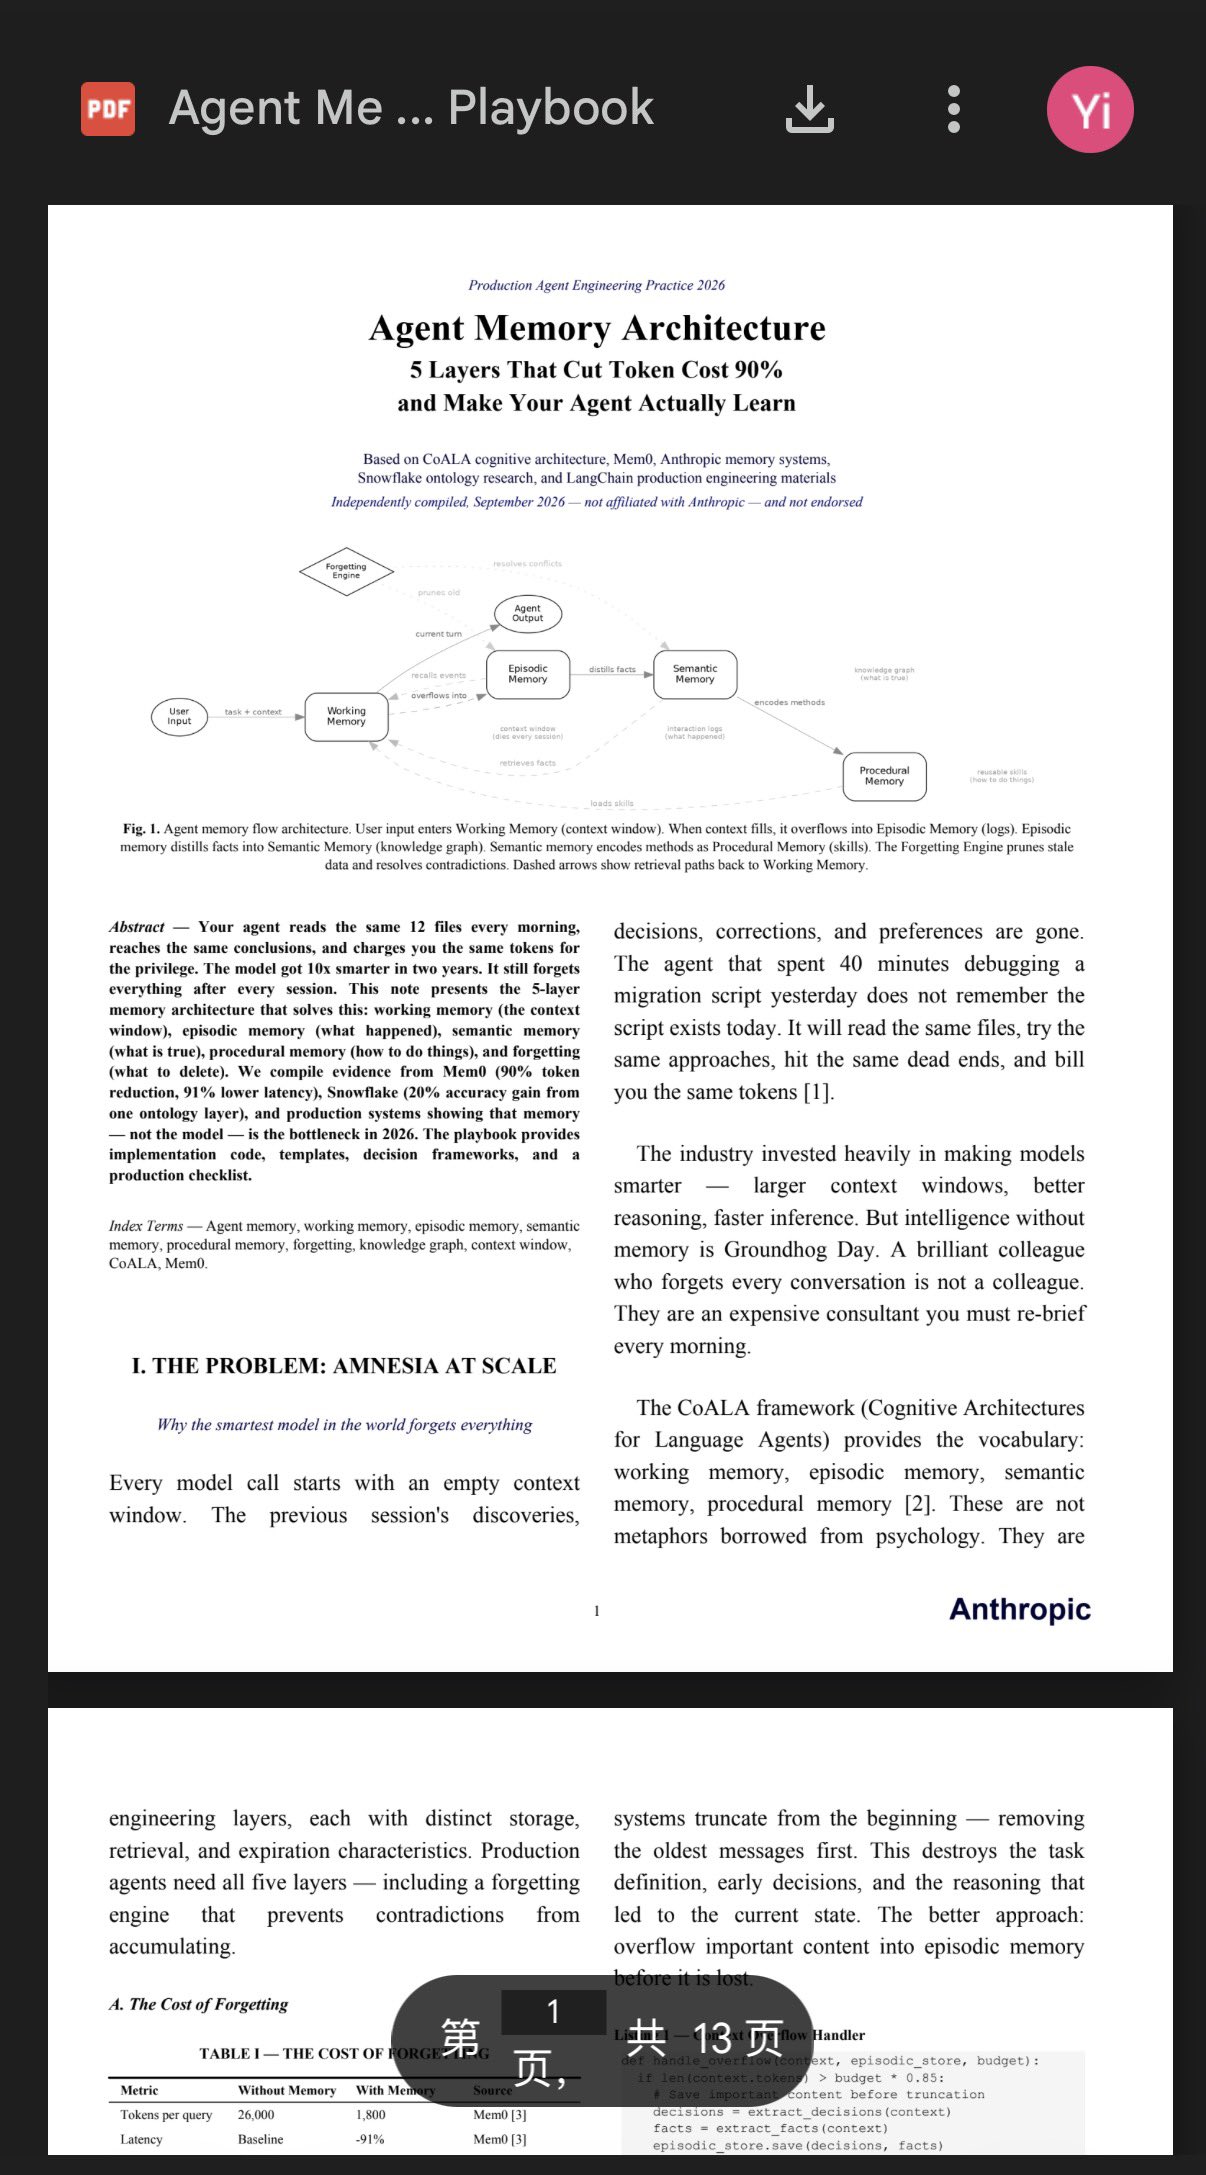
Anthropic 13页 Agent 记忆白皮书解读:5层记忆金字塔

文章推荐了一份13页的Agent记忆工程白皮书(民间整理,非Anthropic官方出品),将其拆解为5层记忆金字塔:工作记忆(上下文窗口)、情景记忆(交互日志)、语义记忆(知识图谱)、程序记忆(技能固化)和遗忘引擎(矛盾消解)。文章指出缺乏记忆分层的Agent会不断重复踩坑、成本高企,而引入该架构后Mem0的Token消耗降低90%、延迟降低91%,Snowflake准确率提升20%。核心观点是:不要迷信更大的上下文窗口,应把记忆做成可检索、可进化、可修剪的工程资产。

技术 › Agent AYi (@AYi_AInotes) 2026-09-163.8 KB 67

昨天外滩大会好多人

作者分享参加外滩大会的见闻,重点记录了关于 Agent 上下文管理和记忆的讨论。文章提到 OpenAI 新发布的 Agents API 把 Codex 背后的 Harness 做成托管 API,并围绕"记忆是新时代的个人网盘"的观点,畅想云端记忆、跨设备共享和知识交接的可能性。作者还引出圆桌上"妈生感"的有趣概念,期待 AI 通过记忆积累与自进化形成默契,强调验证、纠正和用户掌控权的重要性,最后期待 AI 的主动性与分寸感。

技术 › Agent 七仔 (@Yangtze_Seventh) 2026-09-156.1 KB 63

Cursor + Grok Bot + pstack:教你用原型和证据,把方案先跑一遍

本文深度拆解 Lauren 的 pstack 第二篇,探讨如何让 AI Coding Agent 在写代码前正确理解问题。文章介绍了 /how、/why、/teach、/recall 等上下文工具的用法,强调用代码而非文档来规划:先写使用教程倒推架构,通过低成本原型比较不同方案,用 /architect 让多模型并行设计并交叉评审,以及在多阶段计划中要求每一步都以可复查的证据结束。作者认为,Agent 可能比人更快更强,但最终是否接受方案仍需人来判断,验证应从开发前就开始参与决策。

技术 › Agent 蓝哥AI 2026-09-1528.8 KB 20.7K 84 81

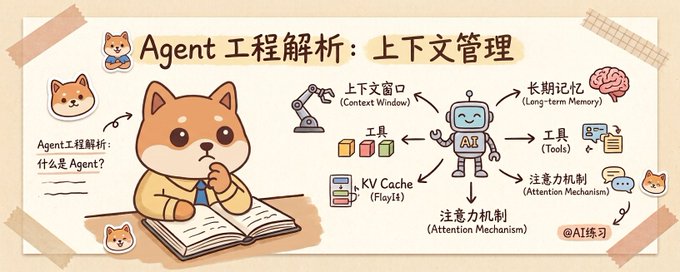
万字长文 | Agent 工程解析(一):上下文管理

文章从底层原理出发,以 Claude Code 为例深入解析大模型的上下文管理。作者指出即使上下文窗口达到 1M,上下文管理依然必要,核心原因是 KV Cache 前缀缓存机制(保证前缀一致可大幅降低推理成本)和注意力稀释问题(上下文过长过杂易引发幻觉)。文章详细拆解了 Claude Code 约 25K 系统提示词的组成,将上下文分为静态指令层、弱动态层和强动态层三层结构,并介绍了 Skill 渐进式加载、工具延迟加载、Memory 硬截断等剪枝手法,以及 CLAUDE.md 规则文件的五类分级组织形式与自顶向下的装配顺序原理。

技术 › Agent 程序员Left 2026-09-1249.6 KB 23.1K 131 86

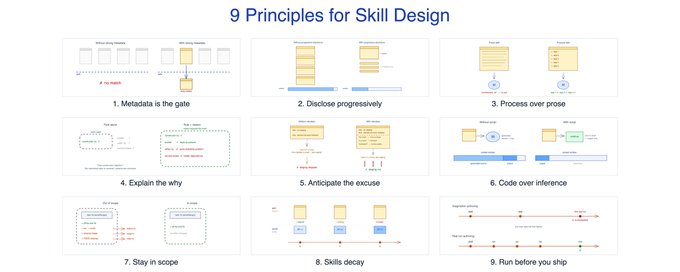
区分有效 Skill 与空谈文章的 9 条原则

作者提出九条原则,帮助判断 Agent Skill 是否真正有效,覆盖 Skill 生命周期三个阶段:被选中、可靠执行、经受现实检验。核心观点包括:元数据描述是触发与否的关键入口;上下文是共享预算,需渐进式加载;流程与检查点优于长篇散文;规则应解释原因以应对边缘情况;预先记录并反驳模型常见的跳过理由;确定性逻辑写成脚本代码而非依赖推理;严格限定修改范围;Skill 会随库更新和约定变化而腐化,需版本化管理;上线前必须用真实用例运行验证,从观察到的行为而非想象中调试。

技术 › Skill Bilgin Ibryam 2026-09-125.3 KB 14.3K 211 86

OpenAI发布Agents API:Agent Harness成为基础设施

OpenAI正式发布Agents API,将Codex背后的Agent Harness能力以API形式开放。开发者只需定义任务、模型、工具和执行环境,Agent Loop、上下文管理、工具调用、多Agent协作和沙箱等均可交由OpenAI处理。该API支持长任务自动压缩恢复、原生MCP与Web Search、Sub-Agent并行、Linux Sandbox及私有环境接入。作者认为这标志着模型正从产品变为组件,Harness等通用能力正被云厂商基础设施化,Agent创业需向业务、数据和Workflow上移。

技术 › Agent Max For AI (@MaxForAI) 2026-09-112.2 KB 70

The Complete Guide to pstack Pt. 2

本文是 pstack 指南的第二部分,探讨如何利用 pstack 进行调研、规划、原型设计和架构。作者强调验证是基础,但之后需明确构建目标。文章介绍了间接提示、/teach、/how、/why、/recall 等技巧,帮助代理理解意图和上下文,并指出历史记录是丰富上下文的金矿。最后讨论如何指定解决方案,避免过度指定实现细节。

技术 › Agent lauren 2026-09-1023.2 KB 627.9K 3.8K 84

Organizing Context in a Multi-Agent Harness

本文介绍 LangChain Deep Agents 中的多智能体上下文管理机制。大多数 harness 支持子代理功能,监督者代理委派任务给子代理以实现并行推理和上下文隔离,但隔离的子代理可能重复收集监督者已有的上下文。为此 Deep Agents 引入上下文模式(context modes):isolated(隔离模式)子代理以全新上下文启动,仅接收任务描述;fork(分叉模式)子代理继承监督者的完整对话历史,借助 prompt caching 更快更省。文章给出选择原则:worker 类代理(延续监督者已完成诊断的工作)适合 fork 模式,verifier 类代理(独立评审代码)适合 isolated 模式以避免锚定偏差,researcher 类代理处理独立问题时用 isolated 更利于并行。上下文模式与工具、中间件一样,是特化子代理的重要手段。

技术 › Agent LangChain OSS 2026-09-0911.5 KB 106.7K 265 79

Agent 工程解析(零):什么是 Agent?

文章从工程视角系统讲解 Agent 概念:首先对比 AI 应用的三种形态——Chatbot(对话驱动)、Workflow(预设流程)与 Agent(ReAct 自主循环),分析各自优缺点及区分方法;随后给出最小 Agent 的循环伪代码,演示思考-决策-行动-感知的闭环机制;再梳理生产级 Agent 所需的八大能力模块,包括上下文管理、任务管理、记忆、连接器、Trace、容灾、编排与安全;最后探讨实际工程中三者混合使用的架构策略,如 Agentic Workflow、Workflow 包装为工具、前置路由分发等。

技术 › Agent 程序员Left 2026-09-088.7 KB 8.9K 61 70

GPT-6 Astra省钱实战方法论万字拆解

文章针对GPT-6 Astra模型Token消耗高的问题,拆解了五个常见的用钱误区:只看模型单价不看任务总价(贵模型一次做对反而更省钱)、把无关资料全塞进上下文导致缓存成本暴涨、Agent跑偏后仍让其继续执行、所有任务都开最高推理强度、每一步都要人工审批打断流程。作者提出对应的省钱策略:精简上下文只保留四要素、给Agent设置刹车机制、分级使用推理强度、放权可逆操作只管控不可逆操作,并给出一段可直接使用的提示词模板。

技术 › OpenAI 马化晨 2026-09-075.8 KB 23.5K 71 80

BestBlogs早报·09-06|蚂蚁数科 Harness 验收,Uber 成本治理,UrbanGround 测长程

本期早报围绕 Agent 从生成能力走向稳定交付的实践路径展开三条精讲:一是蚂蚁数科的 Harness 工程实践,通过约束层、状态写入、目标对齐与对抗验证建立 AI Coding 验收闭环,存量项目缺陷率显著下降;二是 Uber 的智能体成本治理,在周请求量增长9.4倍的情况下,通过成本乘数拆解、模型路由、上下文治理和缓存策略保持总支出稳定;三是 UrbanGround 在真实三维香港沙盒中评测多模态模型的长程导航能力,揭示局部识别与完整任务完成间的巨大断层。速览部分涵盖自建数据中心、ML 训练数据加载、上下文清理、边缘推理、开源代码治理、AI 电话代理等主题。

技术 › Agent ginobefun 2026-09-0623.3 KB 7.5K 3 84

实测GPT-6 Astra:曾经的那个OpenAI,回来了

作者实测OpenAI新发布的GPT-6 Astra模型,认为其综合能力追平Claude Fable 5,OpenAI重回黄金时代。文章从三方面展开:一是速度大幅提升,任务完成时间从数小时缩短到十余分钟;二是前端和审美能力史诗级强化,一句话即可生成高精度3D网页模型;三是代码能力追平Fable 5,能从本质层面发现并修复系统深层问题,并介绍Codex实验性跨窗口笔记功能。作者还分享了为超级模型简化的AGENT.md配置建议,强调聪明模型需要更少限制规则。

技术 › OpenAI 数字生命卡兹克 2026-09-0520.7 KB 58.8K 278 77