Wiki 知识库

全部文档 / 标签: 训练数据

3 篇
清除

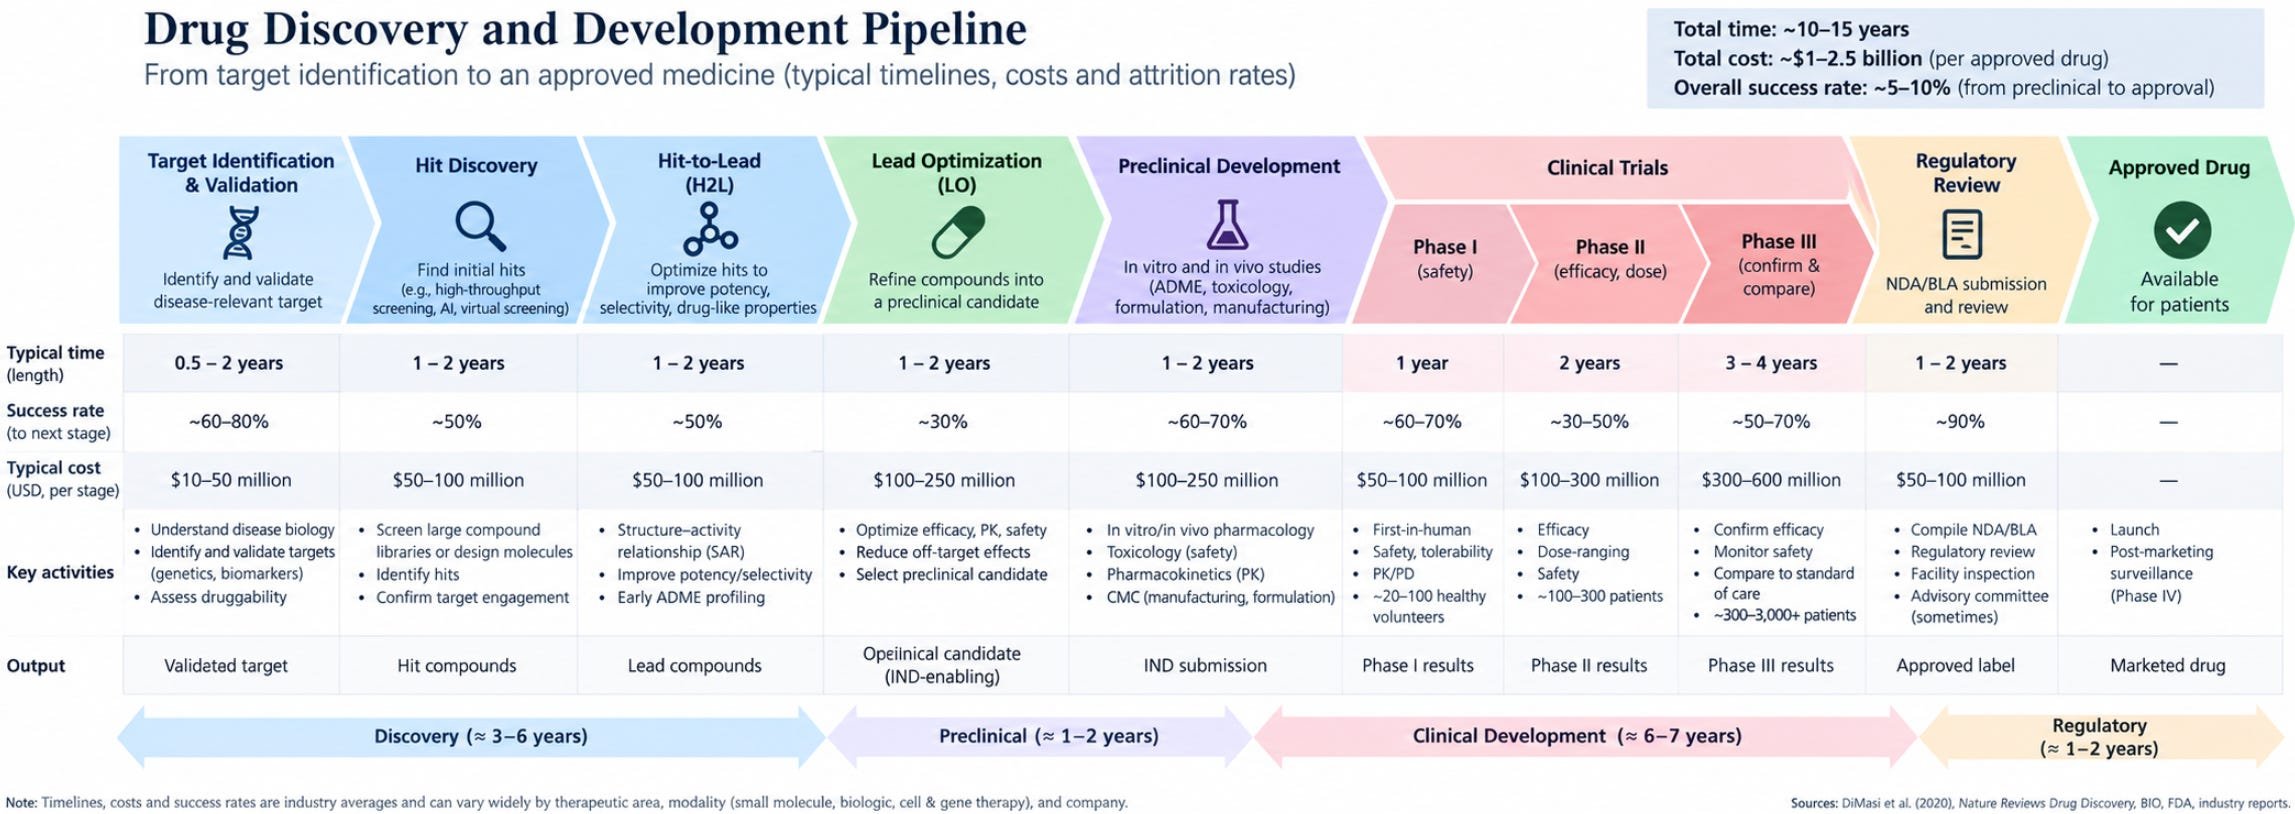
AI Drug Discovery Is Becoming a Bottleneck Trade

作者认为AI药物发现(AIDD)正经历真正的行业变革,类似半导体行业的瓶颈交易机会。上游前沿AI实验室纷纷入局,下游供应链明显移动:AI让假设生成几乎免费,实验验证成为新瓶颈,湿实验室从制药转向生产训练数据。文中举例Twist(TWST)预计AI药物发现订单连续两位数增长,GenScript AIDD业务翻倍且日验证量快速攀升,并类比GPU→HBM→网络的半导体瓶颈链条,指出DNA/蛋白合成→检测→临床前产能的下游机会,动物实验或成下一瓶颈。风险在于临床II期结果及产能过快扩张。

投资 › 股票 Freda Duan (@FredaDuan) 2026-10-066.4 KB 81

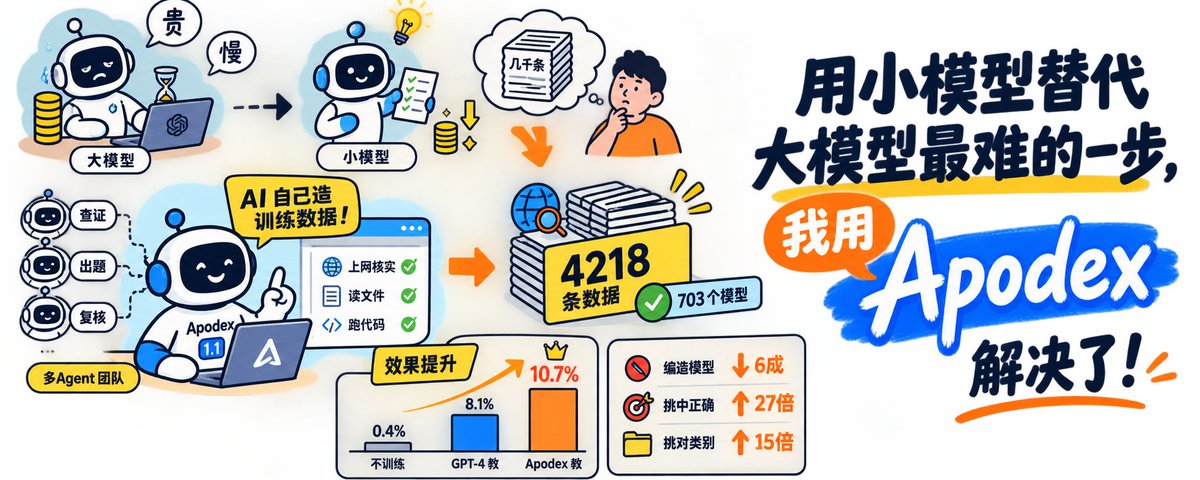
用小模型替代大模型最难的一步,我用 Apodex 解决了

作者尝试用 Apodex 1.1 自动生成训练数据,解决用小模型替代大模型时缺乏标注数据的难题。实验场景是让小模型学会根据自然语言描述从 HuggingFace 九百多个候选模型中挑选正确的模型。Apodex 拆解任务、派出 14 个子 Agent 分工协作并上网核实,最终生成 4218 条经核实的训练数据,还主动推翻了作者一条错误规则。用这批数据训练 Qwen3.5-0.8B 后,挑对模型的比例从 0.4% 提升到 10.7%,瞎编模型名的比例大幅下降,效果优于当年 Berkeley 用 GPT-4 生成的数据。作者总结:AI 能替人造数据的关键,在于能否自动判对错。

技术 › LLM 柯基是只猫 2026-08-2814.7 KB 15.8K 93 82

向前沿实验室出售数据的淘金热

文章探讨了向前沿AI实验室出售训练数据这一暴利行业的现状。虽然部分公司单季营收可达数千万美元,但该业务缺乏持续性,本质是出售专家判断力、模拟环境等。由于模型能力迭代极快,数据供应商面临订单随时消失的风险,是一场巨大的淘金游戏。

技术 › AI Vikram Aditya 2026-07-1750.2 KB 898.4K 2.4K