发现一个中文语音数据集:218人8万多条语音
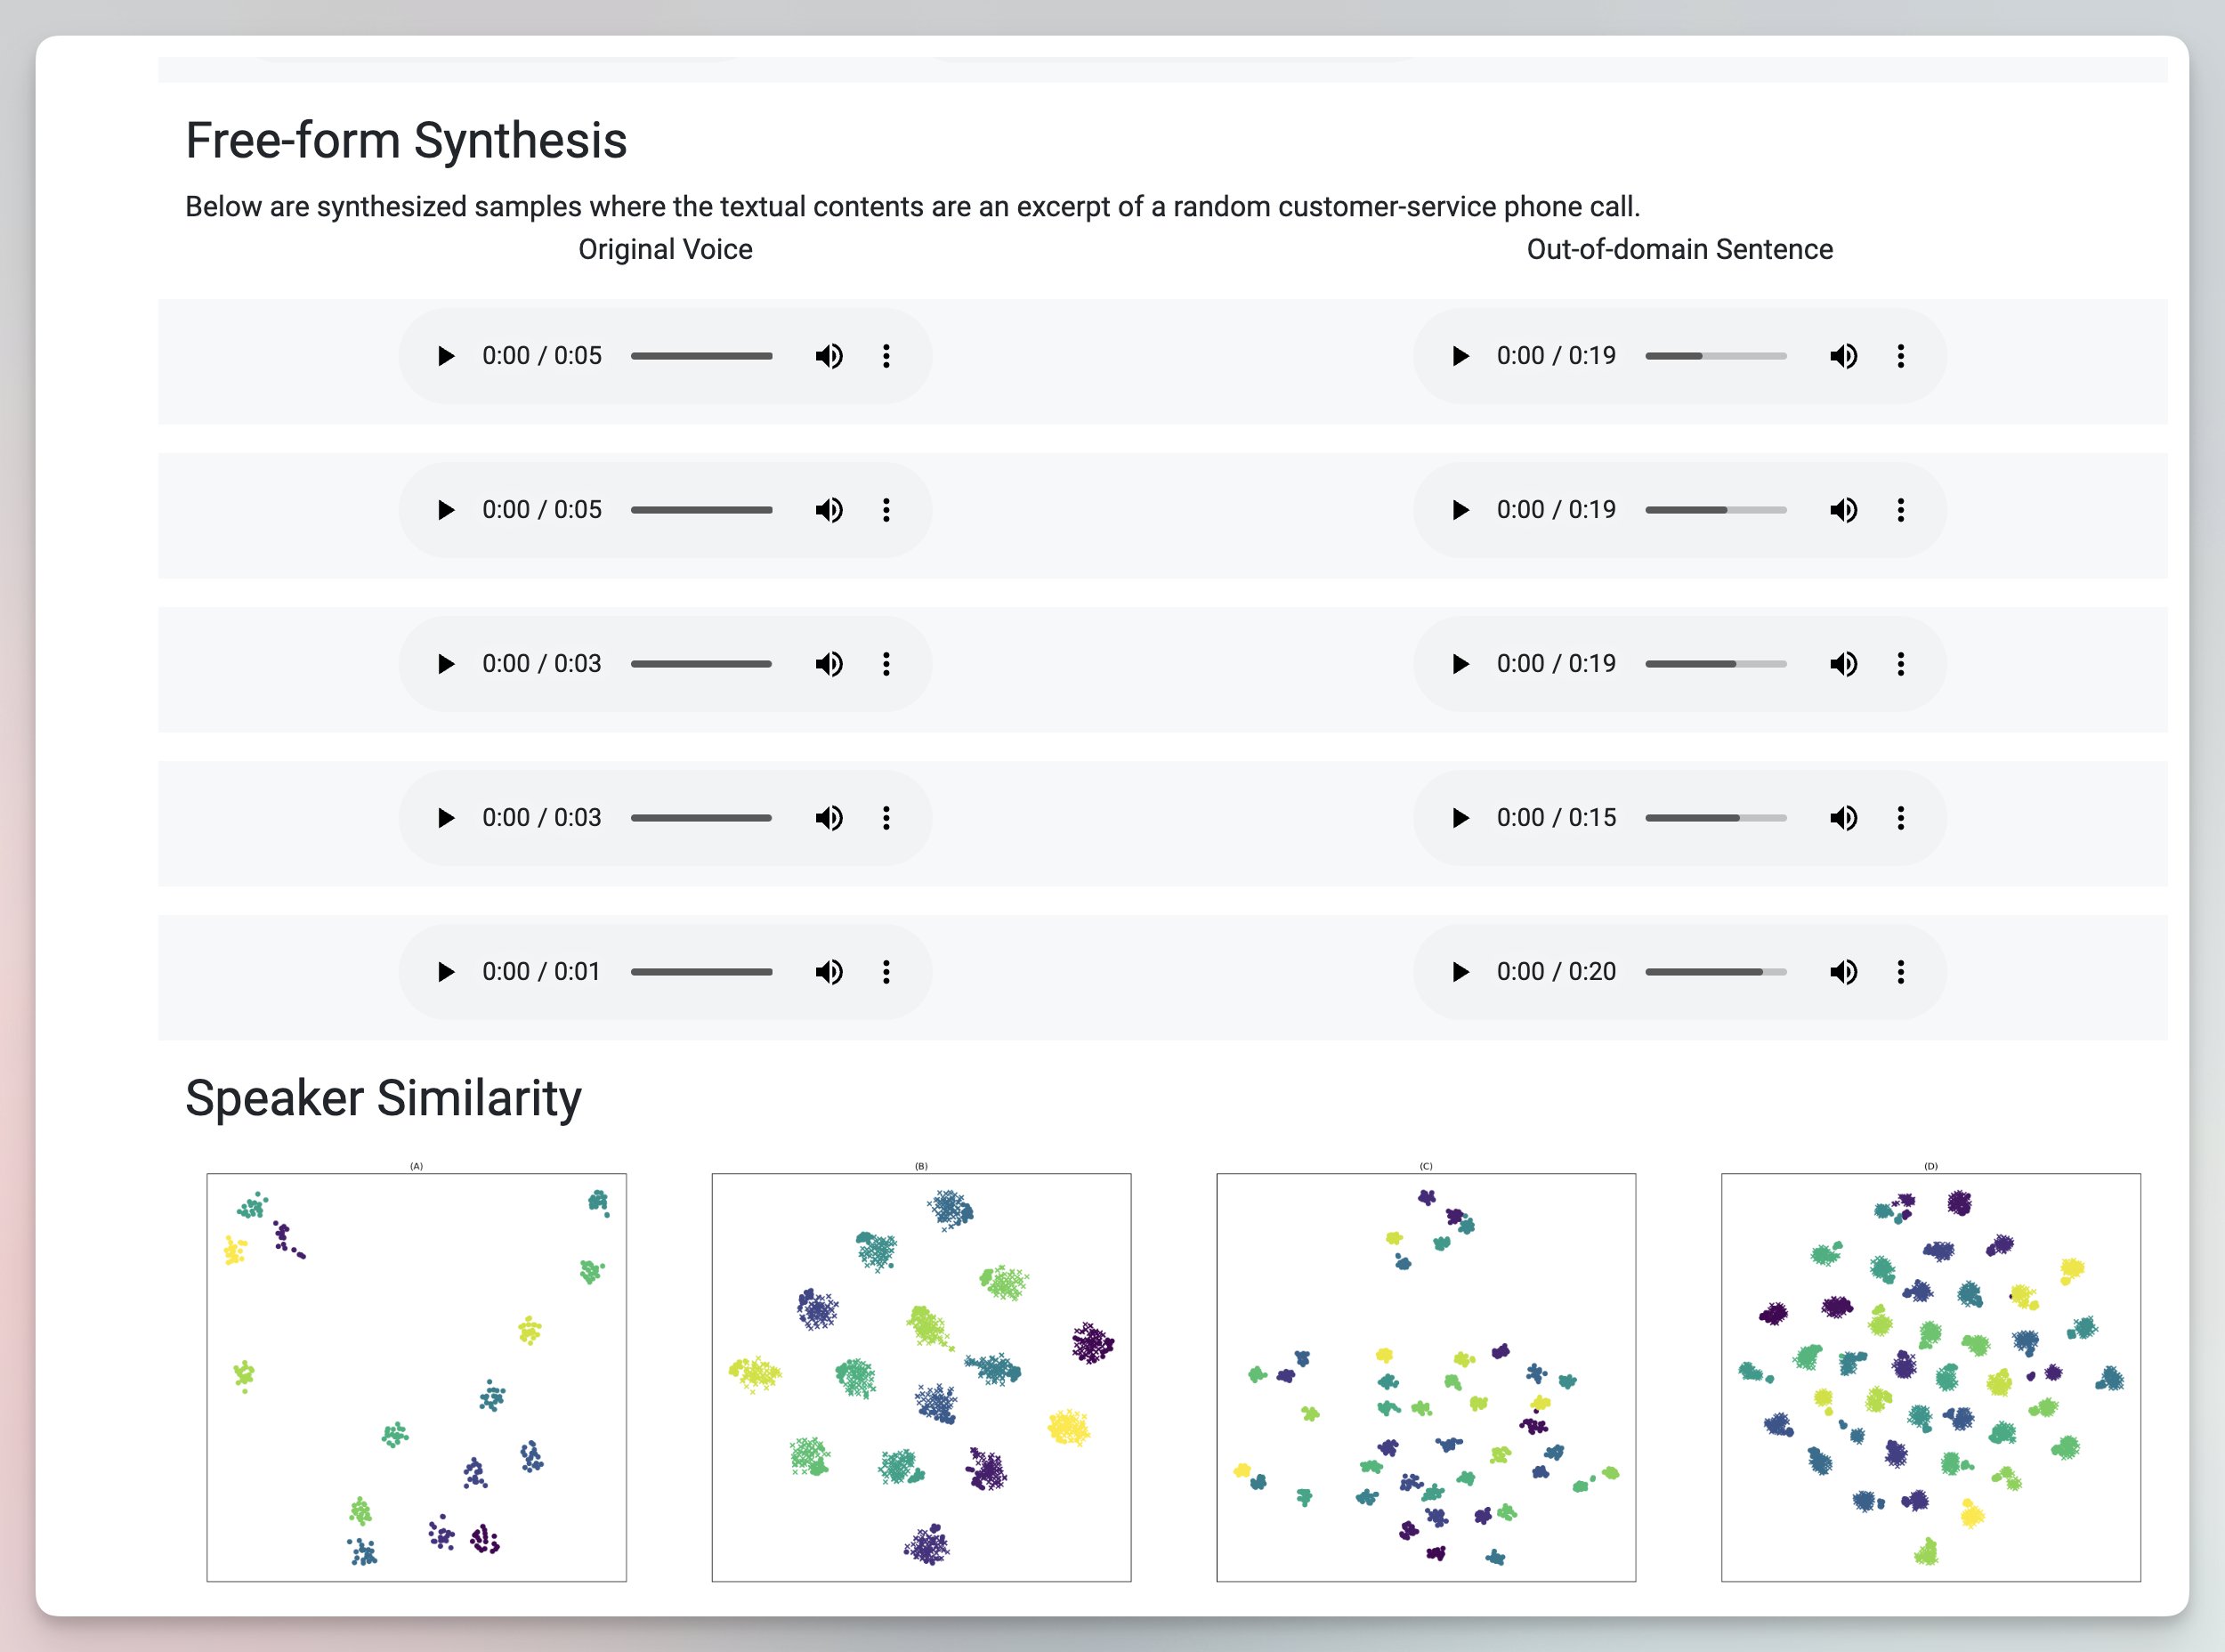
作者发现一个中文语音数据集,包含218人的8万多条语音,情感中性,并带有性别、年龄、母语口音等标注,字音准确率达98%以上,经过专业标注和严格质检。开源TTS模型如F5、Spark、IndexTTS2都需要参考语音,自己录制麻烦,该数据集可以省去这一步。作者是在为Qiaomu Reader开发电子书朗读功能时发现的。文中附有数据集官网地址和语音样例链接。
作者发现一个中文语音数据集,包含218人的8万多条语音,情感中性,并带有性别、年龄、母语口音等标注,字音准确率达98%以上,经过专业标注和严格质检。开源TTS模型如F5、Spark、IndexTTS2都需要参考语音,自己录制麻烦,该数据集可以省去这一步。作者是在为Qiaomu Reader开发电子书朗读功能时发现的。文中附有数据集官网地址和语音样例链接。
文章讲述 29 岁的 Alexandr Wang 的创业历程:他从 MIT 退学后创办 Scale AI,选择当时被轻视的数据标注业务,为 OpenAI、Google、Meta 等巨头提供训练数据、RLHF 和红队测试服务,成为 AI 行业绕不开的基础设施。2025 年扎克伯格以约 290 亿美元估值收购 Scale 49% 股权,并邀请他执掌 Meta Superintelligence Labs。作者认为,小扎买下的不只是一家公司,而是一个看遍顶尖模型训练底牌八年的人。文章借其经历说明:技术人真正的胜负手在于焊死别人不愿做的底层管道。
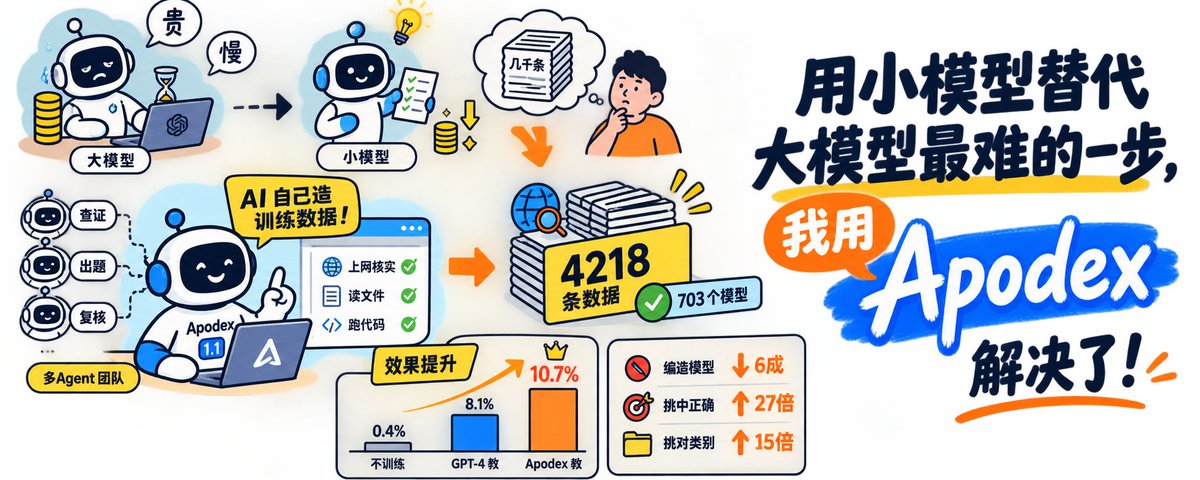
作者尝试用 Apodex 1.1 自动生成训练数据,解决用小模型替代大模型时缺乏标注数据的难题。实验场景是让小模型学会根据自然语言描述从 HuggingFace 九百多个候选模型中挑选正确的模型。Apodex 拆解任务、派出 14 个子 Agent 分工协作并上网核实,最终生成 4218 条经核实的训练数据,还主动推翻了作者一条错误规则。用这批数据训练 Qwen3.5-0.8B 后,挑对模型的比例从 0.4% 提升到 10.7%,瞎编模型名的比例大幅下降,效果优于当年 Berkeley 用 GPT-4 生成的数据。作者总结:AI 能替人造数据的关键,在于能否自动判对错。
本文全面盘点了 AI 时代的 16 个新工作机会,并按入门门槛从低到高进行排列。文章针对每个岗位详细分析了工作内容、能力要求、国内外薪资水平以及小白友好度等指标。作者指出,纯执行类岗位虽在贬值但仍是入行跳板,最赚钱的是懂行业与 AI 的复合型人才。文章为零基础转行者提供了极具实操性的职业切入指南。
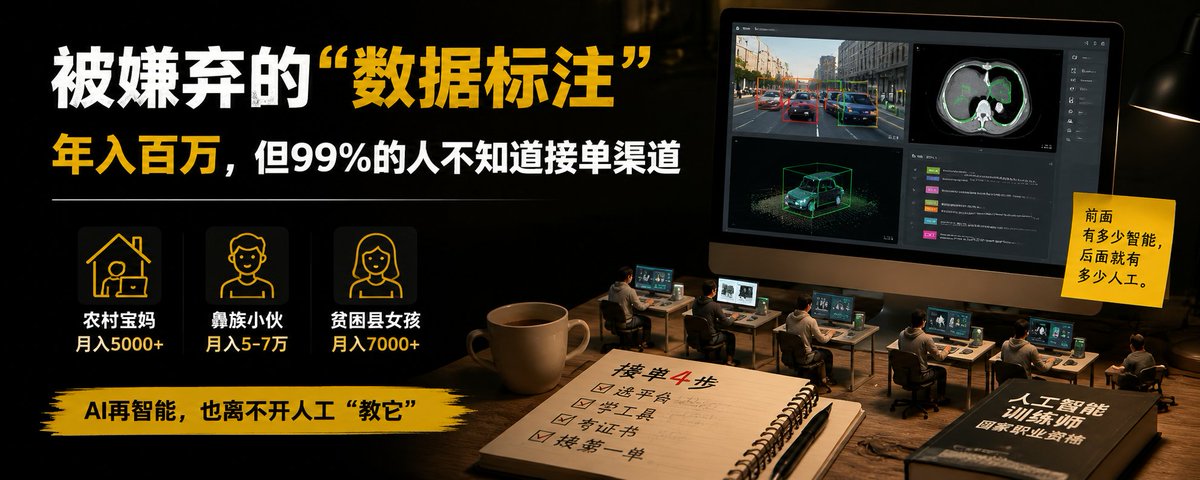
文章揭示了数据标注行业的巨大商机,虽然常被吐槽“不体面”,但已帮助许多农村宝妈和返乡青年实现高收入。文章详细介绍了数据标注的四种类型、入门SOP、如何从个人单干发展到团队老板的路径,并提供了避坑指南和2026年的行业风口预测。
文章探讨了向前沿AI实验室出售训练数据这一暴利行业的现状。虽然部分公司单季营收可达数千万美元,但该业务缺乏持续性,本质是出售专家判断力、模拟环境等。由于模型能力迭代极快,数据供应商面临订单随时消失的风险,是一场巨大的淘金游戏。