你为什么也需要一个本地模型?Ling3.0-tiny 本地部署实测
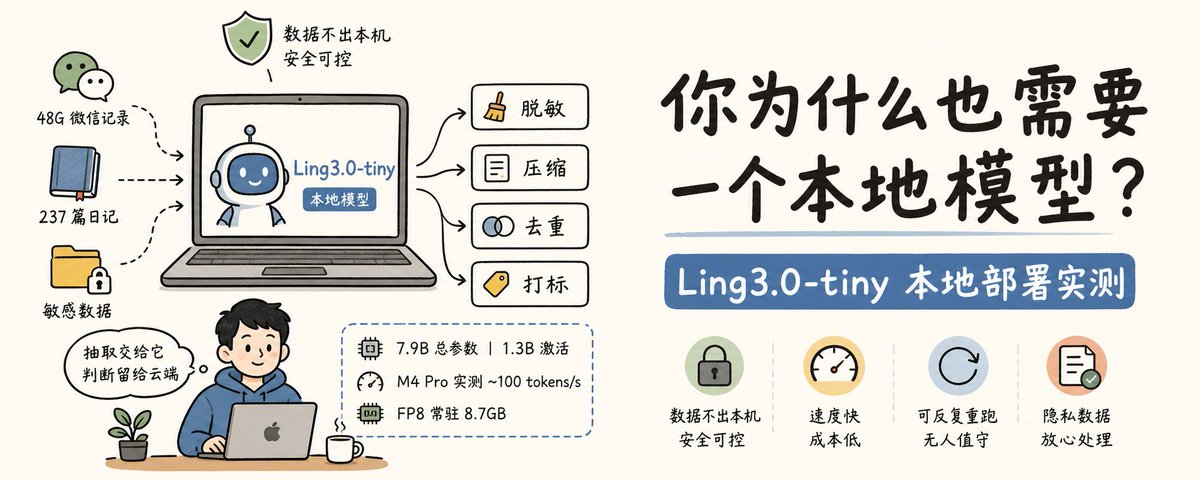
作者介绍了在 MacBook M4 Pro 上部署蚂蚁百灵开源的 Ling-3.0-tiny 稀疏 MoE 模型的完整过程,用于处理 48G 微信记录和 237 篇日记等隐私数据。文章详述了 FP8 权重选择、编译 MLX 后端 ollama、避坑指南等实操细节,实测生成速度约 78-99 tokens/s。在脱敏、命名实体识别、长文压缩、去重四个场景中表现优异,并总结分工原则:抽取任务交给本地模型,语义判断留给云端模型。
作者介绍了在 MacBook M4 Pro 上部署蚂蚁百灵开源的 Ling-3.0-tiny 稀疏 MoE 模型的完整过程,用于处理 48G 微信记录和 237 篇日记等隐私数据。文章详述了 FP8 权重选择、编译 MLX 后端 ollama、避坑指南等实操细节,实测生成速度约 78-99 tokens/s。在脱敏、命名实体识别、长文压缩、去重四个场景中表现优异,并总结分工原则:抽取任务交给本地模型,语义判断留给云端模型。