Wiki 知识库

全部文档 / 标签: MoE

59 篇
清除

推理是训练的 12 倍,可一块卡生成时只跑出 5% 的算力

文章基于 YC Paper Club 播客,剖析 LLM 推理成本真相:按两年模型寿命摊算,推理总算力约为训练的 12 倍。decode 阶段 MFU 仅 5%,瓶颈在显存带宽而非算力。DeepSeek 通过 KV cache 保留 72 小时、radix attention、零开销调度等手段将缓存命中率做到 96%,实现 38 美元一卡时、80% 毛利。文章还讨论了 SSM 等被低估的模型结构、服务商质量参差(同一模型不同服务商差距超开源闭源差距)以及开源推理生态的规模,指出推理成本优化才是 LLM 竞争的胜负手。

技术 › LLM Saito 2026-10-268.7 KB 140 77

Kimi K3.1 Pro 第一手测评:与 GPT-6 Astra 硬刚游戏开发

月之暗面发布 Kimi K3.1 Pro,3万亿参数MoE架构、100万token上下文、开源权重,API输出价格仅为GPT-6 Astra的五分之一。作者从跑分和实测两方面评估:官方xdev-bench-hard编程成功率64.5%排第二,幻觉测试同样第二,第三方智能指数全场第四、开源第一。实测中,作者用相同提示词让K3.1 Pro与GPT-6 Astra分别开发3D跳一跳和植物大战僵尸游戏,两者均一次成型无bug。Kimi耗时约10分钟但会自我验证和修正,Astra快近5倍且细节更丰富。结论:K3.1 Pro编程能力接住闭源旗舰,价格是杀手锏,适合重度Agent用户。
技术 › LLM 程序员小灰 2026-10-2516.2 KB 5.5K 11 75

Kimi K3.1 Pro 来了:离最强只差 0.7 分,API 反而降价三分之一,权重 11 月 4 日白送

月之暗面发布 Kimi K3.1 Pro,基于 K3 做 post-training 升级,2.8T 总参数、104B 激活(MoE)、1M 上下文、多模态。Terminal-Bench 4.0 得分 65.7,超越 GPT-6 Astra(58.2),仅落后 Claude Opus 5.5(66.4)0.7 分,是开源模型离闭源最强最接近的一次。API 价格输入 $2/输出 $10,比上一代降价三分之一,权重将于 11 月 4 日开源。文章拆解了 14 项评测表现,指出其在编码、Agent、金融分析领域表现出色,但科学计算类任务偏科严重(38.1 vs 68.1),并给出小白使用入口与避坑清单。

技术 › LLM 丰收 2026-10-247.2 KB 1.8K 2 84

Kimi K3.1 Pro来了,国产模型审美的新巅峰

月之暗面发布旗舰模型Kimi K3.1 Pro,参数规模2.8T(MoE,104B激活),支持100万Token上下文,继续开源。API价格较K3砍半,仅为GPT-6 Astra的五分之一。跑分仅次于Claude Opus 5.5和GPT-6 Astra,Terminal-Bench 4.0达65.7%,OfficeQA Pro v2获SOTA,幻觉率从23.4%降至8.3%。作者重点测试了视觉方向:3D建模能力已可与GPT-6 Astra正面竞争,包括网页3D果冻、高精度机械键盘、根据户型图与装修图生成Three.js第一视角漫游网站、结合平面图与手持视频还原办公室3D模型。视频动效方面提升巨大,可一轮直出动效作品集、宣传片及科普视频,虽距Opus 5.5仍有差距,但已属国产模型巅峰水平。

技术 › LLM 数字生命卡兹克 2026-10-2417.5 KB 20.2K 62 70

一个人十天写出的引擎,让 12GB 显卡跑起 1250 亿参数模型

个人开发者用十天时间(代码大部分由 AI 编写)打造了推理引擎 Strata,能让 12GB 显存的普通电脑运行 1250 亿参数的 Qwen 3.8 Flash Next 模型。文章剖析其六倍速度宣传实为不同量化版本对比,同版本实际是两到四倍;真正亮点是 prompt 读取速度达每秒 1500 token。核心技术是围绕 MoE 架构的专家缓存,命中率约 72%,代价是输出可能偏离原模型结果。文章还对比了买内存自建与云端 API 的成本账,并预判通用引擎 llama.cpp 将在几个月内补齐缓存能力。

技术 › LLM Saito 2026-10-218.8 KB 1.5K 4 84

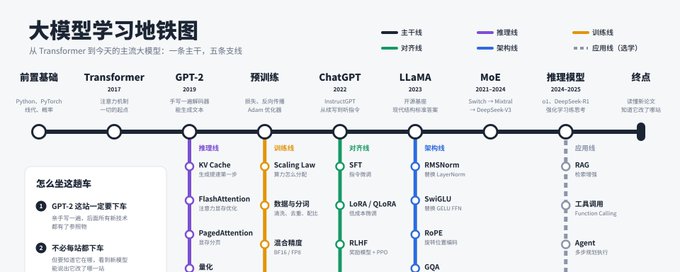
大模型学习地铁图:从 Transformer 到今天的主流大模型

文章以地铁图为比喻,为大模型学习者规划了一条清晰的学习路线。主干线按演进顺序设置八站:前置基础、Transformer、GPT-2(强调亲手实现作为锚点)、预训练、ChatGPT 时刻(RLHF)、LLaMA、MoE 稀疏专家、推理模型(o1/R1),终点是能独立读懂新论文。五条支线按兴趣选修:推理优化(KV Cache、FlashAttention、量化)、训练(Scaling Law、分布式并行)、对齐(SFT、LoRA、DPO、GRPO)、架构(RMSNorm、RoPE、MLA)、应用(RAG、Agent)。最后给出建议:GPT-2 必须亲手写一遍,主干加一至两条支线即可入门,学习原理时动手推算。

技术 › LLM 纳米AI 2026-10-2010.4 KB 52K 871 88

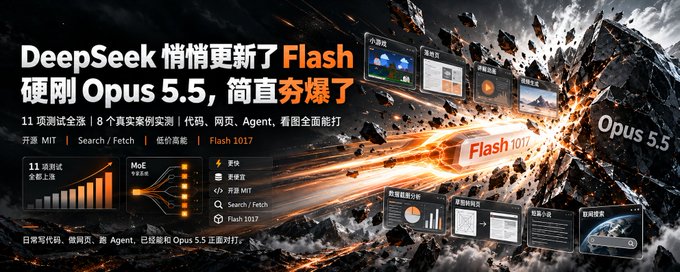
DeepSeek 悄悄更新了 Flash,硬刚 Opus 5.5 简直夯爆了

DeepSeek 发布了 DeepSeek-V4.1-Flash-1017 小版本更新,作者在推理、代码、Agent、图像理解等 8 个实际场景中与 Opus 5.5 进行同题对比测试。测试包括网页小游戏开发、落地页设计、讲解动画、视频渲染、数据分析、草图转网页和小说写作。结果显示该 Flash 版本在功能完整度、数据分析、交互还原等方面表现出色,多项能力已接近 Opus 5.5。新版本采用 552B 参数 MoE 架构,MIT 协议开源,同时开放了 Search 和 Fetch 搜索接口。

技术 › LLM zhouluobo 2026-10-1818.7 KB 9K 32 77

把 96.5GB 的 GLM-5.3-Flash 塞进单张 4090 48GB,跑出 41.8 token/s

本文记录了在单张魔改 RTX 4090 48GB 上,通过系统级调优将 96.5GB 的 MoE 模型 GLM-5.3-Flash 推理提速至 41.8 token/s 的完整工程实录。作者采用混合 i-quant 量化,将 12,096 个专家常驻显存与锁页内存,通过实测发现减少 CPU 线程反而提升 42% 速度、扩大显存池至 46GB 带来质变、以及激进的 PCIe 搬运策略是致命代偿陷阱。文章逐毫秒拆解了 24.47ms 的 token 耗时去向,指出 PCIe 搬运是硬瓶颈,并对比了更稀疏的 Qwen3.8-Flash-Next 架构可达 120 tok/s 的原因。

技术 › LLM huangserva 2026-10-1217.6 KB 9.3K 57 89

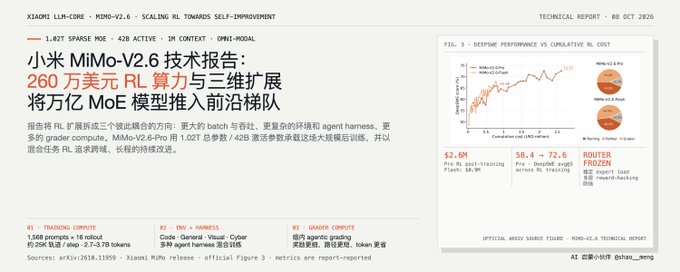
小米 MiMo-V2.6 技术报告:260 万美元 RL 算力与三维扩展,将万亿 MoE 模型推入前沿梯队

文章解读小米 LLM-Core 团队发布的 MiMo-V2.6 技术报告。核心主张是通过系统性扩展强化学习算力提升模型智能,需同时扩展训练批次、环境多样性和评分器三个维度。模型有 Pro(1.02T MoE)和 Flash(310B)两个规格,RL 后训练成本分别 260 万和 90 万美元。报告详述了中期训练优化、GRPO 训练细节、多 harness 训练、四层 reward hacking 防御、Groupwise Agentic Grading 评分体系、router 冻结发现及基础设施设计,最终性能进入与 Claude Opus 5 / GPT-5.6 同一梯队,并开源蒸馏模型、环境与 RL 框架。

技术 › LLM meng shao 2026-10-1011.6 KB 3.3K 6 86

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍了如何借助Strata框架和Agent自动化流程,在12GB消费级显卡上部署125B参数的MoE模型Qwen3.8-Flash-Next。文章解释了MoE稀疏激活(每token仅激活6B)与Strata让GPU、CPU、RAM、SSD协同工作的原理,对比了不同量化方案(UD-IQ4_XS与UD-Q4_K_XL)在专家缓存命中率上的速度差异。作者全程使用蚂蚁的Ling-3.1-flash Agent完成从读文档、检查硬件、安装、排错到测速验收的部署流程,并成功将本地模型接入pi。该方法可复用于部署Ling、GLM、Kimi、DeepSeek等其他本地模型。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 159.4K 454 79

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍如何在12GB显存上部署125B参数的Qwen3.8-Flash-Next模型。核心是Strata技术让GPU、CPU、RAM和SSD协同工作:常用专家留GPU,其余放RAM,CPU处理cache miss。RTX 5070 12GB + 64GB RAM在Q2_0量化下短对话可达94 tok/s。文章还讲解了量化选择策略——显存占用相同时速度可差1.72倍,关键在于专家命中率。作者全程使用蚂蚁的Ling-3.1-flash Agent自动完成从检查机器、选权重、下载安装到排错验收的完整部署流程,跑通了一套用Agent自动部署本地模型的可复用方法。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 79

AI 工程师需要了解的 GPU 全部知识

本文面向 AI 工程师系统讲解 GPU 硬件知识:GPU 的三种类型(数据中心、工作站、个人级),内部结构(SM、Tensor Core、CUDA 核心、HBM 显存与 SRAM 缓存),并以 gpt-oss-120b 和 Kimi K3 两个开源 MoE 模型为例,用精确的数学计算说明推理的算力与显存带宽瓶颈、prefill 与 decode 的差异,以及训练与推理对 GPU 使用的不同需求,帮助工程师做出租用 GPU、模型部署等实际决策。

技术 › LLM Karan 2026-10-0219.3 KB 55.1K 427 82

Top AI Papers of the Week (9月21日-9月27日)

DAIR.AI 每周精选五篇 AI 论文:(1) 小米 MiMo 团队的 HySparse2 混合稀疏注意力架构,通过两级 KV 共享将百万 token 预填充成本降低至原方案的几分之一,同时提升长上下文检索精度;(2) MIT 与 Sakana AI 的 SIFT,用 LLM judge 加 Bradley-Terry 模型替代昂贵基准评估,将自改进智能体搜索成本降至约十分之一;(3) GAVEL 图世界模型,无需改动权重即将小模型长时程机器人任务成功率翻倍;(4) WFM Wiki 基础模型,针对 markdown 链接式长期记忆的图检索;(5) JEV 决策型 judge 模型,成本仅为 GPT-6 的约 1/277。

技术 › LLM DAIR.AI 2026-09-2816.0 KB 37.8K 146 80

Is ENGRAM free lunch? Does it not impact AI model quality?

文章深入分析Engram技术:将序列嵌入存储到可卸载至DRAM的嵌入表中,节省HBM内存、减少FLOPs,从而降低AI推理成本。在参数和训练预算相同的对照实验中,Engram-27B相比MoE-27B不仅没有降低性能,反而显著提升(MMLU从57.4升至60.4)。作者指出Engram参数分配存在约20-25%的最优区间,过高会挤占MoE专家参数损害性能,且不能完全替代FFN(FFN负责概念运算)。结论认为Engram确实是一种'免费午餐',DeepSeek、美团LongCat、Qwen等已采纳该技术。

技术 › LLM GDP 2026-09-2710.0 KB 38.3K 64 73

DGX Spark Handbook

本文是 NVIDIA DGX Spark 本地推理设备的使用手册。作者最初因其 273 GB/s 的低内存带宽而不看好,但随着 MoE 架构、推测解码等推理工程技术的成熟,DGX Spark 已能在本地以接近云服务的速度运行高智能模型。文章详细介绍了多台 Spark 通过 ConnectX-7 网卡链接实现近线性扩展带宽和内存的方案(四台可达 1092 GB/s、512 GB 内存)、低功耗适合家用部署的优势、MoE 与推测解码如何弥补硬件短板,以及单机同时服务 8 个并发会话的能力,并对比了与 Mac 的算力优势和成本分析。

技术 › LLM EXO Labs 2026-09-2651.7 KB 256.4K 703 75

深入解读斯坦福在线课程 MS&E 319「高效生成式语言模型」

本文深入解读斯坦福 2026 秋季研究生课程 MS&E 319《Efficient Generative Language Models》。该课程以「效率」为设计科学,在算力预算有限的约束下,沿大模型生命周期系统讲授预训练、架构、推理、后训练四阶段的效率技术,包括多 token 预测、Muon 优化器、MoE、稀疏注意力、FlashAttention、KV 缓存压缩、量化、投机解码、LoRA、DPO 与蒸馏等,并涵盖越狱攻击与模型窃取等安全议题。文章认为该课填补了教育生态空位,内容前沿性与领域同步,揭示了每项效率技术背后的权衡取舍。

技术 › LLM meng shao 2026-09-2111.5 KB 18.9K 95 68

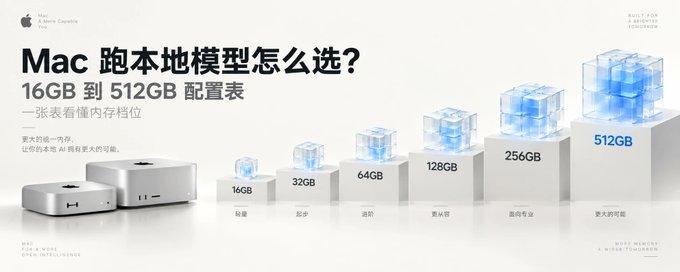
2026 Mac 跑大模型配置指南|16GB 到 512GB 怎么选

文章针对 Apple 新发布的 M6 Mac mini 与 M5 Mac Studio 系列,系统讲解如何为本地运行大模型选择合适配置。作者提出三笔账:内存容量决定模型能否装下、内存带宽决定生成速度、算力决定提示词处理和训练能力。给出 4 位量化模型内存估算公式和生成速度理论公式,并提供四档选购建议:24-32GB 跑 8B-14B、64GB 跑 32B、128GB 跑 70B、256-512GB 跑 200B 以上或 671B MoE。最后指出数据保密、高频调用、离线需求才是为本地模型购买大内存 Mac 的真正理由。

技术 › LLM 苏乐 2026-09-2019.6 KB 317.2K 453 86

Behind Jev: Two Hypotheses About Its Base Model

文章探讨 TypeSafe 公司 Jev 决策 API 背后可能的基础模型架构,提出两种假设:一是 BERT 风格的双向编码器,二是去掉生成循环、直接输出决策概率的因果解码器。作者引用 Archer Hume 基于约一万次 API 调用的逆向分析,认为其可能是带共享状态计算、独立问题分支和直接概率读出的因果 Transformer,甚至可能是 MoE 架构,但其研究无法区分编码器与解码器。文章还通过 OpenJev 等开源项目(基于冻结的 Qwen3.5-4B 权重)证明使用因果模型骨干做直接决策打分在技术上可行,并讨论了因果注意力、前缀缓存等工程优势。作者强调这些都是架构假设,不能确定 Jev 的真实权重来源。

技术 › LLM Roy Chen 2026-09-1911.5 KB 45.6K 123 74

MoE 推理工程详解

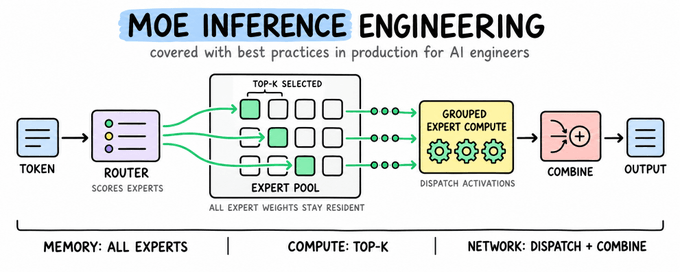
本文系统讲解 MoE(混合专家)模型的推理服务工程原理。从稠密 Transformer 的 FFN 与 MoE 层的区别入手,介绍路由器如何为每个 token 选择专家、dispatch 和 combine 过程如何将路由决策聚合成专家专属矩阵,以及 grouped GEMM 如何减少内核启动开销。文章还涵盖专家并行、拓扑感知部署、显存需求(常驻参数 vs 激活参数)、负载不均衡、容量限制和量化等话题,并分析计算、显存带宽与互连流量之间的性能瓶颈权衡,以 Qwen3-30B-A3B 为实例说明。

技术 › LLM Avi Chawla 2026-09-1929.1 KB 148.8K 316 73

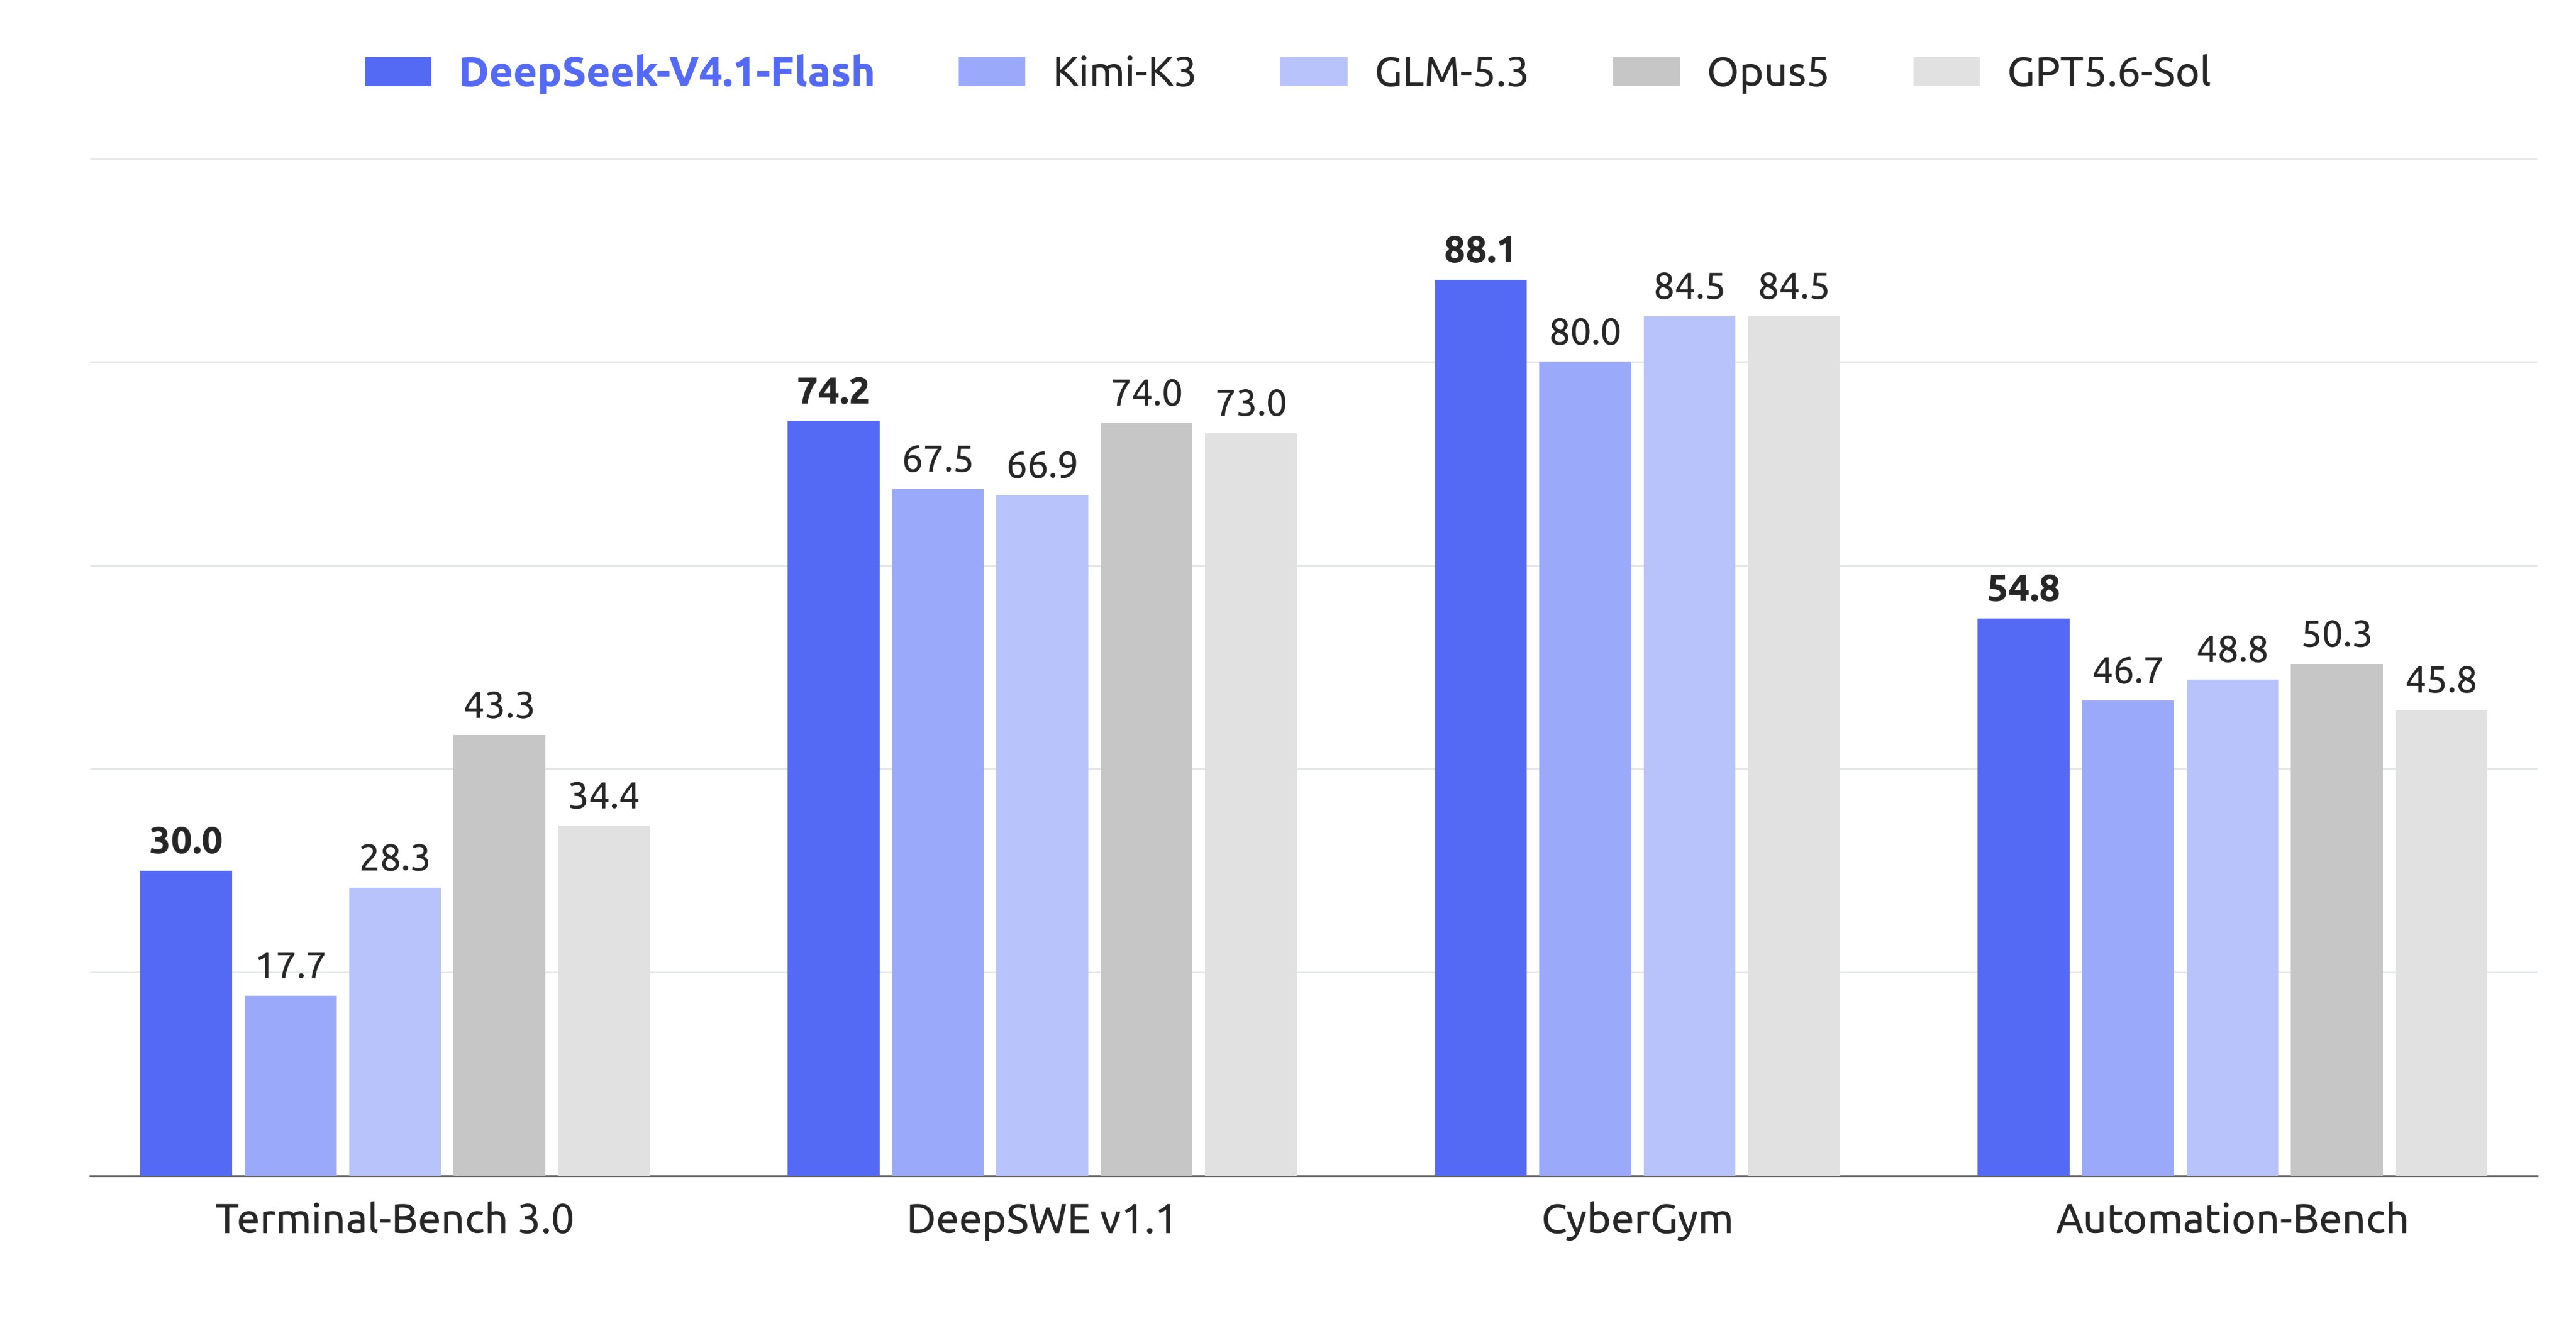
DeepSeek-V4.1-Flash on Fireworks: Astra-level DeepSWE at 1/15th the cost

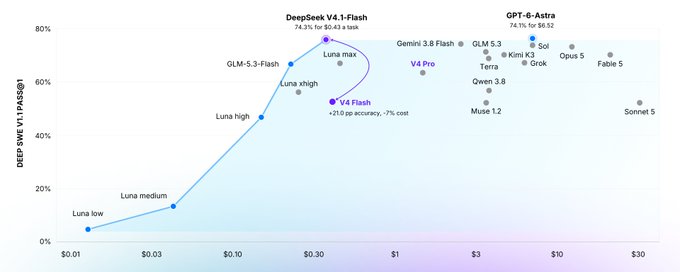
Fireworks 发布的 DeepSeek-V4.1-Flash 在 DeepSWE 基准测试中以每任务 $0.43 的成本达到 GPT-6 Astra 级别的编码准确率,价格仅为 1/15。该模型采用 552B MoE 编码器-解码器分离激活架构(输入 8B、输出 16B 活跃参数),配合 KV Cache 优化(HBM 占用降至 1/4),在 Terminal-Bench 2.1 上以 12x 更低成本逼近 Astra。但在 HLE 学术推理上落后于 Astra;oracle 路由测试显示两模型组合可超越 Astra 单模型表现,凸显多模型路由系统的价值。

技术 › LLM Fireworks 2026-09-169.1 KB 24.1K 200 75

显存就这么多,怎么把字吐得更快?——从 MoE、KV Cache 到 DFlash 的本地部署全景拆解

文章从一张16GB显卡出发,系统拆解大模型本地部署的显存与速度权衡。首先澄清运行显存不只包含模型权重,还有KV Cache、运行时工作区和草稿模型开销;解释MoE与量化对容量和计算的不同影响,区分总参数与激活参数;分析CPU/GPU卸载的代价;介绍KV Cache与混合注意力如何影响上下文长度;区分Prefill与Decode两个阶段的速度特征;最后详解投机解码、MTP与DFlash/DFlash2的加速原理及实测收益。强调各优化手段需配合使用,预算刚好装满并不代表能稳定运行。

技术 › LLM huangserva 2026-09-1423.1 KB 9.9K 69 84

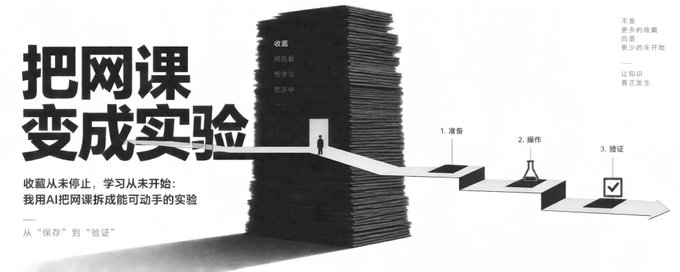
我用Ling-3.0-flash-VL把学习视频拆成能可动手的实验

作者利用蚂蚁百灵多模态大模型Ling-3.0-flash-VL开发了Course Rebuilder,将B站收藏的《从函数到Transformer架构》网课重构为10个可交互实验,涵盖从函数拟合到Transformer组装的完整因果链。模型能精准解析视频片段,提取讲解概念、画面证据和先修知识,并给出交互改造建议,推理延迟仅1.1-1.3秒。该工具将被动听课转化为主动探索,支持跳转原片和AI助教答疑,显著提升学习吸收率。

技术 › LLM 睿奇Re7 2026-09-119.0 KB 16.6K 102 73

DeepSeek-V4.1-Flash 发布:更聪明、更快速、更高效

DeepSeek 发布新架构家族中最小的模型 V4.1-Flash,具备原生视觉理解能力。该模型采用非对称因果编码器-解码器架构,552B 参数 MoE,仅 8B 激活参数用于输入、16B 用于输出,通过新预训练方法和大规模 RL 后训练,性能超越旗舰模型 V4-Pro。KV 缓存仅需前代 1/4 的 HBM 和 1/8 的 SSD 存储,大幅降低 Agent 成本。模型已上线 DeepSeek API,支持多模态,API 价格下调,非高峰时段费率为峰值的 50%。官方将与开源社区合作推进推理支持,模型已在 HuggingFace 开放。

技术 › LLM DeepSeek (@deepseek_ai) 2026-09-103.3 KB 73

DeepSeek V4.1 Flash 正式发布,全面超越自家 Pro 模型?实战测评

DeepSeek 发布 552B 参数的开源 MoE 模型 V4.1 Flash,原生支持多模态视觉理解,官方称其性能、费用、速度全面超越 V4 Pro,V4 Pro 将于 9 月 14 日下线。作者通过两个实战项目(3D 程序化城市生成器、基于 draw.io 的 AI 智能绘图工具)横向对比 V4.1 Flash、V4 Pro 和 GLM-5.3-Flash。结果显示 V4.1 Flash 完成度最高,输出速度达 287 TOK/s,成本仅约 5 元/项目,多模态能力让前端开发质量明显提升,最终结论是梁神回归,可重新推荐为日常 AI 编程模型。

技术 › LLM 程序员鱼皮 2026-09-1012.8 KB 4.8K 12 73

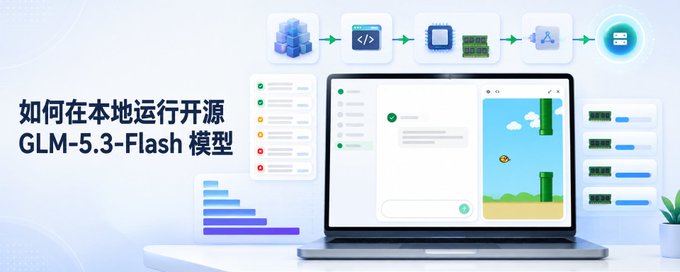
如何在本地运行开源 GLM-5.3-Flash 模型

本文详细介绍在个人机器上本地部署 GLM-5.3-Flash(320B 总参数、激活约 18B 的 MoE 模型)的完整流程。作者首先澄清显存误区:即使激活参数小,仍需容纳完整权重,最小 GGUF 量化文件即超 93GB,100GB 内存是起跑线。教程提供两条路线:一是使用图形化的 Unsloth Desktop 快速上手;二是编译支持 glm5next 架构的 llama.cpp 专用分支,并启动兼容 OpenAI 接口的本地服务。文章还涵盖硬件需求估算、量化版本选择建议(UD-IQ2_XXS 适合 128GB 机器)、常见报错排查与性能优化要点。

技术 › LLM 极客开源 2026-09-0711.5 KB 3.9K 13 86

读懂大模型|别怕,大模型的本质就是一个函数

文章以 DeepSeek 开源的 V4-Flash-Vision-Exp 为例,深入浅出地讲解大模型的本质:一个做矩阵运算的超大函数。作者介绍了模型文件结构(权重分片、config.json、tokenizer.json),并详细解析输入输出处理流程,包括文本分词、BPE 算法、Embedding、MoE 混合专家架构、概率性输出与自回归生成机制。此外还逐项解读了核心参数,如词表大小、网络层数、注意力头数、YaRN 长上下文伸缩、视觉模块和 FP8/FP4 低精度量化等,帮助读者建立对大模型原理的整体认知。

技术 › LLM ray 2026-09-0413.7 KB 2.9K 7 74

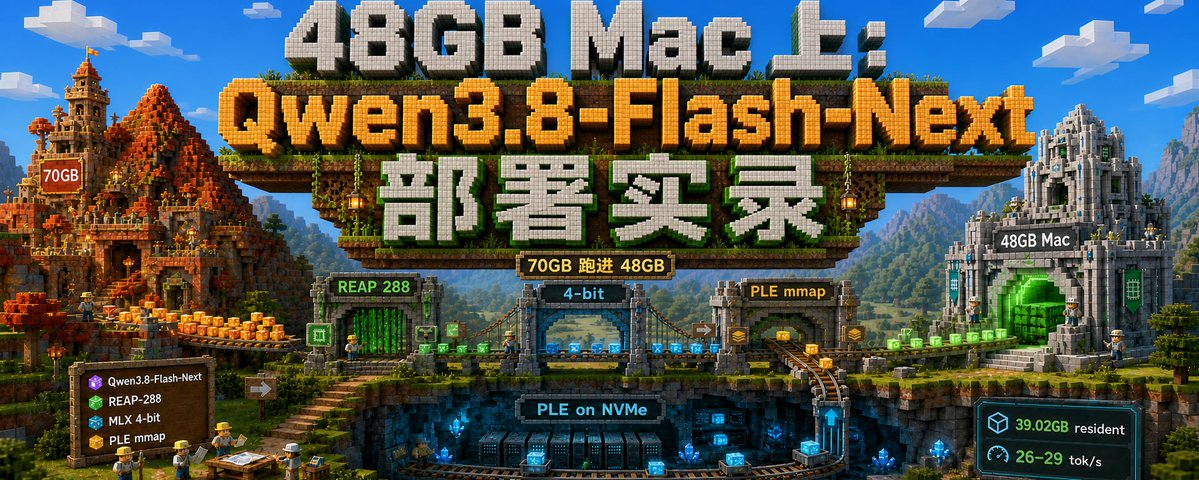
70GB 模型跑在 48GB Mac 上:Qwen3.8-Flash-Next 部署实录

作者在 48GB 内存 MacBook Pro(M4 Pro)上成功部署了磁盘体积约 70GB 的 Qwen3.8-Flash-Next REAP-288 MLX 4-bit 模型。文章解析了能跑起来的三重原因:REAP 将每层 512 个专家裁剪至 288 个、主模型与 PLE n-gram 表均做 4-bit 量化、以及 51B 参数的 PLE 表通过 mmap 留在 NVMe 按需流式读取。实际驻留约 39GB,首次加载约 10.14 秒,decode 稳定在 26~29 token/s,prefill 峰值约 149 token/s。实测最大上下文仅 8,217 tokens(配置声明 262K),建议日常使用 7,680 tokens。文章还记录了 Metal 内存上限调整、oMLX 服务启动及完整基准测试过程。

技术 › LLM 雪瑜 2026-09-0110.7 KB 55.5K 175 90

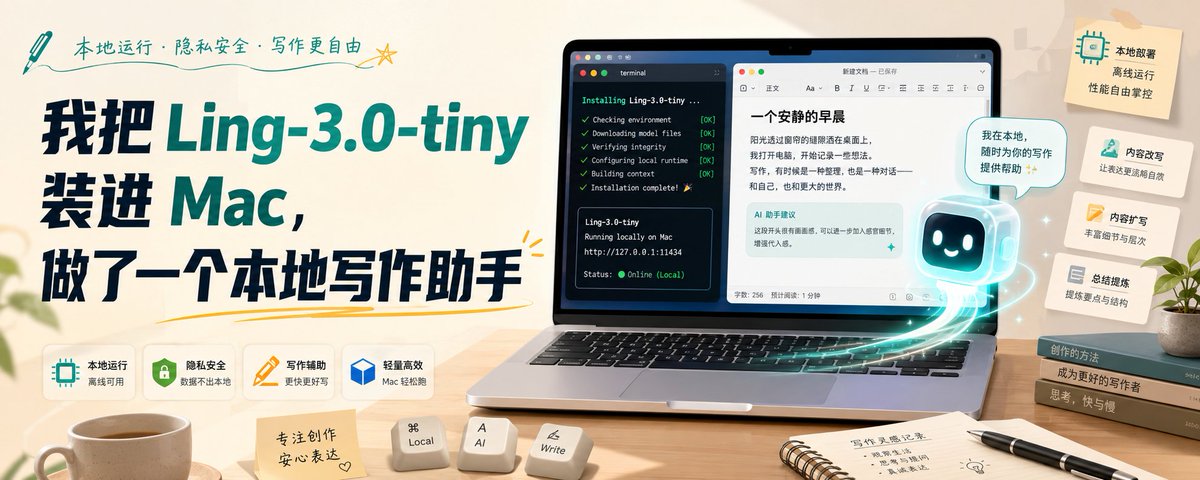
我把 Ling-3.0-tiny 装进 Mac,做了一个本地写作助手

作者记录了在 Mac mini(M4、16GB)上部署蚂蚁开源的混合推理小模型 Ling-3.0-tiny 的完整过程:编译 Ollama 实验分支、下载 FP8/BF16 权重并导入,验证服务后搭建了一个只调用本机接口的写作页面。随后用一篇真实口述稿进行四轮写作测试——提炼结构、检查问题、局部改写和反馈调整,发现模型擅长结构整理与问题扫描,但润色时 AI 味重,难以还原作者口吻。文章还对比了 FP8 与 BF16 的输入输出速度,并总结了端口冲突、上下文设置和接口安全等部署注意事项,最后给出将其用于写作第一轮辅助的定位。

技术 › LLM 小墨同学 2026-08-3017.2 KB 28.5K 40 82

如何用Ling-3.0-tiny搭配DeepSeek Harness本地处理敏感数据?新手友好教程

文章介绍了一套面向新手的本地化AI方案:用DeepSeek Harness作为Agent框架读取文件、运行工具,配合本机运行的Ling-3.0-tiny(7.9B总参数、约1.3B激活参数的MoE模型)完成推理,适用于律师事务所、财税、医疗等需要处理敏感文档的场景。作者在2021款MacBook Pro(M1 Pro、32GB内存)上实测,生成速度约40 tokens/s,可胜任合同摘要、结构化抽取、多文档时间线整理和交叉核对等任务。文章详细说明了部署步骤,并通过虚构法律文书的摘要、JSON抽取、时间线生成三项测试验证效果,同时提醒本地运行不等于自动合规,专业文书仍需人工复核。

技术 › Agent WY 2026-08-299.3 KB 11.3K 52 80

GLM 5.3: Scaling with Post-training, Intuitively Explained

文章解析了 GLM-5.3 如何在不重新预训练的情况下,仅通过规模化后训练(RL)超越 GLM-5.2,印证了 Sutton 的苦涩教训。重点包括:一是面向真实专家工作的环境设计,用研究代理生成长时程任务,配合严格的验证器三重检查防止 reward hacking;二是沿用 GLM-5.2 的 MoE 架构(744B 总参、~40B 激活),采用 MLA 压缩 KV cache、DeepSeek 稀疏注意力降低长上下文成本、MTP 投机解码平均每次接受约 4.5 个 token,以及 IndexShare 在相邻层共享索引实现 2.9 倍 FLOPs 节省;三是 SAO 算法与 slime 基础设施,将低廉的 rollout 转化为稳定的大规模后训练。

技术 › LLM Alex Ker 2026-08-2913.2 KB 103.9K 410 77