H3 Prompt 实战:如何让 AI 真正理解“人物、镜头、动作、音乐”
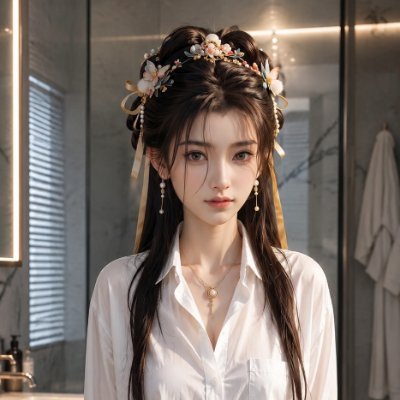
文章分享了使用 H3 视频生成模型进行高分辨率俯拍镜头控制的提示词实战经验。核心技巧包括:将机位约束放在提示词最顶部以提高识别权重;明确接受俯拍导致的人脸透视变形,打破模型内置的人脸美化逻辑;直接禁止模型为美化人脸而将机位拉回平视的行为;使用 NO、DO NOT 等强否定短句代替解释性长文;保留原图的人物身份与服装参考,但完全替换原图机位、背景与灯光。作者强调,有效的提示词不是解释“什么是俯拍”,而是硬性禁止模型在高分辨率模式下自动修正机位和人脸透视的内部行为。