Wiki 知识库

全部文档 / 标签: H3

8 篇
清除

H3提示词分享:运镜、人物锁定、道具连续性与分段导演

本文系统分享了使用 H3 制作真人音乐 MV 的导演设计与提示词方法论。作者强调先设计作品再写提示词,从作品定位、参考图权限边界、人物与道具的锁定规则入手,提出外观锁定与状态锁定分离的原则。运镜方面倡导动作与镜头同步、用物理关系代替角度数字、每段设定主运镜;道具需按全曲时间线管理拔刀、收刀等状态;音乐时间轴是 MV 骨架,动作应写成时间中的过程。同时讲解了分段生成的独立提示词组织结构、背景连续性管理和生成前的自检方法,帮助解决提示词冗长反而导致结果不稳定的问题。
技术 › 短剧 AI Dance Paradise 2026-10-2423.1 KB 5.6K 26 88

H3 完整提示词:单图 + Audio 1|开场绕身运镜 × 卡点闪屏姿势蒙太奇

本文分享一套基于 H3 模型的 AI 视频生成提示词,仅以一张参考图和一段音频为输入,生成竖屏 9:16 的音乐 MV 风格视频。以原神角色刻晴的小香风穿搭为例,详细设计了约 10 秒的动作节奏:开场绕身运镜(贴合身体的横移、肩部扫过、甩镜与旋转展示),随后进入卡点姿势蒙太奇阶段,配合约 129 BPM 的音乐节拍,通过全身舞蹈姿势、比心、特写、闪屏切换等手法,实现节奏感强、剪辑感明显的短视频效果。提示词强调保持人物身份与服装一致性、动作自然流畅、以音频为节奏权威等核心规则。

技术 › AI视频 AI Dance Paradise 2026-10-2113.9 KB 17K 57 69

H3 古风舞蹈创作方法论:从动作动链到导演级运镜

作者系统总结了一套基于 H3 模型的 AI 古风舞蹈视频制作方法论。核心原则是先建立舞蹈再建立镜头:从作品意图、音乐分析、编舞设计出发,构建持续层、动链层、微动作层三层舞蹈结构,写出包含受力、路径、重心、惯性等完整物理过程的动作链,并按音乐节拍与动作密度对齐。镜头设计强调真实摄影机几何而非抽象角度术语,每次运镜都需有目的。文章还涵盖参考图视觉权限界定、跨段连续性检查、负面约束的正向替代方案、提示词语法结构与交付前的导演级自检流程,旨在建立可复用的模块化 AI 舞蹈创作系统。

技术 › AI视频 AI Dance Paradise 2026-10-2117.9 KB 36K 40 90

H3 AI 换装游戏视频提示词教程:从反复失败到稳定出片

文章分享了用 H3 视频生成模型稳定产出 10 秒 AI 换装游戏视频的完整教程。核心方法包括:具体描写每套服装实现图片与文字双重锚定、将核心规则前置并声明最高优先级、用 identical 替代 match 封死重新解读空间、固定相机保证 UI 与人物同时可见、选择 10 秒时长避免模型跑偏。作者提供了完整的提示词模板和 5 步使用流程,并总结了 8 个失败经验教训,如避免提示词过长、不要套用学术模板等,帮助读者快速稳定出片。

技术 › 提示词工程 AI Dance Paradise 2026-09-0613.2 KB 67K 164 91

如何使用 Dance Director Skill,生成丰富的 H3 舞蹈视频

本文介绍了 Dance Director Skill 的使用方法,该 Skill 能将 AI 从简单的 Prompt 生成器转变为'舞蹈导演'。用户只需提供一张角色图片,AI 即可按照导演规则自动设计编舞、镜头运动和 H3 I2VA 提示词,无需手动编写复杂的舞蹈指令。Skill 支持无音乐时共同创作音乐与编舞,也支持有音乐时根据节拍进行音乐驱动编舞。文章附带了完整的 Skill 内容,涵盖角色设定、动作短语思维、参考图视觉权威、编舞匹配角色、身体力学、动作幅度、音乐性等编舞设计原则。

技术 › Skill AI Dance Paradise 2026-09-0318.9 KB 111.4K 427 83

H3 Prompt 实战:如何让 AI 真正理解“人物、镜头、动作、音乐”

文章分享了使用 H3 视频生成模型进行高分辨率俯拍镜头控制的提示词实战经验。核心技巧包括:将机位约束放在提示词最顶部以提高识别权重;明确接受俯拍导致的人脸透视变形,打破模型内置的人脸美化逻辑;直接禁止模型为美化人脸而将机位拉回平视的行为;使用 NO、DO NOT 等强否定短句代替解释性长文;保留原图的人物身份与服装参考,但完全替换原图机位、背景与灯光。作者强调,有效的提示词不是解释“什么是俯拍”,而是硬性禁止模型在高分辨率模式下自动修正机位和人脸透视的内部行为。

技术 › LLM AI Dance Paradise 2026-08-2923.6 KB 316.4K 302 80

如何评价MiniMax最近发布的H3模型?

本文从AI视频创作者视角评测MiniMax发布的H3模型。通过36条实测视频,分析了H3在镜头叙事、微表情、音画同步及2K重拍等方面的表现。文章解读了H3的技术架构,指出其具备“执行导演”机制和音画同生能力,且成本低廉。最后探讨了开源对行业竞争及创作者的影响。

技术 › LLM Derek Wen|德里克文 2026-08-049.5 KB 3.8K 7

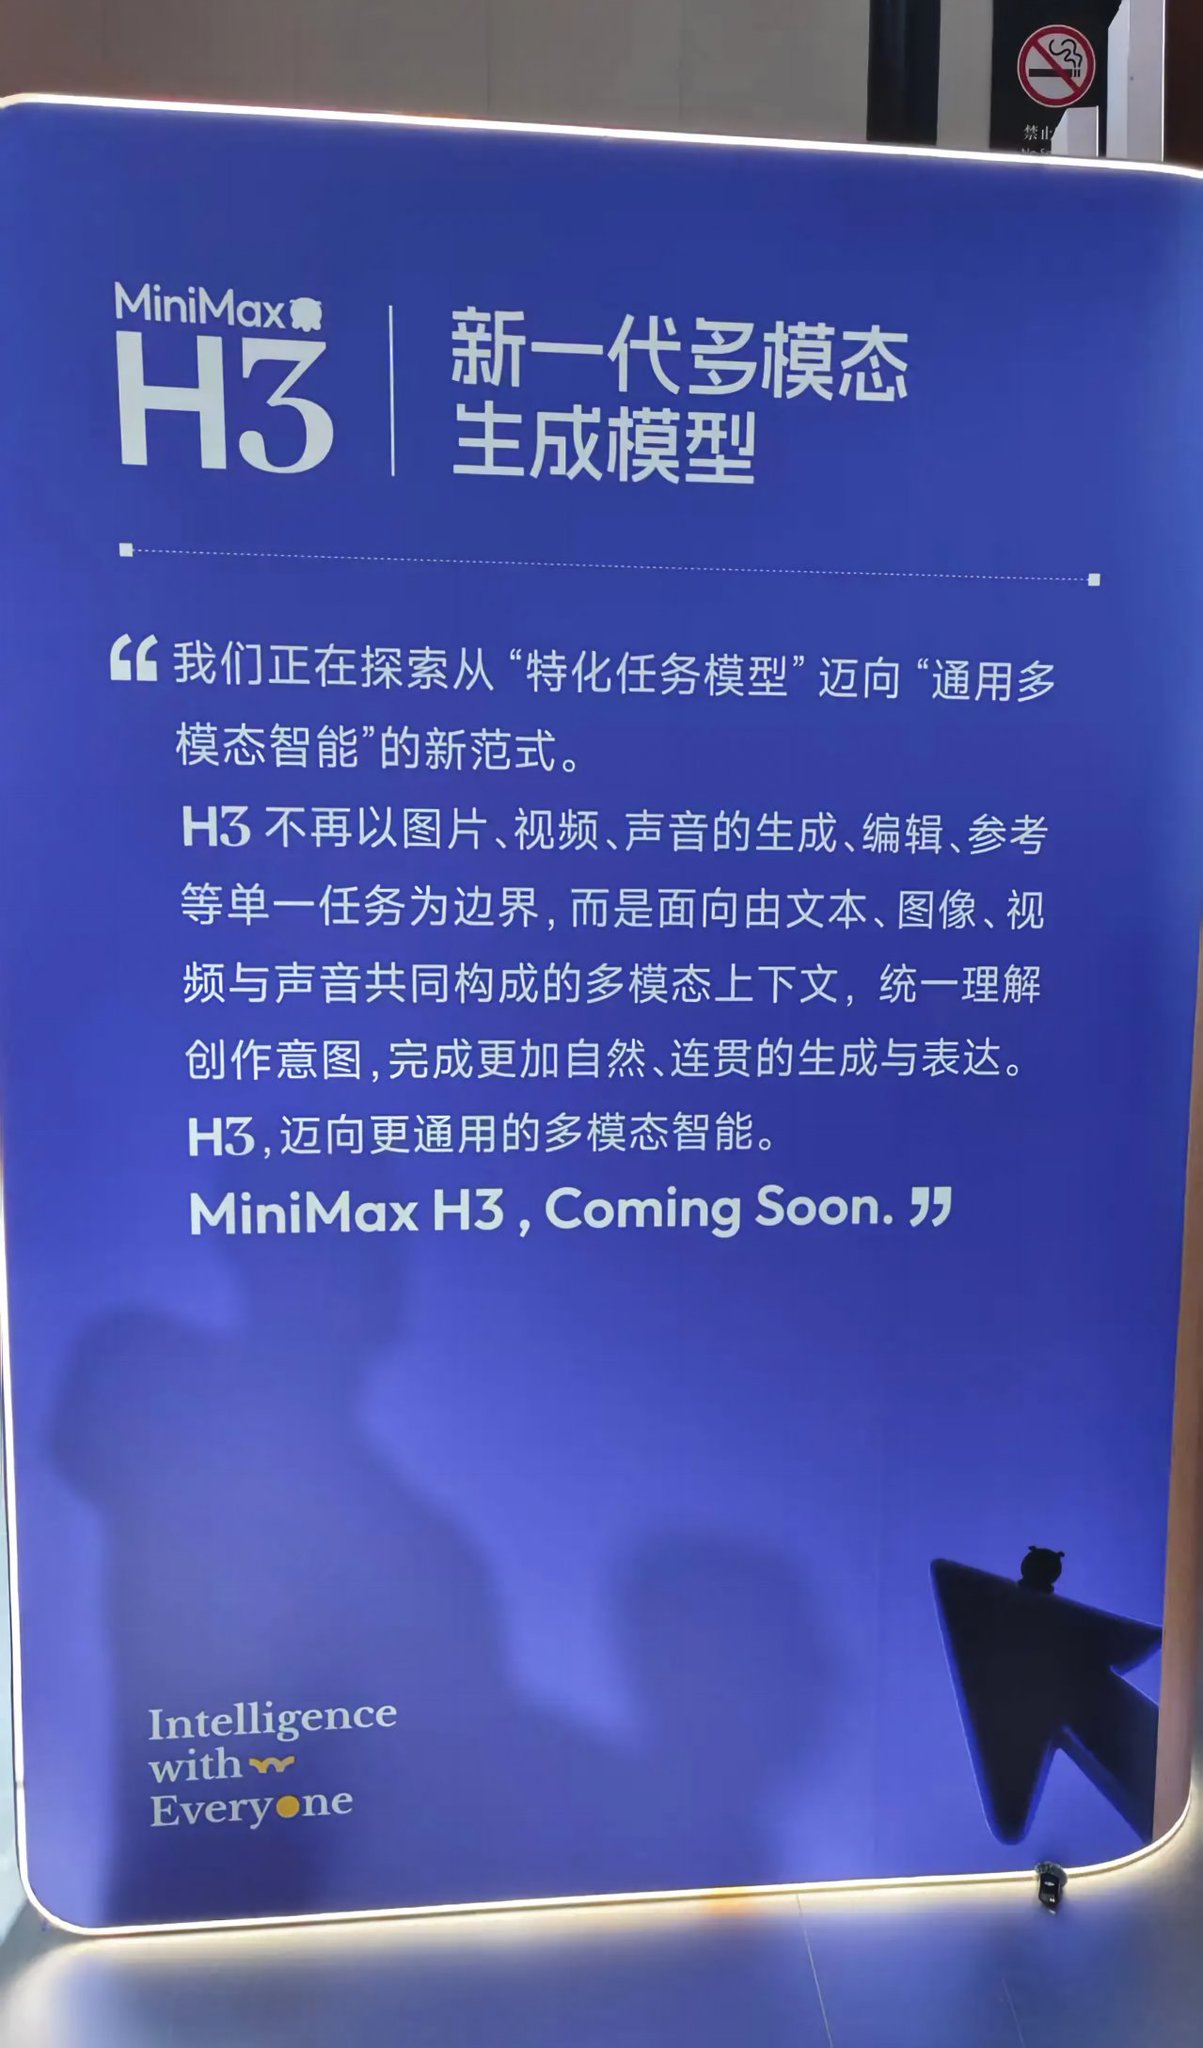
MiniMax H3: 打破任务与模态界限的开源多模态生成模型

MiniMax 发布通用多模态生成模型 H3,支持文本、图像、视频和音频的统一理解与生成。H3 可生成原生立体声的 2K 分辨率视频,具备优异的指令遵循和精准编辑能力,并计划近期开源模型权重,旨在打破任务边界,降低成本,加速商业化内容创作。

技术 › LLM MiniMax 2026-07-3111.6 KB 469.2K 2.5K