Wiki 知识库

全部文档 / 标签: KV-cache

2 篇
清除

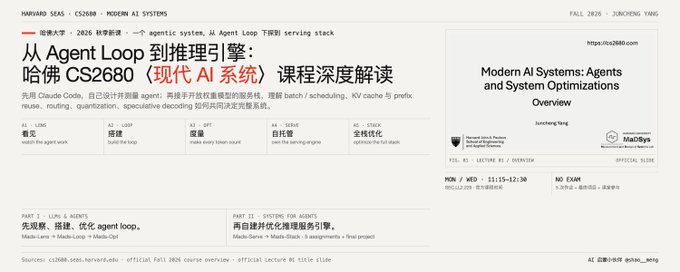
从 Agent Loop 到推理引擎:哈佛 CS2680 现代AI系统课程深度解读

本文深度解读哈佛大学2026年秋季Juncheng Yang开设的研究生课程CS2680《现代AI系统:Agent与系统优化》。课程以一条主线贯穿agent循环到LLM推理serving栈,通过五个递进式作业逐层解剖系统:A1为Claude Code构建Web前端,A2从零实现最小agent harness,A3在黑盒API下优化成本与延迟并引入排行榜竞争,A4自建推理引擎部署开源模型,A5全栈profile驱动的假设验证优化。文章还分析了课程的AI使用政策(强制披露、Claude Code session存档审计)、leaderboard评分机制、严格的20% A档曲线以及体现系统研究方法论的期末项目设计,展示了'AI时代如何教系统课'的完整答案。

技术 › LLM meng shao 2026-10-1233.1 KB 10.8K 103 85

清华团队开源C2C技术:大模型缓存直连,绕过文字交流

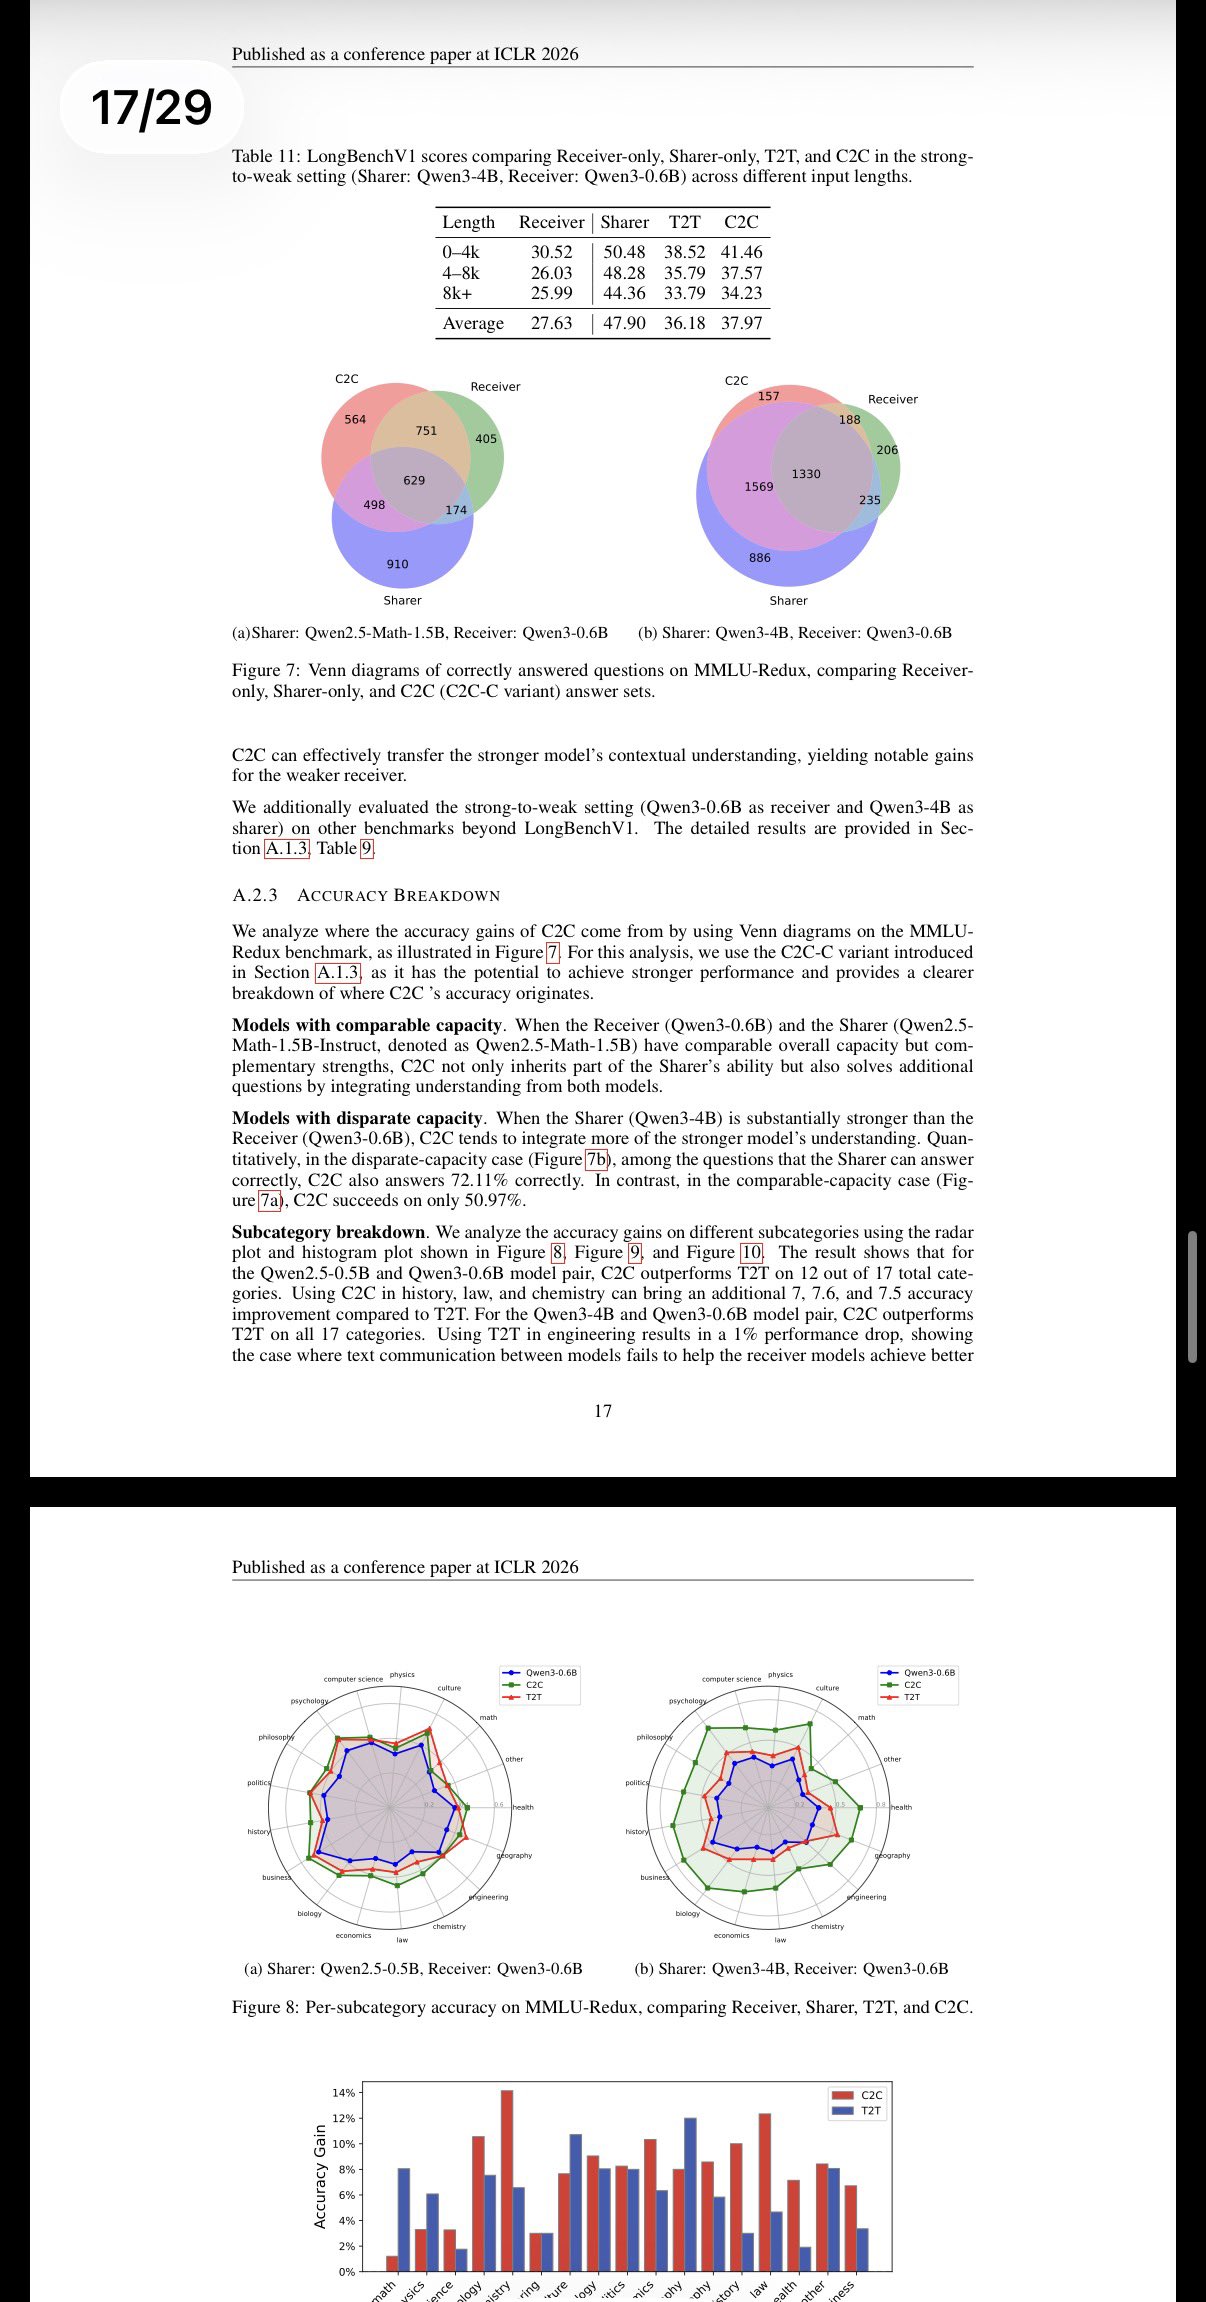
清华大学联合无问芯穹、上海AI Lab发布C2C(Cache-to-Cache)技术论文(ICLR 2026),彻底改变多智能体系统通信范式。传统Multi-Agent协作中模型需将高维思考压缩为文本逐字解码再传递,造成延迟、语义丢失和高昂Token成本。C2C通过轻量级神经网络(Neural Fuser)将模型A的KV-Cache直接旋转对齐后融进模型B的KV-Cache,并引入可学习门控机制动态决定各层吸收外部缓存的程度。实测推理速度提升2.0-2.5倍,问答准确率较单模型提升14.2%,比文本通信的Agent团队高5%。代码与论文均已开源,未来有望大幅降低Mixture-of-Agents调用成本。

技术 › LLM AYi (@AYi_AInotes) 2026-09-194.3 KB 71
